22  Atención y transformers

Serie Deep Learning · del perceptrón a los transformers.

Construiremos la atención escalada y compararemos un encoder mínimo con una LSTM en IMDB. El objetivo es entender máscaras, posiciones, pérdidas y coste, sin convertir un ensayo pequeño en una conclusión sobre todos los transformers.

22.1 1. Entorno y reproducibilidad

Se requieren PyTorch, NumPy, pandas, Matplotlib y scikit-learn. La ejecución registrada usa CPU. Se conservan los experimentos y presupuestos docentes; los cambios necesarios de escala y protocolo se declaran, sin atribuir sus efectos sólo al framework.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

22.1.1 Contrato del comparador recurrente

La forma es (N,L,F) con batch_first=True; los estados siguen (capas,N,H). Cada ventana comienza con estado cero y no hereda información de otras muestras. En LSTM se distinguen estado oculto y celda. La salida final es lineal para regresión o un logit para BCE estable; sigmoid sólo interviene en inferencia binaria.

Inicializamos matrices de entrada con Xavier y cada bloque recurrente ortogonalmente; en LSTM fijamos el sesgo efectivo de olvido en +1, sin duplicarlo entre los dos sesgos de PyTorch. El conteo de parámetros incluye ambos. La variante GRU de PyTorch aplica la puerta reset en una posición algebraica distinta de algunas implementaciones: no se promete equivalencia de pesos o resultados con otra biblioteca.

Adam usa tasa 0,001. Guardamos y restauramos el mínimo de pérdida de validación, calculando train/val en eval al cierre de cada época. La prueba queda fuera del ajuste. Los artefactos se recargan y contrastan sobre validación. Son archivos de inferencia, no una sesión completa de optimización reanudable. Una semilla y un presupuesto corto no permiten declarar superioridad universal.

Código
class Secuencia(nn.Module):
    def __init__(self,tipo='RNN',entrada=1,ocultas=16,vocabulario=None):
        super().__init__();self.tipo=tipo
        self.embedding=nn.Embedding(vocabulario,32) if vocabulario is not None else None
        self.recurrente={'RNN':nn.RNN,'LSTM':nn.LSTM,'GRU':nn.GRU}[tipo](32 if self.embedding is not None else entrada,ocultas,batch_first=True)
        self.salida=nn.Linear(ocultas,1)
        # Inicialización explícita: Xavier de entrada; ortogonal por puerta recurrente.
        puertas={'RNN':1,'LSTM':4,'GRU':3}[tipo]
        for nombre,p in self.recurrente.named_parameters():
            if 'weight_ih' in nombre: nn.init.xavier_uniform_(p)
            elif 'weight_hh' in nombre:
                for bloque in p.chunk(puertas,0): nn.init.orthogonal_(bloque)
            else: nn.init.zeros_(p)
        # Orden LSTM i,f,g,o. Sólo un sesgo de olvido recibe +1; no sumarlo dos veces.
        if tipo=='LSTM':
            with torch.no_grad(): self.recurrente.bias_ih_l0[ocultas:2*ocultas].fill_(1)
        nn.init.xavier_uniform_(self.salida.weight);nn.init.zeros_(self.salida.bias)
        if self.embedding is not None: nn.init.uniform_(self.embedding.weight,-.05,.05)
    def forward(self,x):
        if self.embedding is not None: x=self.embedding(x.long())
        _,estado=self.recurrente(x)
        h=estado[0] if self.tipo=='LSTM' else estado
        return self.salida(h[-1]).squeeze(-1)

def datos(x,y,tokens=False):
    return TensorDataset(torch.as_tensor(x,dtype=torch.long if tokens else torch.float32),torch.as_tensor(y,dtype=torch.float32))

@torch.inference_mode()
def medir(m,ds,tipo='regresion'):
    m.eval();zs=[];ys=[];suma=0.
    for x,y in cargador(ds,64):
        x=x.to(DEVICE);y=y.to(DEVICE);z=m(x)
        loss=F.mse_loss(z,y,reduction='sum') if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y,reduction='sum')
        suma+=loss.item();zs.append(z.cpu().numpy());ys.append(y.cpu().numpy())
    z=np.concatenate(zs);y=np.concatenate(ys);assert np.isfinite(z).all()
    r={'loss':suma/len(ds),'z':z,'y':y}
    if tipo!='regresion':
        p=torch.from_numpy(z).sigmoid().numpy();r.update(p=p,acc=float(((p>=.5)==y).mean()))
    return r

def ajustar(m,tr,va,nombre,epocas,lote=32,tipo='regresion',lr=.001,clip=None):
    m=m.to(DEVICE);opt=torch.optim.Adam(m.parameters(),lr=lr);dl=cargador(tr,lote,True)
    h=[];mejor=float('inf');inicio=time.perf_counter()
    for ep in range(1,epocas+1):
        m.train();normas=[];recortados=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE);opt.zero_grad(set_to_none=True);z=m(x)
            loss=F.mse_loss(z,y) if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y)
            if not torch.isfinite(loss): raise FloatingPointError(nombre+' pérdida no finita')
            loss.backward()
            if clip is not None:
                norma=float(nn.utils.clip_grad_norm_(m.parameters(),clip));normas.append(norma);recortados+=norma>clip
            opt.step()
        a=medir(m,tr,tipo);b=medir(m,va,tipo)
        fila={'epoca':ep,'loss_train':a['loss'],'loss_val':b['loss']}
        if tipo!='regresion':fila.update(acc_train=a['acc'],acc_val=b['acc'])
        if clip is not None:fila.update(norma_media=float(np.mean(normas)),fraccion_clipping=recortados/len(dl))
        h.append(fila)
        if b['loss']<mejor:mejor=b['loss'];pesos=copy.deepcopy(m.state_dict());mejor_ep=ep
        print(nombre,ep,'val',round(b['loss'],5),flush=True)
    m.load_state_dict(pesos);m.eval();h=pd.DataFrame(h);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    r={'modelo':nombre,'mejor_epoca':mejor_ep,'min_val_loss':mejor,'parametros':parametros(m),'epocas':epocas,'segundos':time.perf_counter()-inicio}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(r,indent=2),encoding='utf-8')
    return m,h,r

def graficar(h,r,titulo,binario=False):
    fig,axes=plt.subplots(1,2 if binario else 1,figsize=(11,3.5) if binario else (7,3.5));axes=np.atleast_1d(axes)
    axes[0].plot(h.epoca,h.loss_train,label='Train (eval)');axes[0].plot(h.epoca,h.loss_val,label='Val')
    axes[0].axvline(r['mejor_epoca'],ls='--',color='.4');axes[0].set(xlabel='Época',ylabel='BCE' if binario else 'MSE');axes[0].legend()
    if binario:
        axes[1].plot(h.epoca,h.acc_train,label='Train (eval)');axes[1].plot(h.epoca,h.acc_val,label='Val');axes[1].set(xlabel='Época',ylabel='Exactitud');axes[1].legend()
    fig.suptitle(titulo);fig.tight_layout();plt.show()
    display(Markdown(f"**Checkpoint:** época {r['mejor_epoca']} de {len(h)}, mínimo de validación {r['min_val_loss']:.5f}. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización."))

def salvar(m,fabrica,nombre,contrato,ds):
    p=ARTEFACTOS/f'{nombre}.pt';torch.save({'state_dict':{k:v.detach().cpu().clone() for k,v in m.state_dict().items()},'contrato':contrato},p)
    nuevo=fabrica().to(DEVICE);nuevo.load_state_dict(torch.load(p,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval();m.eval()
    x=ds.tensors[0][:32].to(DEVICE)
    with torch.inference_mode():torch.testing.assert_close(m(x),nuevo(x),rtol=1e-5,atol=1e-6)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(dict(contrato,sha256=hashlib.sha256(p.read_bytes()).hexdigest()),indent=2),encoding='utf-8')
    print('Recarga comprobada:',nombre)

def ventana(serie,L):
    indices=np.arange(L,len(serie));x=np.array([serie[i-L:i] for i in indices],dtype=np.float32)[...,None]
    return x,np.asarray(serie[L:],dtype=np.float32),indices

def resumen_regresion(real,pred,base,nombre):
    filas=[]
    for etiqueta,p in [(nombre,pred),('Persistencia',base)]:
        filas.append({'modelo':etiqueta,'rmse':float(np.sqrt(np.mean((real-p)**2))),'mae':float(np.mean(np.abs(real-p))),'sesgo_real_menos_pred':float(np.mean(real-p))})
    t=pd.DataFrame(filas);display(t)
    display(Markdown(f"**Comparación observada:** RMSE de {nombre} {t.iloc[0].rmse:.4f}, persistencia {t.iloc[1].rmse:.4f}. Diferencia persistencia−red = {t.iloc[1].rmse-t.iloc[0].rmse:+.4f}. El signo describe este ensayo; no establece que una red recurrente sea necesaria para esta serie."))
    return t

22.1.2 Buscar información: consulta, clave y valor

Una secuencia puede contener una pista útil lejos de la posición que queremos representar. La recurrencia debe transportarla a través de estados intermedios. La atención construye otra operación: cada posición formula una consulta, compara esa consulta con claves y mezcla los valores según compatibilidad. No hay una búsqueda simbólica de palabras ni una explicación humana incorporada en esas coordenadas.

Si las representaciones forman \(X\in\mathbb R^{L\times d}\), aprendemos \(Q=XW_Q\), \(K=XW_K\) y \(V=XW_V\). Consulta y clave deben tener la misma dimensión \(d_k\) para calcular un producto; el valor puede tener otra dimensión. Clave y valor proceden del mismo token, pero cumplen papeles distintos: una decide cuánto se consulta y el otro qué se aporta a la mezcla.

En autoatención, las tres proyecciones proceden de la misma secuencia. En atención cruzada, las consultas proceden de una secuencia y las claves/valores de otra, como un decoder que consulta el encoder. La fórmula de mezcla es la misma; cambia qué información se pone a disposición. Esta distinción también aparece al conectar visión y lenguaje en el capítulo 23.

No hace falta atribuir a cada coordenada el significado de «sujeto» o «tema» para entender el cálculo. Primero seguiremos una cuenta con matrices conocidas; después distinguiremos ese ejemplo fabricado de las proyecciones aprendidas del clasificador.

22.2 2. Atención escalada a mano

\[A=\operatorname{softmax}(QK^\top/\sqrt{d_k}),\qquad O=AV.\]

Cada fila distribuye masa entre claves válidas. Ser paralelo a una clave no garantiza una selección exclusiva: otros scores también compiten en softmax. Claves iguales reciben el mismo peso con la misma consulta. El factor raíz reduce la escala de los productos para ciertas distribuciones de entradas; no garantiza evitar saturación con cualquier magnitud.

def atencion(q,k,v):
    s=q@k.T/np.sqrt(np.float32(q.shape[-1]));a=np.exp(s-s.max(1,keepdims=True));a/=a.sum(1,keepdims=True);return a@v,a
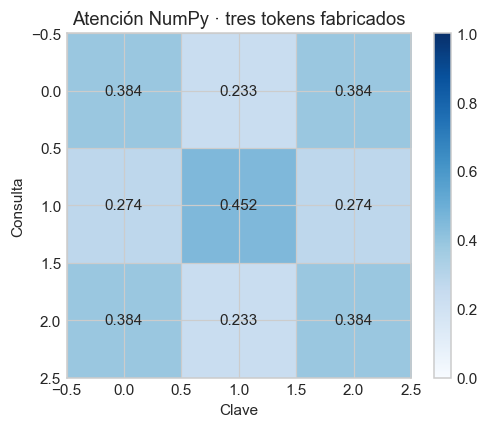
Q=np.array([[1,0,0,0],[0,1,0,0],[1,0,0,0]],dtype=np.float32);K=Q.copy();V=np.array([[10,0],[0,7],[1,1]],dtype=np.float32)
salida,pesos=atencion(Q,K,V);np.testing.assert_allclose(pesos.sum(1),1);np.testing.assert_allclose(pesos[:,0],pesos[:,2])
torch.testing.assert_close(torch.tensor(salida),torch.softmax(torch.tensor(Q@K.T)/2,1)@torch.tensor(V))
print('Pesos:\n',pesos.round(3),'\nSalida:\n',salida.round(3))
fig,ax=plt.subplots(figsize=(5,4));im=ax.imshow(pesos,vmin=0,vmax=1,cmap='Blues');fig.colorbar(im,ax=ax)
for i in range(3):
    for j in range(3):ax.text(j,i,f'{pesos[i,j]:.3f}',ha='center',va='center')
ax.set(xlabel='Clave',ylabel='Consulta',title='Atención NumPy · tres tokens fabricados');fig.tight_layout();plt.show()
entropia=float(-(pesos*np.log(pesos)).sum(1).mean());print('Entropía media del ejemplo:',entropia)
Pesos:
 [[0.384 0.233 0.384]
 [0.274 0.452 0.274]
 [0.384 0.233 0.384]] 
Salida:
 [[4.22  2.013]
 [3.015 3.437]
 [4.22  2.013]]

Entropía media del ejemplo: 1.0723940134048462

22.2.1 Una consulta, tres alternativas y una mezcla verificable

Tomemos \(q=[1,0]\), claves \(k_1=[1,0]\), \(k_2=[0,1]\), \(k_3=[1,1]\) y valores \(v_1=[10,0]\), \(v_2=[0,10]\), \(v_3=[4,4]\). Los productos son \([1,0,1]\); dividir por \(\sqrt2\) y aplicar softmax produce pesos aproximados \([0,401,0,198,0,401]\). La salida queda cerca de \([5,61,3,59]\), no es una copia exacta de un único valor.

Las claves primera y tercera empatan ante esta consulta porque su primera coordenada coincide. La magnitud de sus valores no altera ese empate: V no interviene en los scores. Si la tercera clave es padding, debe salir del denominador; poner su valor a cero conservaría parte de la masa perdida y daría otra respuesta.

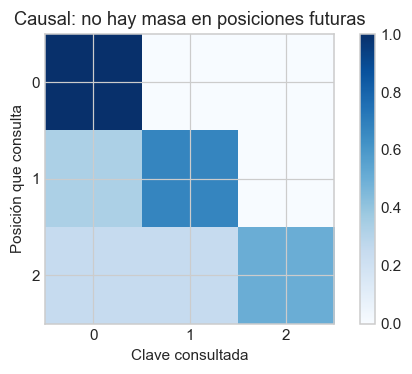
La implementación siguiente resta el máximo antes de exponenciar, comprueba la suma de pesos y contrasta el resultado con PyTorch. La máscara causal de la figura responde una pregunta diferente: qué posiciones anteriores puede consultar cada fila. La representación de una posición no debe depender del futuro si se va a utilizar para predecirlo.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_atencion_cuenta():
    q=np.array([1.,0.]);k=np.array([[1.,0.],[0.,1.],[1.,1.]]);v=np.array([[10.,0.],[0.,10.],[4.,4.]])
    s=q@k.T/np.sqrt(2.);p=np.exp(s-s.max());p/=p.sum();salida=p@v
    pt=torch.softmax(torch.tensor(s,dtype=torch.float64),0);np.testing.assert_allclose(p,pt.numpy(),atol=1e-12)
    p_sin=np.exp(s[:2]-s[:2].max());p_sin/=p_sin.sum()
    display(pd.DataFrame({'clave':['k1','k2','k3'],'score':s,'peso':p,'valor_0':v[:,0],'valor_1':v[:,1]}));print('Salida:',salida,'; sin clave de padding:',p_sin@v[:2])
    assert np.isclose(p.sum(),1) and not np.allclose(salida,p_sin@v[:2])
    X=torch.tensor([[1.,0.],[0.,1.],[1.,1.]],dtype=torch.float64);scores=X@X.T/np.sqrt(2.)
    prohibida=torch.triu(torch.ones(3,3,dtype=torch.bool),diagonal=1);pesos=scores.masked_fill(prohibida,-torch.inf).softmax(-1)
    alterada=X.clone();alterada[2]=torch.tensor([-20.,30.]);otro=(X@alterada.T/np.sqrt(2.)).masked_fill(prohibida,-torch.inf).softmax(-1)@alterada
    torch.testing.assert_close((pesos@X)[0],otro[0]);assert torch.equal(pesos.triu(1),torch.zeros_like(pesos))
    fig,ax=plt.subplots(figsize=(5,3.5));im=ax.imshow(pesos.numpy(),vmin=0,vmax=1,cmap='Blues');ax.set(xlabel='Clave consultada',ylabel='Posición que consulta',xticks=range(3),yticks=range(3),title='Causal: no hay masa en posiciones futuras');fig.colorbar(im,ax=ax);fig.tight_layout();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_atencion_cuenta()
clave score peso valor_0 valor_1
0 k1 0.707107 0.401112 10.0 0.0
1 k2 0.000000 0.197776 0.0 10.0
2 k3 0.707107 0.401112 4.0 4.0
Salida: [5.6155693  3.58220652] ; sin clave de padding: [6.69761549 3.30238451]

22.2.2 Por qué dividir por la raíz de la dimensión

Si las componentes de consulta y clave son independientes, centradas y de varianza uno, su producto escalar suma \(d_k\) términos y tiene varianza \(d_k\). Dividir por \(\sqrt{d_k}\) estabiliza esa escala bajo esos supuestos. Scores muy separados hacen que softmax concentre casi toda la masa y pueden dejar gradientes pequeños para varias alternativas. La escala ayuda a un régimen de entrenamiento; no impone un límite a entradas arbitrariamente grandes.

Softmax opera por fila: cada consulta tiene su propio denominador. Normalizar columnas respondería otra pregunta y no daría la misma mezcla. Con padding, las filas de consulta que también son relleno requieren atención al uso posterior: enmascarar claves no significa borrar automáticamente todas las salidas de consulta. El pooling del clasificador debe excluirlas por su propia máscara.

22.3 3. Dos máscaras con preguntas distintas

La máscara de padding impide usar posiciones de relleno como claves; la causal impide consultar información futura. En nn.MultiheadAttention, key_padding_mask=True significa ignorar esa clave. No copie una convención de booleanos sin revisar la API: distintas funciones usan convenciones diferentes.

El clasificador de reseña completa es bidireccional y no usa máscara causal. BERT y GPT representan contratos diferentes de preentrenamiento y acceso a contexto; este encoder de un bloque no es ninguno de sus checkpoints. El libro especializado de NLP desarrollará esos modelos y tokenizadores; aquí conservamos las bases compartidas.

22.4 4. Datos y control LSTM con padding excluido

Conservamos IMDB, vocabulario 4 000, últimos 80 tokens, 8 000 reseñas de desarrollo (6 800/1 200) y 4 000 de prueba, cuatro épocas y lote 64. El archivo oficial y su permutación se verifican. Se compactan los tokens reales para empaquetar la LSTM: el padding no debe actualizar su estado. Esto mantiene el contrato de máscara del original, a diferencia del experimento de RNN sin máscara del capítulo 19.

cache=Path.home()/'.keras'/'datasets'/'imdb.npz'
if not cache.exists():cache.parent.mkdir(parents=True,exist_ok=True);urllib.request.urlretrieve('https://storage.googleapis.com/tensorflow/tf-keras-datasets/imdb.npz',cache)
assert hashlib.sha256(cache.read_bytes()).hexdigest()=='69664113be75683a8fe16e3ed0ab59fda8886cb3cd7ada244f7d9544e4676b9f'
with np.load(cache,allow_pickle=True) as d: xx=d['x_train'];yy=d['y_train'];xt=d['x_test'];yt=d['y_test']
rng=np.random.RandomState(113);it=np.arange(len(xx));rng.shuffle(it);ie=np.arange(len(xt));rng.shuffle(ie)
def codificar(x,idx,n):
    out=np.zeros((n,80),np.int64)
    for i,j in enumerate(idx[:n]):
        tokens=[1]+[int(w)+3 for w in x[j]];tokens=[w if w<4000 else 2 for w in tokens][-80:];out[i,-len(tokens):]=tokens
    return out
xx=codificar(xx,it,8000);xt=codificar(xt,ie,4000);yy=yy[it[:8000]];yt=yt[ie[:4000]]
tr=datos(xx[:6800],yy[:6800],True);va=datos(xx[6800:],yy[6800:],True);te=datos(xt,yt,True)
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=it[:6800],val=it[6800:8000],test=ie[:4000])
class LSTMEnmascarada(Secuencia):
    def __init__(self):super().__init__('LSTM',ocultas=32,vocabulario=4000)
    def forward(self,ids):
        sec=[fila[fila!=0] for fila in ids];longitudes=torch.tensor([len(s) for s in sec],device='cpu');assert longitudes.min()>0
        compactos=nn.utils.rnn.pad_sequence(sec,batch_first=True,padding_value=0)
        z=self.embedding(compactos);z=nn.utils.rnn.pack_padded_sequence(z,longitudes,batch_first=True,enforce_sorted=False)
        _,(h,_) =self.recurrente(z);return self.salida(h[-1]).squeeze(-1)

22.4.1 Del cálculo de atención al bloque transformer

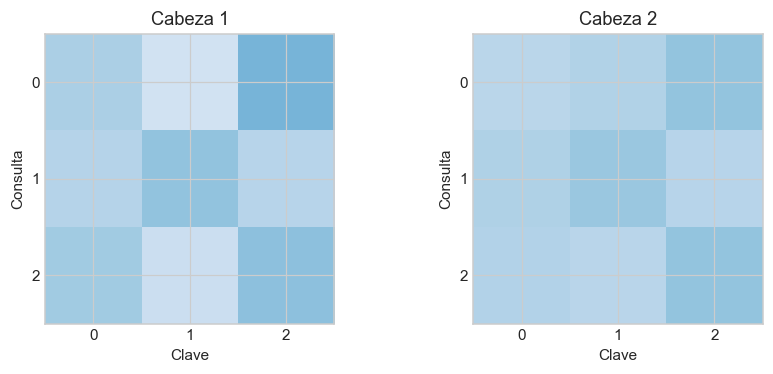
Una sola mezcla no constituye todo el bloque. Con h cabezas, cada una proyecta Q/K/V hacia un subespacio, calcula su atención y produce una salida. Concatenamos esas salidas y aplicamos una proyección \(W_O\); no las promediamos como sustituto general. Con \(d=32\) y cuatro cabezas, cada cabeza usa ocho coordenadas y construye su propio mapa \(L\times L\).

En el diseño de normalización previa que utilizamos:

\[U=X+\operatorname{MHA}(LN_1(X)),\qquad Y=U+\operatorname{FFN}(LN_2(U)).\]

Se omite dropout en esta escritura para distinguir las rutas; el modelo entrenado sí lo utiliza. La conexión residual conserva una ruta de identidad, pero no garantiza convergencia. LayerNorm calcula estadísticas sobre las coordenadas de cada token, no sobre los ejemplos del lote como BatchNorm. Sus escalas y desplazamientos son aprendidos.

La FFN aplica \(W_2\,GELU(W_1x+b_1)+b_2\) a cada token con pesos compartidos entre posiciones. La atención intercambia información entre tokens; la FFN transforma sus coordenadas. El eje temporal no desaparece hasta el pooling o la selección del token que usaremos para predecir.

Etapa Forma de un lote pequeño Qué cambia
Tokens de entrada (2,3,4) Dos secuencias, tres posiciones, cuatro coordenadas
Dos cabezas Dos mapas 3×3 por secuencia Compatibilidad en dos subespacios
Concatenación y proyección (2,3,4) Mezcla las salidas de cabezas
FFN 4→8→4 (2,3,4) Transforma cada posición
Promedio de posiciones válidas (2,4) Construye el resumen para clasificación

El siguiente bloque conserva esas formas y muestra dos mapas, no una media que ocultaría sus diferencias. Son pesos de una inicialización didáctica; no son explicaciones de reseñas aprendidas.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_transformer_bloque():
    x=torch.tensor([[[1.,0.,.5,-.5],[0.,1.,-.5,.5],[.3,.1,.7,-.2]],[[0.,1.,.2,.8],[1.,0.,.8,.2],[.4,.4,.4,.4]]])
    mha=torch.nn.MultiheadAttention(4,2,batch_first=True,dropout=0.)
    ln1=torch.nn.LayerNorm(4);ln2=torch.nn.LayerNorm(4);ff=torch.nn.Sequential(torch.nn.Linear(4,8),torch.nn.GELU(),torch.nn.Linear(8,4))
    xn=ln1(x);a,p=mha(xn,xn,xn,need_weights=True,average_attn_weights=False);u=x+a;y=u+ff(ln2(u))
    assert y.shape==x.shape and p.shape==(2,2,3,3)
    torch.testing.assert_close(p.sum(-1),torch.ones_like(p.sum(-1)))
    print({'entrada':list(x.shape),'mapas_por_cabeza':list(p.shape),'salida_bloque':list(y.shape),'resumen':list(y.mean(1).shape)})
    fig,axes=plt.subplots(1,2,figsize=(8,3.5))
    for i,ax in enumerate(axes):ax.imshow(p[0,i].detach().numpy(),vmin=0,vmax=1,cmap='Blues');ax.set(title=f'Cabeza {i+1}',xlabel='Clave',ylabel='Consulta',xticks=range(3),yticks=range(3))
    fig.tight_layout();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_transformer_bloque()
{'entrada': [2, 3, 4], 'mapas_por_cabeza': [2, 2, 3, 3], 'salida_bloque': [2, 3, 4], 'resumen': [2, 4]}

22.4.2 Posición, orden y coste: decisiones diferentes

Sin información de posición, permutar tokens permuta sus representaciones de autoatención. Si después promediamos, la predicción puede ser invariante a ese orden. Sumar posiciones aprendidas asigna coordenadas distintas a lugares distintos; no enseña por sí solo sintaxis ni garantiza ventaja con pocos datos.

La matriz de compatibilidad tiene \(L^2\) entradas por cabeza. Duplicar longitud cuadruplica ese número, mientras aumenta también el coste de proyecciones y FFN. El coste de un bloque incluye términos del orden de \(Ld^2\), \(L^2d\) y \(Ldd_{ff}\); contar parámetros no captura toda la dependencia con longitud. Las implementaciones pueden evitar materializar algunos intermedios, por lo que la cuenta conceptual no es un medidor completo de memoria.

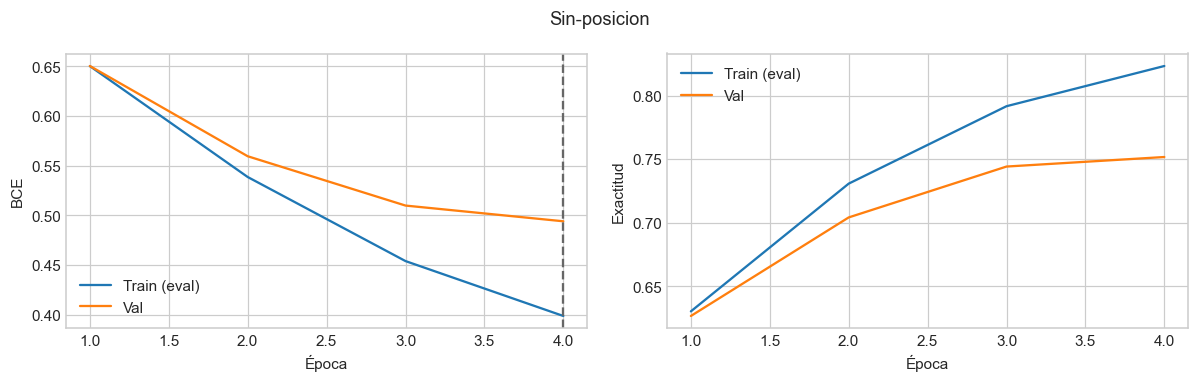
En el informe IMDB, LSTM supera al encoder con este presupuesto y la ablación sin posición también supera a la versión con posición. El resultado no autoriza concluir que «el orden no importa». Sí impide afirmar que nuestra tabla de posición produjo una ganancia demostrada. Para el siguiente estudio habría que prefijar una pregunta —longitud, regularización o presupuesto— y contrastarla en desarrollo, manteniendo el resto del recorrido.

22.5 5. Encoder mínimo y ablación de posición

Usamos embedding 32, posiciones aprendidas hasta longitud 80, cuatro heads de ocho dimensiones, normalización previa, rutas residuales y FFN 32→64→32 con GELU. Dropout 0,2 actúa en las rutas residuales. El promedio final excluye padding.

La variante sin posición conserva los mismos pesos iniciales, máscaras, dropout, lotes y épocas; sólo omite sumar esa tabla. Se mantiene la tabla asignada para que el estado inicial sea idéntico, aunque sus parámetros no reciban gradiente en la ablación. Su conteo asignado no equivale a parámetros efectivamente utilizados.

Se protege también el caso de entrada totalmente vacía para evitar softmax sobre claves todas enmascaradas: el pooling devuelve vector cero y la salida depende del sesgo. En datos reales la política de rechazar una reseña vacía debe definirse en el sistema de entrada.

class Encoder(nn.Module):
    def __init__(self,posicion=True):
        super().__init__();self.usar_posicion=posicion;self.tokens=nn.Embedding(4000,32,padding_idx=0);self.pos=nn.Embedding(80,32)
        self.norm1=nn.LayerNorm(32);self.att=nn.MultiheadAttention(32,4,dropout=0,batch_first=True);self.norm2=nn.LayerNorm(32)
        self.ff=nn.Sequential(nn.Linear(32,64),nn.GELU(),nn.Linear(64,32));self.drop=nn.Dropout(.2);self.salida=nn.Linear(32,1)
    def forward(self,ids):
        assert ids.shape[1]<=80
        mascara=ids!=0;segura=mascara.clone();segura[~mascara.any(1),0]=True
        x=self.tokens(ids)
        if self.usar_posicion:x=x+self.pos(torch.arange(ids.shape[1],device=ids.device))[None]
        z=self.norm1(x);a,_=self.att(z,z,z,key_padding_mask=~segura,need_weights=False)
        x=x+self.drop(a);x=x+self.drop(self.ff(self.norm2(x)))
        x=(x*mascara[...,None]).sum(1)/mascara.sum(1,keepdim=True).clamp_min(1)
        return self.salida(x).squeeze(-1)
semilla();enc=Encoder(True);ab=copy.deepcopy(enc);ab.usar_posicion=False
assert all(torch.equal(v,ab.state_dict()[k]) for k,v in enc.state_dict().items())
semilla();lstm=LSTMEnmascarada();modelos={'LSTM':lstm,'Encoder':enc,'Sin-posicion':ab};hist={};res={}
for nombre,m in modelos.items():
    semilla();m,h,r=ajustar(m,tr,va,nombre,4,lote=64,tipo='binaria');modelos[nombre]=m;hist[nombre]=h;res[nombre]=r;graficar(h,r,nombre,True)
ganador=min(res,key=lambda k:res[k]['min_val_loss']);print('Seleccionado por validación:',ganador)
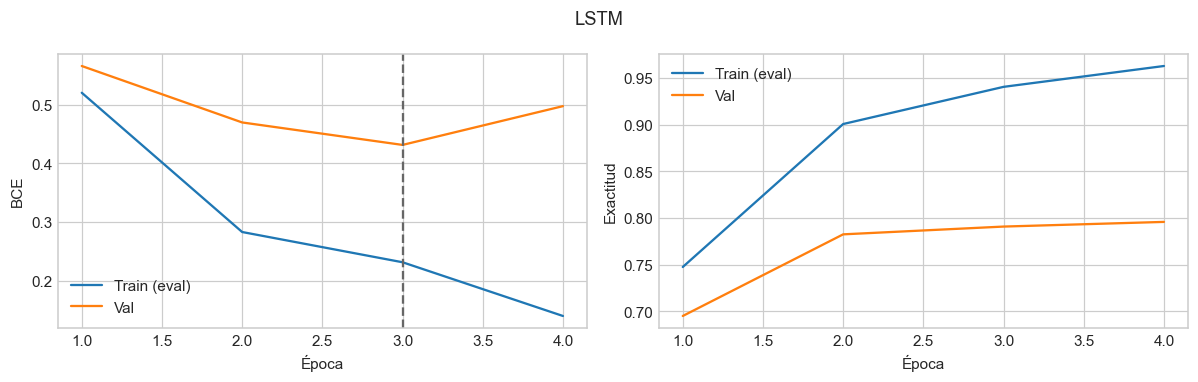
LSTM 1 val 0.56593
LSTM 2 val 0.46969
LSTM 3 val 0.43137
LSTM 4 val 0.49749

Checkpoint: época 3 de 4, mínimo de validación 0.43137. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

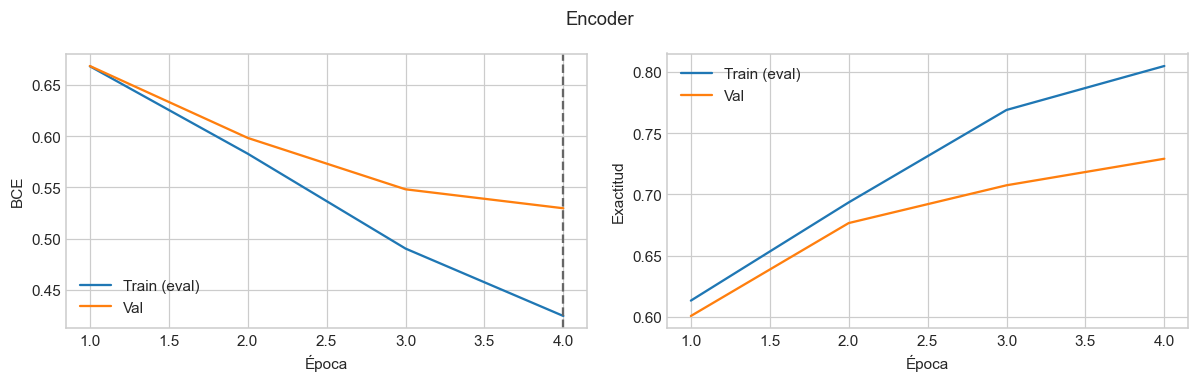
Encoder 1 val 0.66863
Encoder 2 val 0.59834
Encoder 3 val 0.5481
Encoder 4 val 0.52957

Checkpoint: época 4 de 4, mínimo de validación 0.52957. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

Sin-posicion 1 val 0.65028
Sin-posicion 2 val 0.5594
Sin-posicion 3 val 0.50973
Sin-posicion 4 val 0.4939

Checkpoint: época 4 de 4, mínimo de validación 0.49390. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

Seleccionado por validación: LSTM

22.6 6. Comprobar contratos de máscara y orden

Añadir padding a la derecha conserva las posiciones de tokens reales y debe mantener el resultado del encoder. Añadirlo a la izquierda cambia sus posiciones absolutas: no se exige esa invariancia cuando hay posiciones aprendidas. Sin posición, la atención más pooling es invariante a permutar tokens reales, dentro de precisión numérica y en eval.

Estas comprobaciones validan propiedades de este diseño. No demuestran que una reseña sea una bolsa de palabras semánticamente ni que el orden nunca importe para la tarea.

ejemplo=torch.tensor([[1,4,7,2]],device=DEVICE);relleno=F.pad(ejemplo,(0,5));permutado=ejemplo[:,[2,0,3,1]]
for m in modelos.values():m.eval()
with torch.inference_mode():
    torch.testing.assert_close(enc(ejemplo),enc(relleno),rtol=1e-5,atol=1e-5)
    torch.testing.assert_close(lstm(ejemplo),lstm(relleno),rtol=1e-5,atol=1e-5)
    torch.testing.assert_close(ab(ejemplo),ab(permutado),rtol=1e-5,atol=1e-5)
    assert torch.isfinite(enc(torch.zeros((2,8),dtype=torch.long,device=DEVICE))).all()
print('Padding derecho, invariancia sin posición y entrada vacía: comprobados')
Padding derecho, invariancia sin posición y entrada vacía: comprobados

22.7 7. Informe reservado, confianza y desacuerdo

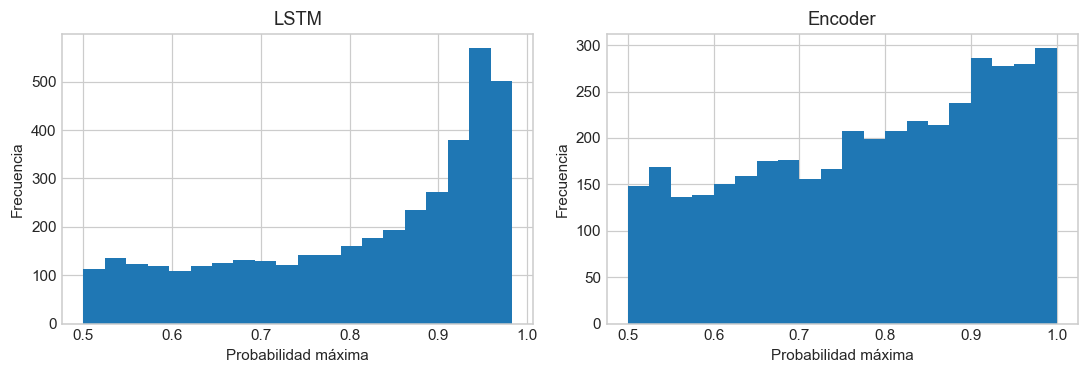
Abrimos prueba después de fijar checkpoints y configuración por validación. Informamos las tres configuraciones prefijadas; no cambiamos el ganador por su test. El histograma de confianza no es calibración: para eso habría que contrastar probabilidad y frecuencia de aciertos como en el capítulo 16.

Los desacuerdos localizan casos de inspección. No prueban que una arquitectura haya usado contexto global ni identifican por sí solos qué tokens causaron el error.

resultados={};filas=[]
for nombre,m in modelos.items():
    rr=medir(m,te,'binaria');resultados[nombre]=rr
    filas.append({**res[nombre],'bce_test':rr['loss'],'acc_test':rr['acc'],'macro_f1':f1_score(yt,(rr['p']>=.5).astype(int),average='macro'),'segundos_epoca':res[nombre]['segundos']/4})
    print(nombre);print(classification_report(yt,(rr['p']>=.5).astype(int),labels=[0,1],target_names=['Negativa','Positiva'],digits=4,zero_division=0))
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'comparacion.csv',index=False)
fig,axes=plt.subplots(1,2,figsize=(10,3.5))
for ax,nombre in zip(axes,['LSTM','Encoder']):
    p=resultados[nombre]['p'];ax.hist(np.maximum(p,1-p),bins=20);ax.set(title=nombre,xlabel='Probabilidad máxima',ylabel='Frecuencia')
fig.tight_layout();plt.show()
a=resultados['LSTM']['p']>=.5;b=resultados['Encoder']['p']>=.5;disc=a!=b
print('Desacuerdos:',int(disc.sum()),'· aciertos LSTM en desacuerdos:',float((a[disc]==yt[disc]).mean()) if disc.any() else None)
salvar(modelos[ganador],LSTMEnmascarada if ganador=='LSTM' else lambda:Encoder(ganador=='Encoder'),'atencion-seleccionada',{'arquitectura':ganador,'vocabulario':4000,'longitud_maxima':80,'recorte':'ultimos 80 tokens','padding':0,'salida':'logit binario','seleccion':'min BCE val'},va)
(ARTEFACTOS/'verificaciones.json').write_text(json.dumps({'pesos_iniciales_ablacion_iguales':True,'padding_derecho_invariante':True,'sin_posicion_permutacion_invariante':True,'entrada_vacia_finita':True,'ganador_validacion':ganador}),encoding='utf-8')
LSTM
              precision    recall  f1-score   support

    Negativa     0.8012    0.8194    0.8102      2071
    Positiva     0.8013    0.7818    0.7914      1929

    accuracy                         0.8013      4000
   macro avg     0.8013    0.8006    0.8008      4000
weighted avg     0.8013    0.8013    0.8011      4000

Encoder
              precision    recall  f1-score   support

    Negativa     0.7890    0.6789    0.7298      2071
    Positiva     0.7002    0.8051    0.7490      1929

    accuracy                         0.7398      4000
   macro avg     0.7446    0.7420    0.7394      4000
weighted avg     0.7462    0.7398    0.7391      4000

Sin-posicion
              precision    recall  f1-score   support

    Negativa     0.8009    0.7262    0.7617      2071
    Positiva     0.7328    0.8061    0.7677      1929

    accuracy                         0.7648      4000
   macro avg     0.7668    0.7662    0.7647      4000
weighted avg     0.7680    0.7648    0.7646      4000
modelo mejor_epoca min_val_loss parametros epocas segundos bce_test acc_test macro_f1 segundos_epoca
0 LSTM 3 0.431374 136481 4 140.298951 0.432805 0.80125 0.800805 35.074738
1 Encoder 4 0.529565 139137 4 65.220508 0.520647 0.73975 0.739398 16.305127
2 Sin-posicion 4 0.493902 139137 4 62.708535 0.493701 0.76475 0.764712 15.677134

Desacuerdos: 850 · aciertos LSTM en desacuerdos: 0.6447058823529411
Recarga comprobada: atencion-seleccionada
183

22.7.1 Lectura de la ejecución registrada

Se conserva atención NumPy, LSTM, encoder pre-norm con cuatro heads, posiciones aprendidas y ablación sin posición, cuatro épocas e IMDB histórico. Se comprueban suma de pesos, padding derecho invariante, permutación sin posición, caso vacío finito y pesos iniciales comunes en la ablación. La selección por BCE val eligió LSTM: 80,125 % de exactitud de test frente a 73,975 % del encoder y 76,475 % sin posición. La ablación no respalda una ventaja automática de las posiciones en este presupuesto. No se presenta un bloque pequeño como BERT/GPT ni confianza como calibración. Recarga verificada.

Resultados CPU del 15 de octubre de 2026; vuelva a contrastar la lectura si cambia datos, versión o semilla.

22.8 8. Decisiones y continuidad

El mínimo de validación, F1, tamaño y coste describen este presupuesto. No se refuta una arquitectura moderna con cuatro épocas de un encoder pequeño. La entropía del ejemplo NumPy describe concentración de pesos fabricados; no se presenta como explicación de una reseña del modelo entrenado.

Un checkpoint de lenguaje externo exige su tokenizador, vocabulario, longitudes y normalización originales. Congelar o ajustar pesos requiere un protocolo nuevo; este capítulo no descarga BERT/GPT ni valida moderación real. Continúa con Embeddings, Secuencia a secuencia y ViT.

22.9 Referencias