27  GAN

Serie Deep Learning · del perceptrón a los transformers.

Una GAN entrena dos funciones con objetivos acoplados: generar muestras y distinguirlas de las reales. Conservamos dos laboratorios pequeños, MNIST y bolsos Fashion-MNIST, para estudiar pasos de optimización, pérdidas, muestras fijas y diversidad. Bajar la pérdida del generador no equivale a mejorar imágenes.

27.1 1. Entorno y evaluación prefijada

Usamos PyTorch, NumPy, pandas, Matplotlib y scikit-learn. Se leen las cachés oficiales de MNIST/Fashion sin importar TensorFlow. La ejecución registrada es CPU.

MNIST conserva 8 000 imágenes, doce épocas, latente 64 y lote 128. Bolsos conserva 4 000 imágenes y ocho épocas. La arquitectura MLP es deliberadamente pequeña. Se guardan las épocas finales prefijadas, no el mínimo de una pérdida supervisada ni el generador que se vea mejor tras consultar prueba. Las muestras de ruido fijas se definen antes de entrenar.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

27.2 2. Dos pérdidas y dos rutas de gradiente

El discriminador produce logits. Usamos \(L_D=BCE(D(x),1)+BCE(D(G(z)),0)\) y el objetivo no saturante \(L_G=BCE(D(G(z)),1)\), donde BCE se implementa de forma estable sobre logits. El generador termina en sigmoid para producir intensidades [0,1]. No se aplica sigmoid otra vez antes de BCE del discriminador.

En el paso D, la imagen falsa se separa del grafo de G. En el paso G, D conserva el gradiente respecto de su entrada, pero sus parámetros no se actualizan. Se comprueban ambos aislamientos en el primer lote. Se usan optimizadores distintos Adam 0,0002, con sus valores beta por defecto; no se presenta como un ajuste exhaustivo de GAN.

En un equilibrio ideal con D=0,5, estas normalizaciones darían \(L_D=2\log2\) y \(L_G=\log2\). Encontrar números parecidos no demuestra equilibrio ni calidad de muestras.

LAT=64
def crear_g():return nn.Sequential(nn.Linear(64,128),nn.ReLU(),nn.Linear(128,784),nn.Sigmoid())
def crear_d():return nn.Sequential(nn.Linear(784,128),nn.ReLU(),nn.Linear(128,1))
def pesos(m):return {k:v.detach().cpu().clone() for k,v in m.state_dict().items()}
def iguales(m,estado):return all(torch.equal(v.detach().cpu(),estado[k]) for k,v in m.state_dict().items())
z_fijo=torch.from_numpy(np.random.default_rng(100).normal(size=(16,64)).astype(np.float32)).to(DEVICE)
@torch.inference_mode()
def generar(g,z):g.eval();return g(z).cpu().numpy().reshape(-1,28,28)
def grilla(imagenes,titulo,columnas=4):
    filas=int(np.ceil(len(imagenes)/columnas));fig,axes=plt.subplots(filas,columnas,figsize=(2*columnas,2*filas))
    for ax,im in zip(np.atleast_1d(axes).flat,imagenes):ax.imshow(im,cmap='gray',vmin=0,vmax=1);ax.axis('off')
    for ax in list(np.atleast_1d(axes).flat)[len(imagenes):]:ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
def entrenar_gan(x,nombre,epocas):
    semilla();g=inicializar(crear_g());d=inicializar(crear_d());og=torch.optim.Adam(g.parameters(),lr=2e-4);od=torch.optim.Adam(d.parameters(),lr=2e-4)
    dl=DataLoader(TensorDataset(torch.from_numpy(x)),batch_size=128,shuffle=True,generator=torch.Generator().manual_seed(SEED))
    hist=[];capturas={0:generar(g,z_fijo)};inicio=time.perf_counter();comprobado=False
    for ep in range(1,epocas+1):
        g.train();d.train();sd=sg=0.;n=0
        for (reales,) in dl:
            reales=reales.to(DEVICE);b=len(reales);od.zero_grad(set_to_none=True)
            estado_g=pesos(g) if not comprobado else None
            with torch.no_grad():falsos=g(torch.randn(b,LAT,device=DEVICE))
            ld=F.binary_cross_entropy_with_logits(d(reales),torch.ones(b,1,device=DEVICE))+F.binary_cross_entropy_with_logits(d(falsos),torch.zeros(b,1,device=DEVICE))
            if not torch.isfinite(ld):raise FloatingPointError('D no finito')
            ld.backward();od.step()
            if not comprobado:assert iguales(g,estado_g)
            estado_d=pesos(d) if not comprobado else None
            for p in d.parameters():p.requires_grad=False
            og.zero_grad(set_to_none=True);falsos=g(torch.randn(b,LAT,device=DEVICE));lg=F.binary_cross_entropy_with_logits(d(falsos),torch.ones(b,1,device=DEVICE))
            if not torch.isfinite(lg):raise FloatingPointError('G no finito')
            lg.backward();og.step()
            if not comprobado:assert iguales(d,estado_d);comprobado=True
            for p in d.parameters():p.requires_grad=True
            sd+=float(ld.detach())*b;sg+=float(lg.detach())*b;n+=b
        hist.append({'epoca':ep,'loss_D':sd/n,'loss_G':sg/n})
        if ep in [1,4,8,12]:capturas[ep]=generar(g,z_fijo)
        print(nombre,ep,'D/G',round(sd/n,3),round(sg/n,3),flush=True)
    h=pd.DataFrame(hist);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps({'epocas_prefijadas':epocas,'segundos':time.perf_counter()-inicio,'parametros_G':parametros(g),'parametros_D':parametros(d),'aislamiento_actualizaciones_comprobado':comprobado}),encoding='utf-8')
    np.savez_compressed(ARTEFACTOS/f'{nombre}-muestras-fijas.npz',z=z_fijo.cpu().numpy(),**{f'epoca_{ep}':im for ep,im in capturas.items()})
    return g,d,h,capturas

27.2.1 Qué aprende cada participante

El discriminador recibe muestras reales y generadas, no parejas de imágenes que deban parecerse píxel a píxel. Su salida estima si una observación procede del conjunto real bajo el muestreo del experimento. El generador transforma ruido en ejemplos y recibe información a través de la derivada del discriminador respecto de su entrada.

Con igual probabilidad de presentar reales y generadas, el discriminador óptimo ideal satisface \(D^*(x)=p_{datos}(x)/(p_{datos}(x)+p_G(x))\). Si ambas distribuciones coinciden, vale un medio donde tienen soporte. Esto describe un equilibrio ideal, no una regla de parada fiable para redes finitas: un discriminador incapaz también puede responder un medio.

Supongamos dos modos igualmente frecuentes en los datos, mientras el generador produce proporciones 0.9 y 0.1. En el primer modo, \(D^*=0.5/1.4\approx0.357\); en el segundo, \(0.5/0.6\approx0.833\). Ambos modos podrían contener imágenes nítidas. El problema seguiría siendo de cobertura: el generador visita demasiado el primero.

27.2.2 Por qué importa la forma de la pérdida

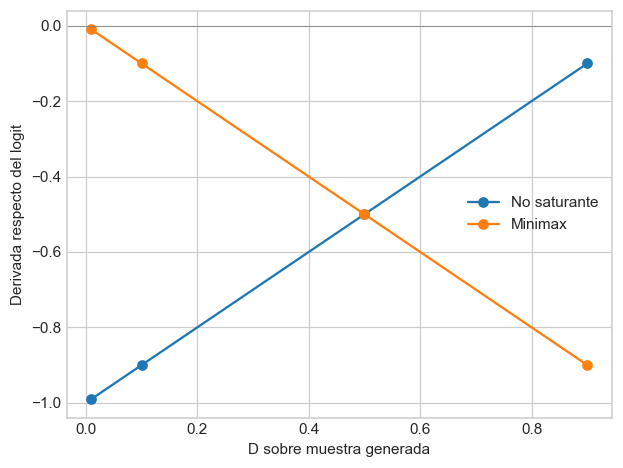
Si el logit del discriminador para una imagen generada es \(s\) y \(p=\sigma(s)\), la pérdida no saturante del generador es \(-\log p\) y su derivada respecto de \(s\) es \(p-1\). La variante minimax usa \(\log(1-p)\) y da derivada \(-p\). Cuando el discriminador rechaza con fuerza una imagen, la segunda señal es pequeña. Estas son derivadas respecto del logit; el gradiente final también depende del Jacobiano del discriminador y del generador.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_gan_senal():
    p=torch.tensor([.01,.1,.5,.9],dtype=torch.float64)
    s=torch.logit(p).requires_grad_()
    no_sat=torch.nn.functional.softplus(-s)
    minimax=-torch.nn.functional.softplus(s)
    g1=torch.autograd.grad(no_sat.sum(),s,retain_graph=True)[0]
    g2=torch.autograd.grad(minimax.sum(),s)[0]
    assert torch.allclose(g1,p-1) and torch.allclose(g2,-p)
    display(pd.DataFrame({'D(fake)':p,'grad no saturante':g1,'grad minimax':g2}))
    pdatos=np.array([.5,.5]);pg=np.array([.9,.1]);d=pdatos/(pdatos+pg)
    display(pd.DataFrame({'modo':['A','B'],'proporcion real':pdatos,'proporcion generada':pg,'D optimo':d}))
    plt.plot(p,g1,'o-',label='No saturante');plt.plot(p,g2,'o-',label='Minimax');plt.axhline(0,color='gray',lw=.5)
    plt.xlabel('D sobre muestra generada');plt.ylabel('Derivada respecto del logit');plt.legend();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_gan_senal()
D(fake) grad no saturante grad minimax
0 0.01 -0.99 -0.01
1 0.10 -0.90 -0.10
2 0.50 -0.50 -0.50
3 0.90 -0.10 -0.90
modo proporcion real proporcion generada D optimo
0 A 0.5 0.9 0.357143
1 B 0.5 0.1 0.833333

En el paso de D se desconecta la imagen generada para evitar actualizar G con el objetivo del adversario. En el paso de G se mantiene la ruta de la imagen a través de D; congelar los parámetros de D no debe desconectar su entrada. Los gradientes acumulados se limpian antes del paso correspondiente. Una pérdida que cambia no demuestra que esta separación esté bien implementada: se comprueba qué parámetros reciben gradientes y cuáles cambian.

27.2.3 Nitidez, cobertura y una métrica que puede engañar

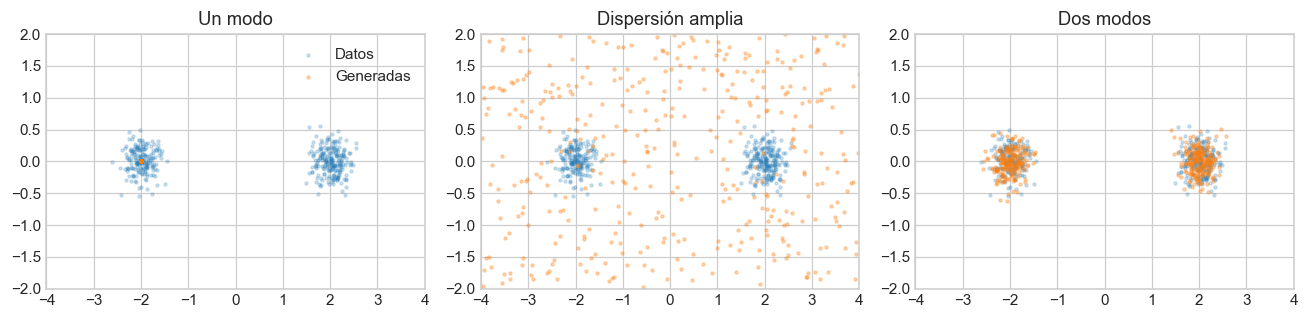
Construyamos dos grupos conocidos. Un generador que repite el centro izquierdo tiene excelente proximidad a un modo y cobertura incompleta. Otro que dispersa puntos por toda la región puede visitar ambos lados, pero generar muchos ejemplos alejados de los datos. Como conocemos los centros, podemos medir ambas cosas por separado. En imágenes reales no disponemos de esta geometría exacta; la demostración explica el límite de los indicadores, no propone trasladar su umbral.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_gan_cobertura():
    rng=np.random.default_rng(27)
    centros=np.array([[-2.,0.],[2.,0.]])
    real=centros[rng.integers(0,2,400)]+rng.normal(0,.2,(400,2))
    casos={'Un modo':np.repeat(centros[:1],400,axis=0),'Dispersión amplia':rng.uniform([-4,-2],[4,2],(400,2)),'Dos modos':centros[rng.integers(0,2,400)]+rng.normal(0,.2,(400,2))}
    fig,axes=plt.subplots(1,3,figsize=(12,3));filas=[]
    for ax,(nombre,muestras) in zip(axes,casos.items()):
        dist=np.linalg.norm(muestras[:,None,:]-centros[None,:,:],axis=2)
        cerca=(dist<.6).any(axis=1).mean()
        cobertura=(dist.min(axis=0)<.6).mean()
        filas.append([nombre,cerca,cobertura,muestras.std(axis=0).mean()])
        ax.scatter(real[:,0],real[:,1],s=4,alpha=.2,label='Datos');ax.scatter(muestras[:,0],muestras[:,1],s=4,alpha=.3,label='Generadas')
        ax.set_title(nombre);ax.set_xlim(-4,4);ax.set_ylim(-2,2)
    axes[0].legend();plt.tight_layout();plt.show()
    display(pd.DataFrame(filas,columns=['caso','fraccion cerca de un modo','cobertura de modos','desviacion media']))
    assert filas[0][1]==1 and filas[0][2]==.5
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_gan_cobertura()

caso fraccion cerca de un modo cobertura de modos desviacion media
0 Un modo 1.0000 0.5 0.000000
1 Dispersión amplia 0.0625 1.0 1.741688
2 Dos modos 0.9850 1.0 1.101050

La desviación global puede crecer tanto por diversidad útil como por ruido fuera del soporte. La cobertura binaria, a su vez, se satisface con muy pocas visitas al modo minoritario. Para describir equilibrio de frecuencias necesitaríamos además contar las asignaciones. Esta lectura evita convertir un solo número en un criterio universal de calidad.

Ante muestras pobres, formule una hipótesis y una observación que pueda refutarla. Si sospecha colapso, compare un lote amplio con ruido nuevo y ruido fijo entre épocas. Si sospecha que D domina, examine sus respuestas en reales y generadas y las normas de gradiente de G. Si sospecha normalización incorrecta, compruebe rango real, activación de salida y visualización antes de modificar la arquitectura. Prefije una modificación por ensayo y conserve también los fracasos; elegir una grilla favorable después de muchos intentos oculta la estabilidad del método.

27.3 3. MNIST: observar el recorrido, no elegir una imagen favorable

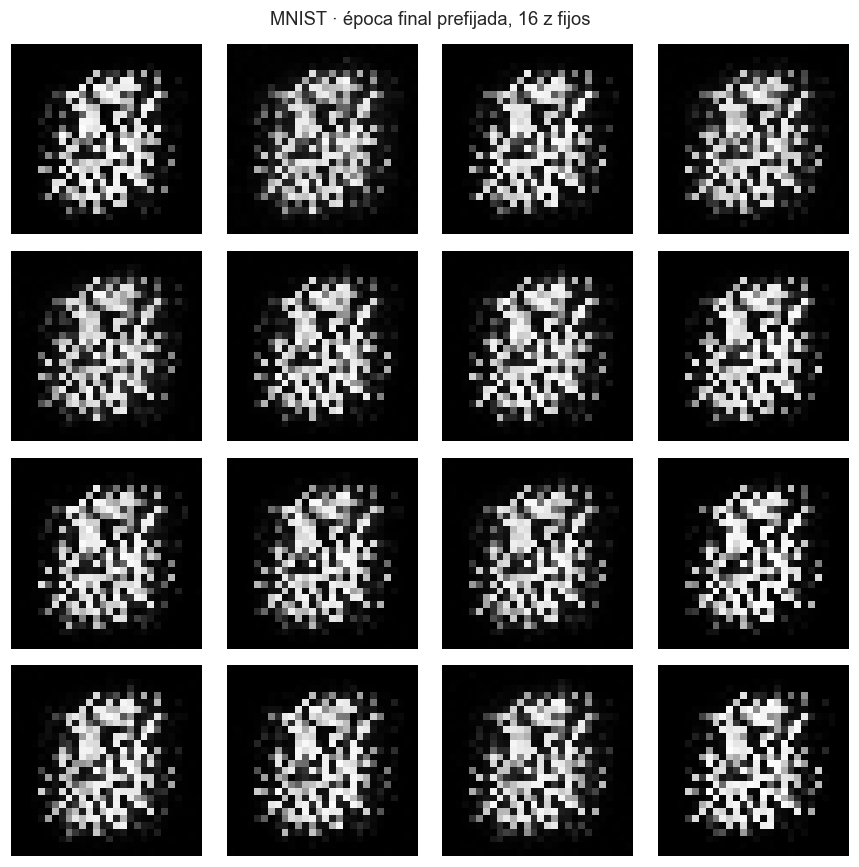
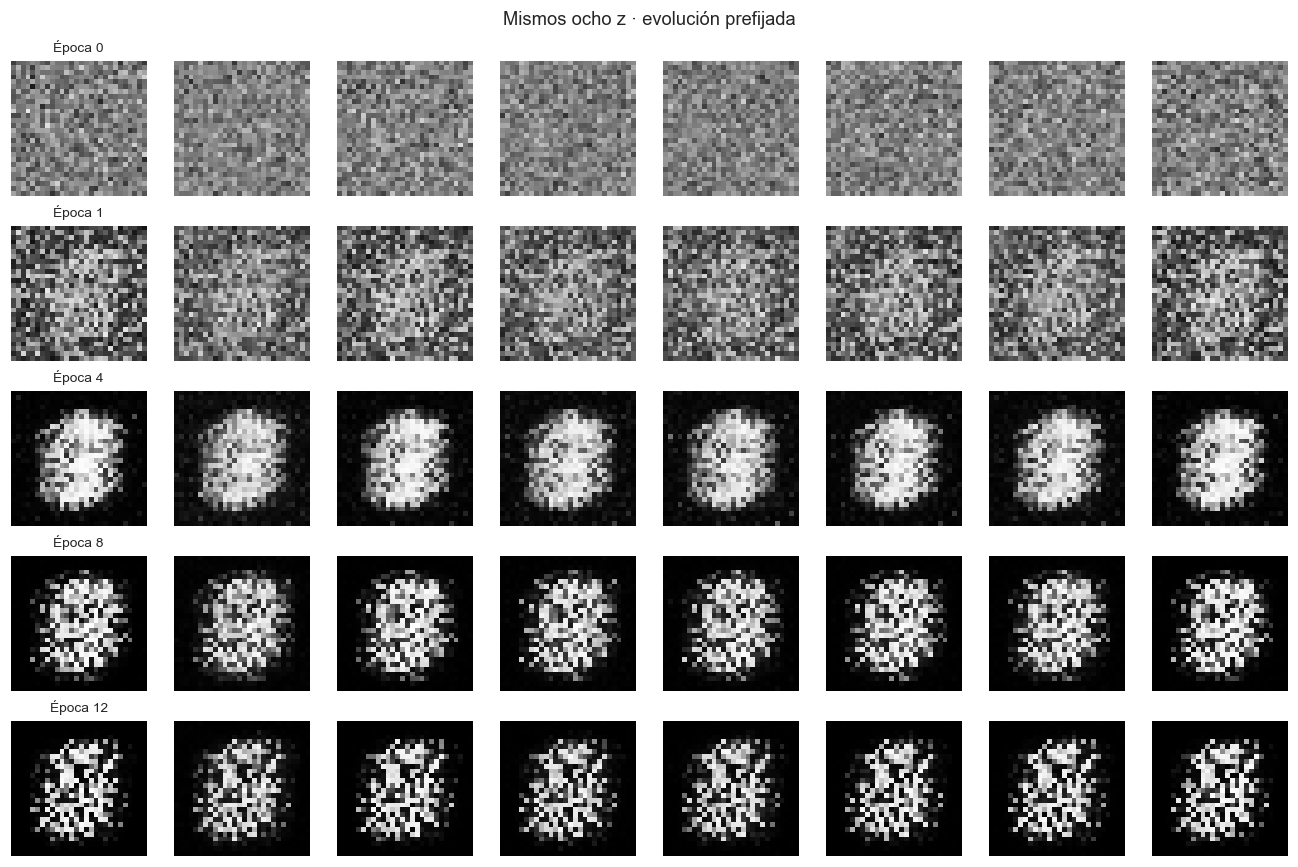
La grilla inicial y las capturas de épocas 1/4/8/12 utilizan los mismos 16 vectores z. Esto permite inspeccionar cómo cambia la salida asociada a cada entrada del generador, aunque no define una identidad semántica estable de un dígito.

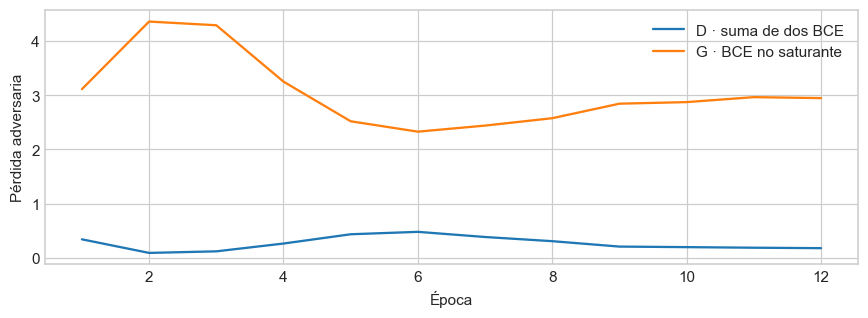
Las pérdidas se promedian ponderando cada lote por su cantidad de muestras. No se llaman accuracy ni val_loss. Oscilaciones, un discriminador seguro o imágenes parecidas son pistas para investigar; ninguno diagnostica por sí solo colapso de modos.

xm,ym,xtm,ytm=mnist();x=xm[:8000].astype(np.float32).reshape(-1,784)/255
g,d,hm,cap=entrenar_gan(x,'MNIST',12)
fig,ax=plt.subplots(figsize=(8,3));ax.plot(hm.epoca,hm.loss_D,label='D · suma de dos BCE');ax.plot(hm.epoca,hm.loss_G,label='G · BCE no saturante');ax.set(xlabel='Época',ylabel='Pérdida adversaria');ax.legend();fig.tight_layout();plt.show()
grilla(cap[12],'MNIST · época final prefijada, 16 z fijos')
fig,axes=plt.subplots(len(cap),8,figsize=(12,1.6*len(cap)))
for fila,(ep,imgs) in enumerate(cap.items()):
    for j in range(8):axes[fila,j].imshow(imgs[j],cmap='gray',vmin=0,vmax=1);axes[fila,j].axis('off')
    axes[fila,0].set_title(f'Época {ep}',fontsize=9)
fig.suptitle('Mismos ocho z · evolución prefijada');fig.tight_layout();plt.show()
MNIST 1 D/G 0.343 3.112
MNIST 2 D/G 0.093 4.357
MNIST 3 D/G 0.122 4.289
MNIST 4 D/G 0.266 3.25
MNIST 5 D/G 0.437 2.519
MNIST 6 D/G 0.481 2.328
MNIST 7 D/G 0.386 2.44
MNIST 8 D/G 0.309 2.576
MNIST 9 D/G 0.209 2.844
MNIST 10 D/G 0.199 2.872
MNIST 11 D/G 0.189 2.964
MNIST 12 D/G 0.18 2.947

27.4 4. Bolsos Fashion-MNIST

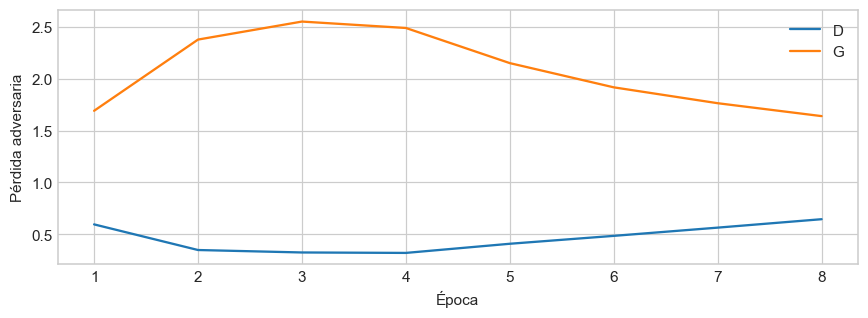
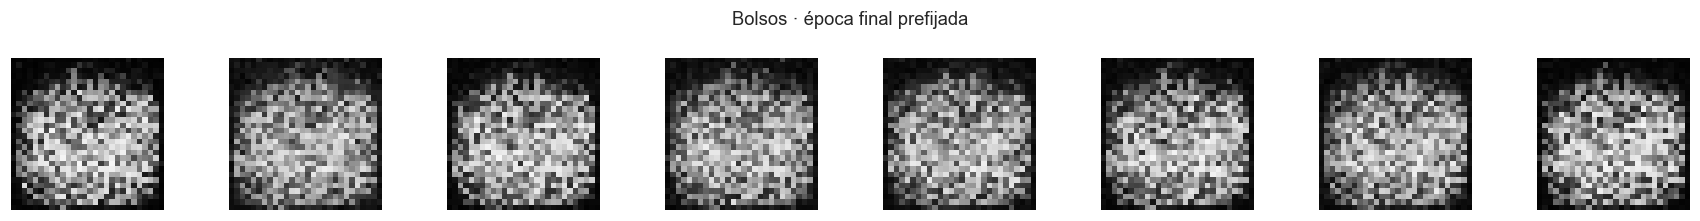
Se entrena un par nuevo G/D, con el mismo diseño y semilla, pero distinto tamaño de datos y presupuesto. Esa diferencia impide declarar una comparación causal entre dominios a partir de pérdidas o nitidez. Las imágenes no son fotografías de productos reales ni nuevos diseños comercialmente validados.

xf,yf,xtf,ytf=mnist('fashion');xb=xf[yf==8][:4000].astype(np.float32).reshape(-1,784)/255
g2,d2,hb,capb=entrenar_gan(xb,'Bolsos',8)
fig,ax=plt.subplots(figsize=(8,3));ax.plot(hb.epoca,hb.loss_D,label='D');ax.plot(hb.epoca,hb.loss_G,label='G');ax.set(xlabel='Época',ylabel='Pérdida adversaria');ax.legend();fig.tight_layout();plt.show()
grilla(capb[8][:8],'Bolsos · época final prefijada',8)
Bolsos 1 D/G 0.597 1.69
Bolsos 2 D/G 0.35 2.375
Bolsos 3 D/G 0.326 2.548
Bolsos 4 D/G 0.322 2.487
Bolsos 5 D/G 0.41 2.148
Bolsos 6 D/G 0.486 1.915
Bolsos 7 D/G 0.565 1.763
Bolsos 8 D/G 0.646 1.638

27.5 5. Diversidad en píxeles y salida de D

Medimos desviación media entre 64 muestras y la contrastamos con imágenes reales. Una dispersión baja puede indicar salidas parecidas; ruido sin estructura también puede tener dispersión alta. No es FID, cobertura de modos ni un umbral universal de colapso.

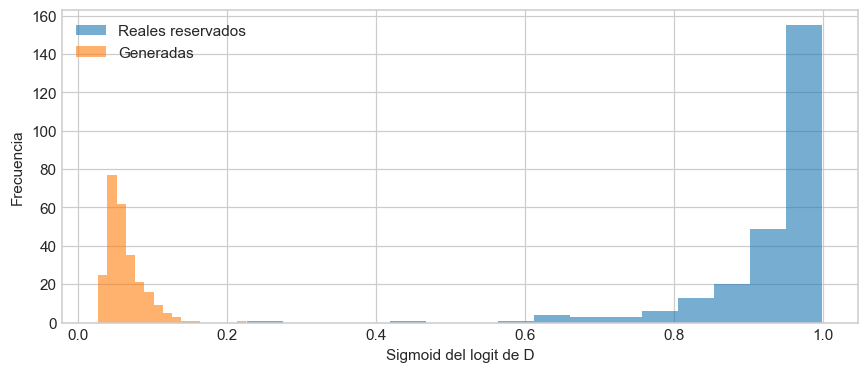
Para el histograma D(real)/D(falso), la referencia real proviene del test oficial reservado, no de las primeras imágenes de entrenamiento. Sigmoid transforma el logit en la salida probabilística del discriminador bajo su tarea; no es una certificación de autenticidad ni una medida calibrada para otro entorno.

z=torch.from_numpy(np.random.default_rng(200).normal(size=(64,64)).astype(np.float32)).to(DEVICE)
filas=[]
for nombre,modelo,reales in [('MNIST',g,xtm[:64].astype(np.float32)/255),('Bolsos',g2,xtf[ytf==8][:64].astype(np.float32)/255)]:
    im=generar(modelo,z);filas.append({'dominio':nombre,'std_pixel_generadas':float(im.std(0).mean()),'std_pixel_reales':float(reales.std(0).mean())})
t=pd.DataFrame(filas);display(t);t.to_csv(ARTEFACTOS/'diversidad-pixel.csv',index=False)
with torch.inference_mode():
    d.eval();reales=torch.from_numpy(xtm[:256].astype(np.float32).reshape(-1,784)/255).to(DEVICE)
    falsos=g(torch.from_numpy(np.random.default_rng(201).normal(size=(256,64)).astype(np.float32)).to(DEVICE))
    dr=d(reales).sigmoid().cpu().numpy().ravel();df=d(falsos).sigmoid().cpu().numpy().ravel()
fig,ax=plt.subplots(figsize=(8,3.5));ax.hist(dr,bins=16,alpha=.6,label='Reales reservados');ax.hist(df,bins=16,alpha=.6,label='Generadas');ax.set(xlabel='Sigmoid del logit de D',ylabel='Frecuencia');ax.legend();fig.tight_layout();plt.show()
print('D real/falso · medias:',dr.mean(),df.mean())
dominio std_pixel_generadas std_pixel_reales
0 MNIST 0.031455 0.176652
1 Bolsos 0.076500 0.271236

D real/falso · medias: 0.92987514 0.0631984

27.6 6. Interpolación y evaluación responsable

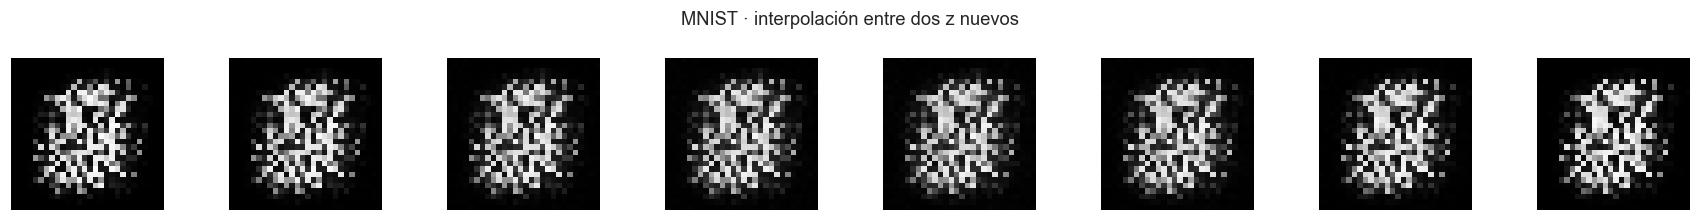
La interpolación usa puntos nuevos prefijados. Que cambie la forma a lo largo del trayecto muestra sensibilidad a z, pero no estima cobertura de toda la distribución. Una grilla pequeña puede ocultar repetición o seleccionar accidentalmente ejemplos agradables. Para otro estudio, prefije una evaluación ciega y métricas acordes al dominio.

WGAN-GP utiliza un objetivo de crítico y una penalización de gradiente diferentes; no se implementa ni se atribuyen aquí sus resultados a BCE. Los temas de procedencia, autorización de datos, sesgos y uso de imágenes sintéticas se desarrollan en el capítulo de ética. Generar píxeles nuevos no demuestra originalidad ni aptitud para cualquier uso.

rng=np.random.default_rng(202);a=rng.normal(size=(1,64));b=rng.normal(size=(1,64));alpha=np.linspace(0,1,8)[:,None]
grilla(generar(g,torch.tensor((1-alpha)*a+alpha*b,dtype=torch.float32,device=DEVICE)),'MNIST · interpolación entre dos z nuevos',8)

27.7 7. Guardar generadores y comprobar z fijos

El artefacto especifica dimensión latente, distribución N(0,I), rango de salida y época prefijada. Se reconstruye G y se comprueba que la recarga produzca la misma salida para los z guardados. No se escoge una época por mínimo de G ni por el test. Los optimizadores no se incluyen: son artefactos de inferencia.

for nombre,modelo,ep in [('MNIST',g,12),('Bolsos',g2,8)]:
    ruta=ARTEFACTOS/f'{nombre}-G.pt';torch.save({'state_dict':pesos(modelo),'latente':64,'epoca':ep},ruta)
    nuevo=crear_g().to(DEVICE);nuevo.load_state_dict(torch.load(ruta,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval()
    np.testing.assert_allclose(generar(modelo,z_fijo),generar(nuevo,z_fijo),rtol=1e-5,atol=1e-6)
(ARTEFACTOS/'contrato.json').write_text(json.dumps({'latente':64,'prior':'normal estandar','salida':'784 intensidades [0,1]; reshape 28x28','seleccion':'epocas finales prefijadas 12 y 8','recarga_z_fijo':True,'G_sin_cambios_en_paso_D':True,'D_sin_cambios_en_paso_G':True}),encoding='utf-8')
233

27.7.1 Lectura de la ejecución registrada

Se conservan MNIST 8000 imágenes/12 épocas y bolsos 4000/8, MLP 64→128→784, discriminador 784→128→1 y Adam 0,0002. Se comprueba aislamiento de actualizaciones D/G, se mide la pérdida real por lote ponderado y se guarda la época final prefijada, sin inventar val_loss generativa. Los z fijos muestran inicio y evolución. Las muestras finales son poco legibles y semejantes: este presupuesto no logró síntesis convincente. No se presenta como éxito ni se diagnostica colapso sólo por una varianza. Se informan diversidad de píxeles y D sobre reales reservados. Recargas de los dos generadores comprobadas.

Ejecución CPU del 15 de octubre de 2026; contraste esta lectura si cambia datos, versión o semilla.

27.8 8. Decisiones y ejercicios

Repita con semillas y presupuesto prefijados antes de concluir que una modificación estabiliza el juego. Registre muestras fijas y nuevas, variación y referencias reales. Si aparecen repeticiones, investigue diversidad y cobertura; no transforme una varianza o una loss aislada en un diagnóstico definitivo. Un estudio más exigente deberá medir calidad y diversidad con instrumentos adecuados al dominio.

27.9 Referencias

El juego y el discriminador óptimo se basan en Goodfellow et al., Generative Adversarial Nets. Los casos de dos modos y sus indicadores son demostraciones docentes.