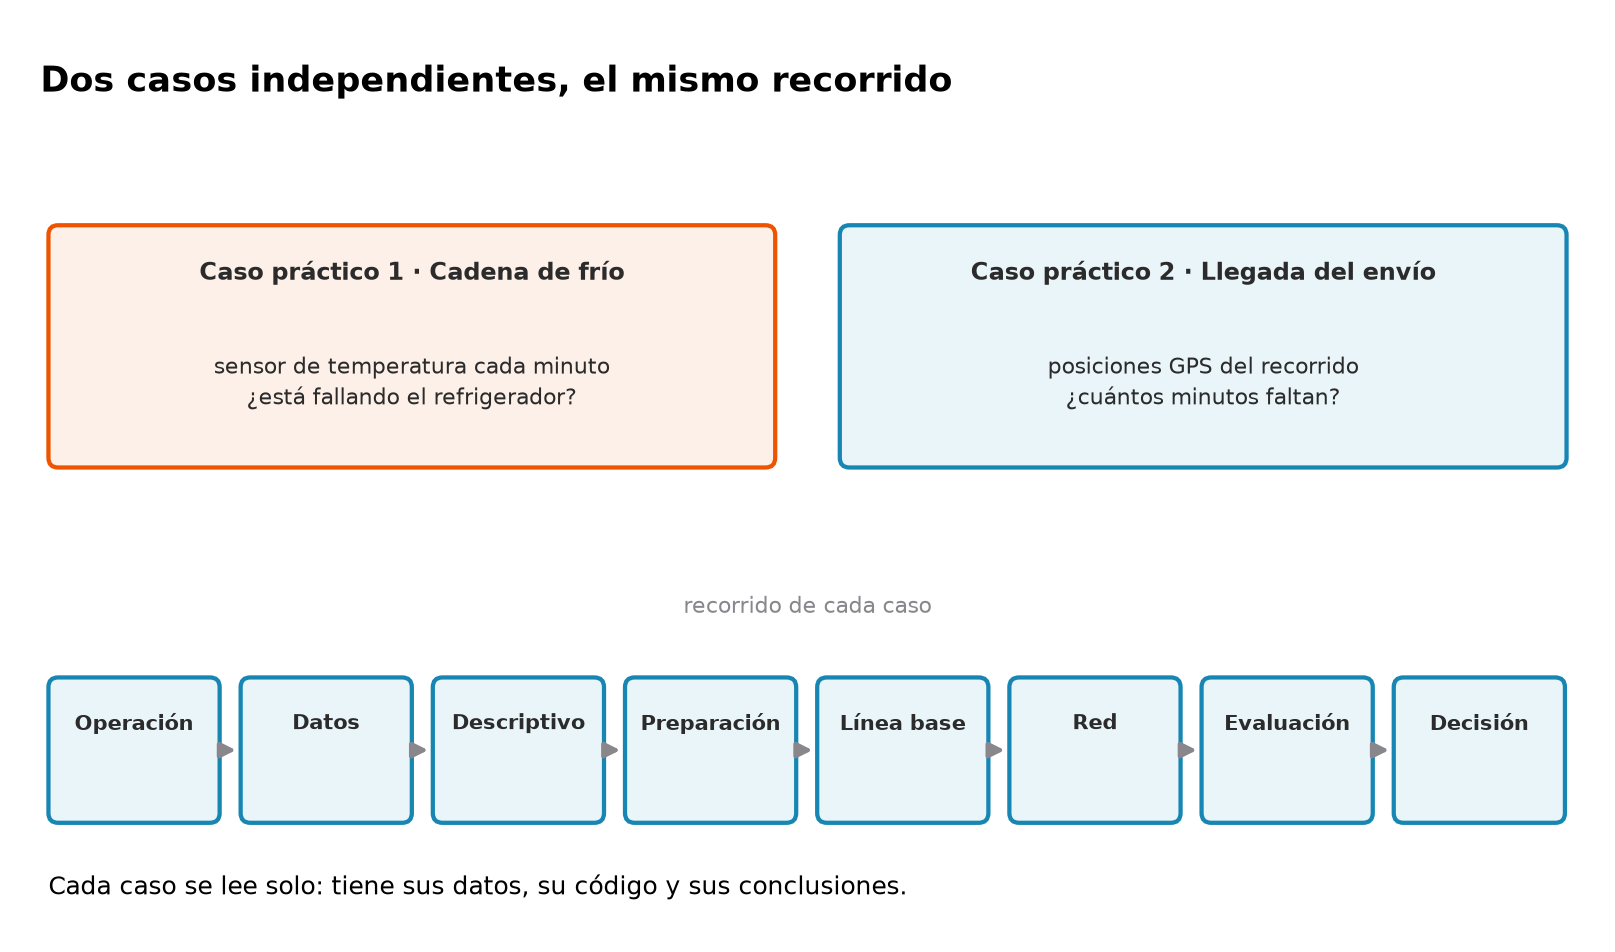
En los capítulos 18 a 21 aprendiste las piezas: embeddings, redes recurrentes, LSTM, GRU y secuencia a secuencia. Este capítulo las pone a trabajar en problemas como los que enfrenta una empresa de mensajería. Cada caso se resuelve de principio a fin: el problema de la operación, los datos, el análisis descriptivo, la preparación, una línea base sin red, la red, la evaluación y la decisión que se toma con ella.
Una red recurrente, en pocas palabras. Una red recurrente es un tipo de red neuronal hecha para leer datos que llegan en orden, uno detrás de otro: las lecturas de un sensor minuto a minuto, las posiciones de un vehículo, las palabras de un mensaje. Se usa principalmente cuando lo importante no está en un dato suelto, sino en cómo cambian los datos con el tiempo: pronosticar la demanda de mañana, notar que una máquina empieza a fallar, estimar cuánto falta para llegar o entender una frase. Se basa en una idea sencilla: la red lee un dato a la vez y lleva una especie de memoria, un resumen de lo que ha leído hasta ese momento, que actualiza con cada dato nuevo. Cuando termina de leer, su respuesta tiene en cuenta toda la historia y no solo el último valor. Las versiones más usadas, la LSTM y la GRU, agregan unas «puertas» con las que la red decide qué recordar y qué olvidar, para no perder lo importante aunque haya pasado hace un buen rato.
Caso
Problema de la operación
Técnica
Datos
1. Cadena de frío
Avisar a tiempo que el refrigerador de un furgón de medicamentos está fallando
GRU sobre ventanas de 2 horas de un sensor
Sintéticos: 750 viajes de 10 horas, minuto a minuto
2. Llegada del envío
Estimar cuántos minutos faltan para que el conductor llegue a cada cliente
LSTM sobre la última media hora del GPS, unida al plan de la ruta
Sintéticos: 550 rutas de reparto en Bogotá, minuto a minuto
Los dos casos son independientes: cada uno tiene su propia configuración, sus datos y su código, y se puede leer y ejecutar sin el otro.
Dos casos independientes, el mismo recorrido.
Tiempo estimado: unos 50 minutos de lectura por caso; la ejecución completa tarda unos 6 minutos (4.5 del Caso práctico 1 y 1.5 del Caso práctico 2) en una CPU.
Nivel: aplicación de lo visto en la Parte IV; no presenta arquitecturas nuevas.
22.3 Caso práctico 1: Avisar a tiempo que el refrigerador está fallando
AdvertenciaEmpresa y datos ficticios
BITLogística es una empresa ficticia. Los viajes, las temperaturas y los costos de este caso se generan con un simulador del propio caso (simulador_frio.py) y no corresponden a BIT, a ningún transportador ni a ningún laboratorio. Las reglas del simulador están explicadas en la sección de datos y su código completo está al final del caso.
La red de este caso: una GRU. La GRU es una red recurrente con memoria selectiva: lee las lecturas del sensor minuto a minuto y, en cada una, decide cuánto conservar de lo que ya sabía y cuánto cambiar con lo nuevo. Se usa sobre todo con sensores y series de tiempo, cuando una señal de alarma se va formando de a poco y hay que compararla con lo que pasó minutos u horas antes. En este caso se basa en las dos últimas horas del furgón: no se fija en si la temperatura está alta en un momento, sino en si la forma en que el furgón se enfría se parece a la de un refrigerador sano o a la de uno que empieza a fallar.
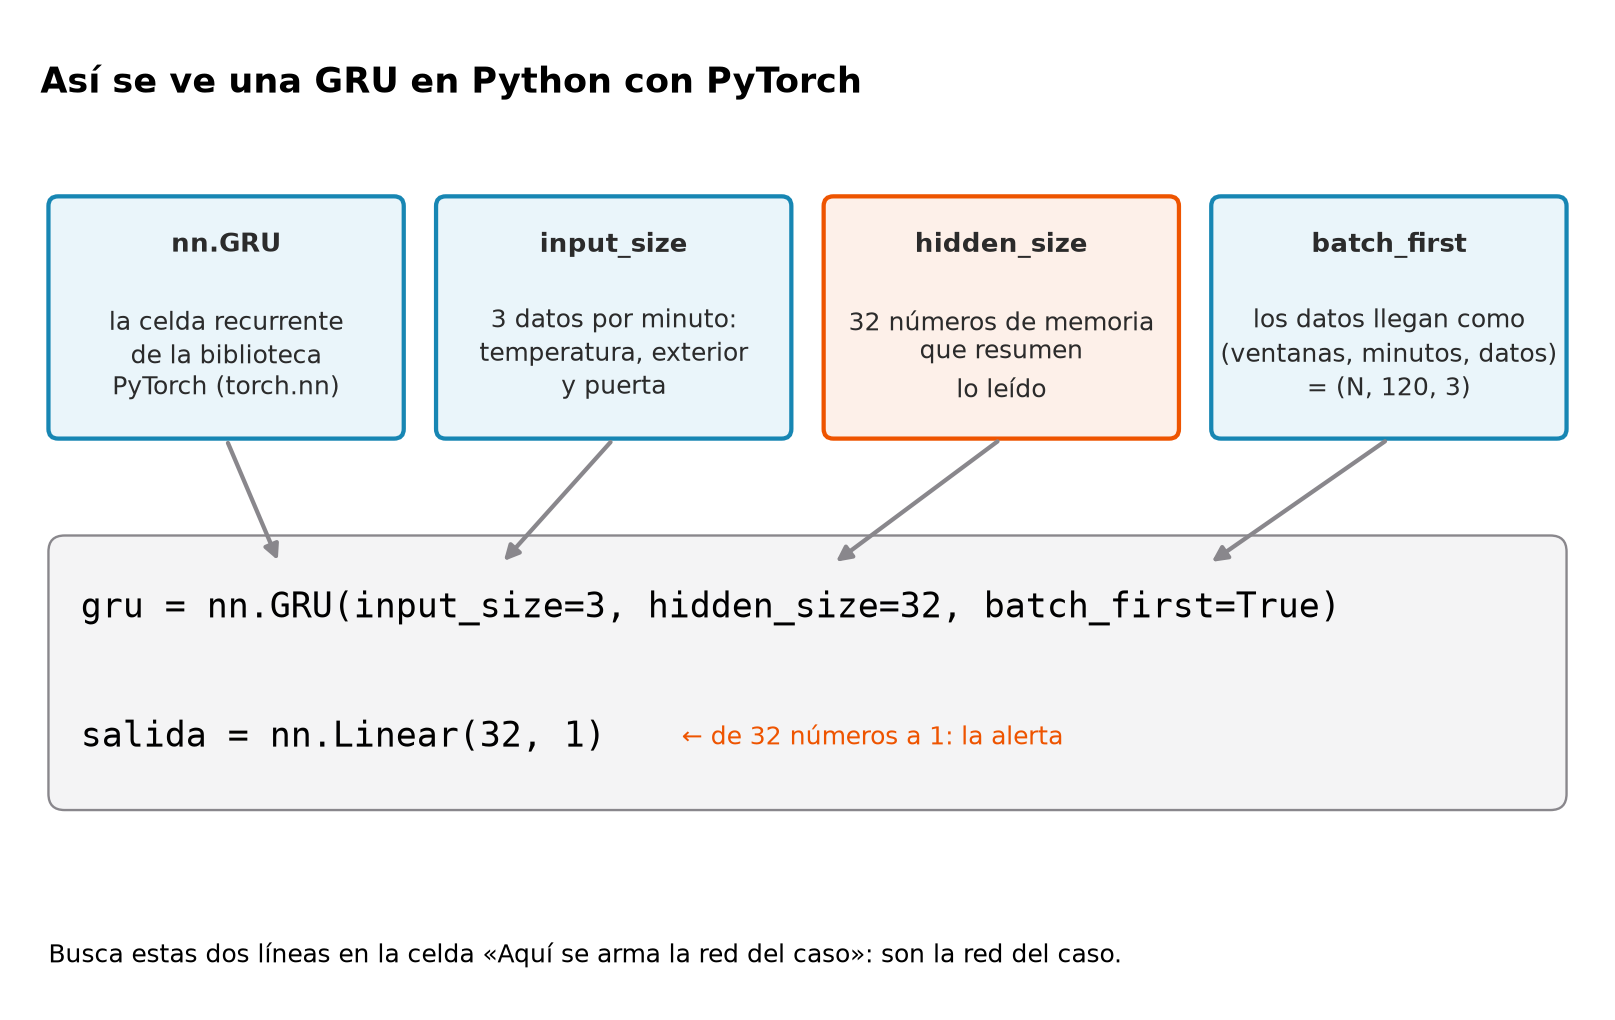
Cómo se ve en Python. La GRU no se programa desde cero: viene lista en PyTorch, la biblioteca de redes neuronales que usa todo el libro, dentro de su módulo torch.nn. Crearla toma una sola línea, y lo que hay que decidir son tres parámetros:
input_size=3: cuántos datos llegan en cada paso. Aquí son tres por minuto: la temperatura interior, la exterior y si la puerta está abierta.
hidden_size=32: el tamaño de la memoria, es decir, cuántos números usa la red para resumir lo que ha leído. Con más números puede recordar más detalles, pero se vuelve más grande y más lenta de entrenar.
batch_first=True: el orden en que llegan los datos: primero las ventanas, después los minutos y al final los datos de cada minuto.
Una segunda línea, nn.Linear(32, 1), convierte esa memoria de 32 números en uno solo: la señal de alerta. Esas dos líneas son la red del caso; el resto del código prepara los datos, entrena la red y la evalúa. Cuando llegues a la sección «Diseño de la red», encontrarás las dos líneas dentro de DetectorDeFalla.
Las dos líneas que crean la red del caso y qué significa cada parámetro.
22.3.1 El problema en la operación
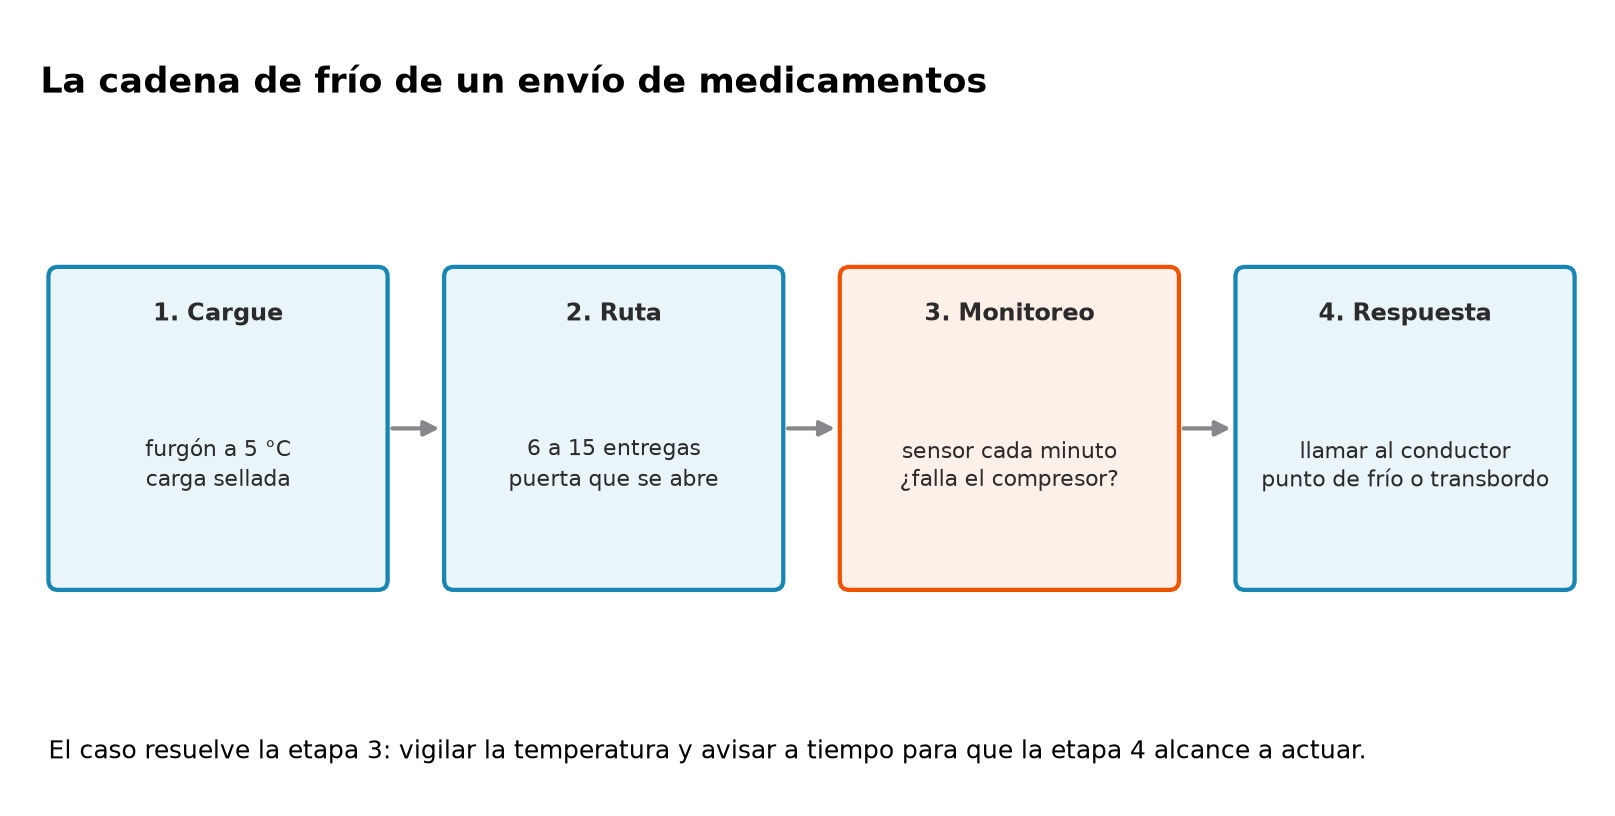
BITLogística reparte medicamentos refrigerados (vacunas, insulinas, biológicos) desde sus centros en seis ciudades. Cada furgón sale con la carga a 5 °C y hace de 6 a 15 entregas en una jornada de 10 horas.
NotaCadena de frío
La cadena de frío es el conjunto de pasos que mantiene un producto dentro de su rango de temperatura desde que se fabrica hasta que se usa. Para la mayoría de los medicamentos refrigerados, ese rango es de 2 a 8 °C. Si se rompe, el producto puede perder su efecto sin que se note a simple vista.
NotaExcursión de temperatura
Una excursión de temperatura es un tramo en que la carga sale de su rango permitido. En este caso, la empresa considera comprometida la carga si pasa más de 10 minutos seguidos por encima de 8 °C. Una subida breve, como la de abrir la puerta en una entrega, no es una excursión.
La cadena de frío de un envío de medicamentos.
Cada furgón tiene un sensor que registra la temperatura cada minuto y la envía a la central. Hoy, la central tiene una regla: si la temperatura llega a 7 °C, suena una alarma. La regla tiene dos problemas que el equipo de operaciones conoce bien:
Suena por nada. Cuando el conductor abre la puerta en una entrega, la temperatura sube unos minutos y la alarma salta, aunque el refrigerador funcione bien. Los operadores se acostumbran a ignorarla.
Suena tarde. Cuando el compresor de verdad falla, la temperatura sube despacio. Para cuando llega a 7 °C, faltan pocos minutos para la excursión, y el conductor necesita al menos 30 minutos para llegar a un punto de frío o encontrarse con un furgón de respaldo.
La pregunta del caso: ¿puede una red recurrente, mirando las últimas dos horas del sensor, avisar que el compresor está fallando al menos 30 minutos antes de la excursión, sin sonar con cada apertura de puerta?
Lo que cuesta equivocarse, con cifras ficticias pero en la proporción de una operación real:
Error
Qué pasa
Costo para BITLogística
Excursión sin aviso a tiempo
Se pierde la carga del furgón y hay que reponerla al cliente
80 millones de pesos
Alarma (verdadera o falsa)
El conductor se desvía a un punto de frío y la ruta se retrasa
300 mil pesos
Una carga perdida cuesta lo mismo que 267 alarmas. Por eso la empresa acepta algunas alarmas de más si así evita excursiones, pero no tantas que los operadores dejen de atenderlas.
22.3.2 Los datos
No hay datos reales de este caso, así que el caso usa un simulador con reglas físicas sencillas. Saber cómo se fabricaron los datos permite comprobar después qué encontró la red:
Termostato: el compresor se enciende al llegar a 5.6 °C y se apaga al bajar a 4.4 °C. La temperatura sube y baja en ciclos de pocos minutos.
Calor del exterior: entra por las paredes según la diferencia con el exterior, que depende de la ciudad (de 14 °C en Bogotá a 29 °C en la costa) y de la hora.
Entregas: la puerta se abre de 1 a 6 minutos en cada parada y entra calor de golpe.
Falla del compresor: en el 20 % de los viajes, el compresor empieza a perder potencia en un minuto al azar. Al principio todavía alcanza, pero cada ciclo de enfriamiento dura más; cuando ya no alcanza, la temperatura sube sin parar.
Sensor: registra con un ruido pequeño y redondea a 0.1 °C.
Se simulan tres flotas con semillas distintas: 400 viajes para entrenar, 150 para validar y 200 para la prueba final. Separar por viajes, y no por minutos o ventanas, es la decisión más importante de la preparación: dos ventanas del mismo viaje comparten casi todos sus minutos, y si una quedara en entrenamiento y otra en prueba, la red estaría siendo evaluada con datos que ya vio.
La primera celda del caso prepara sus herramientas; la segunda simula las tres flotas.
# Caso práctico 1 · Configuración: herramientas, semilla y carpeta de resultados del caso.from pathlib import Pathimport jsonimport platformimport timeimport matplotlibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport sklearnimport torchfrom torch import nnfrom torch.nn import functional as Ffrom sklearn.metrics import confusion_matrix, f1_score, precision_score, recall_scorefrom IPython.display import displayimport simulador_frio as simulador # el simulador solo de este casoSEMILLA =42np.random.seed(SEMILLA)torch.manual_seed(SEMILLA)torch.set_num_threads(2)ARTEFACTOS = Path("artefactos_pytorch") /"caso1"ARTEFACTOS.mkdir(parents=True, exist_ok=True)plt.style.use("seaborn-v0_8-whitegrid")plt.rcParams.update({"figure.dpi": 110, "font.size": 10})INICIO_CASO = time.perf_counter()print( {"python": platform.python_version(),"torch": torch.__version__,"numpy": np.__version__,"pandas": pd.__version__,"sklearn": sklearn.__version__,"matplotlib": matplotlib.__version__,"dispositivo": "cpu","hilos_cpu": torch.get_num_threads(),"semilla": SEMILLA, })
El entorno usa Python 3.13.16, PyTorch 2.14.1, NumPy 2.5.4, pandas 3.1.0, scikit-learn 1.9.1 y matplotlib 3.11.2, sobre una CPU de 2 núcleos. El caso no necesita GPU.
# Simula las tres flotas, cada una con su semilla.# Así, los viajes de prueba nunca se ven al entrenar.viajes, informacion = {}, {}for parte, n_viajes, semilla in [("train", 400, 1), ("val", 150, 2), ("test", 200, 3)]: viajes[parte], informacion[parte] = simulador.simular_flota(n_viajes, semilla)for parte, info in informacion.items(): con_falla = info.falla.sum() con_excursion = info.minuto_excursion.notna().sum()print(f"{parte:<5}{len(info):>3} viajes · con falla del compresor {con_falla:>3} "f"({info.falla.mean():.1%}) · con excursión {con_excursion:>3}" )print("\nMinutos por viaje:", len(viajes["train"][0]), "· primeras filas de un viaje:")display(viajes["train"][0].head(4))
train 400 viajes · con falla del compresor  84 (21.0%) · con excursión  77
val   150 viajes · con falla del compresor  27 (18.0%) · con excursión  24
test  200 viajes · con falla del compresor  47 (23.5%) · con excursión  43

Minutos por viaje: 600 · primeras filas de un viaje:
minuto
temperatura
exterior
puerta
0
0
5.1
21.8
0
1
1
5.2
21.7
0
2
2
5.5
21.2
0
3
3
5.6
21.9
0
Las 3 flotas se parecen, como se espera de viajes simulados con las mismas reglas:
Entre el 18.0 % y el 23.5 % de los viajes tienen falla del compresor: 84 de 400 en entrenamiento, 27 de 150 en validación y 47 de 200 en prueba.
Casi todas las fallas terminan en excursión (77, 24 y 43), salvo las que empiezan tan tarde que el viaje acaba antes.
Cada viaje tiene 600 filas, una por minuto. En las primeras filas se ve el ciclo del termostato: la temperatura sube de 5.1 a 5.6 °C, donde se enciende el compresor.
22.3.3 Análisis descriptivo
Antes de pensar en una red hay que mirar los datos con los ojos de la operación. La primera pregunta es cómo se ve un viaje normal frente a uno con falla.
# 1. Elige el primer viaje normal y el primer viaje con falla y excursión de entrenamiento.info = informacion["train"]normal =int(info.index[~info.falla][0])con_falla =int(info.index[info.falla & info.minuto_excursion.notna()][0])# 2. Dibuja la temperatura, las aperturas de puerta y el límite;# en el viaje con falla, también el inicio de la falla y de la excursión.fig, ejes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)for eje, numero, titulo in [ (ejes[0], normal, "Viaje normal"), (ejes[1], con_falla, "Viaje con falla del compresor"),]: tabla, fila = viajes["train"][numero], info.loc[numero] eje.plot( tabla.minuto, tabla.temperatura, color="#1786B3", lw=0.9, label="temperatura" )for minuto in tabla.minuto[ tabla.puerta ==1 ]: # una franja por minuto con puerta abierta eje.axvspan(minuto, minuto +1, color="#89878C", alpha=0.25, lw=0) eje.axhline(simulador.LIMITE, color="#2B2B2B", ls="--", lw=1, label="límite 8 °C")if fila.falla: eje.axvline( fila.inicio_falla, color="#EE5400", lw=1.5, label="empieza la falla" ) eje.axvline( fila.minuto_excursion, color="#EE5400", ls=":", lw=1.5, label="empieza la excursión", ) eje.set( title=f"{titulo} · {fila.ciudad}, salida {fila.salida}, {fila.entregas} entregas", ylabel="°C", ) eje.legend(loc="upper left", fontsize=8)ejes[1].set(xlabel="Minuto del viaje", ylim=(3.5, 14))fig.tight_layout()plt.show()
Figura 22.1: Un viaje normal y un viaje con falla del compresor, minuto a minuto
Las 2 gráficas muestran por qué el problema es difícil:
En el viaje normal, la temperatura oscila todo el día entre unos 4 y 6 °C: es el termostato encendiendo y apagando el compresor. En dos entregas, cerca de los minutos 360 y 543, la apertura de la puerta la lleva a casi 6.7 °C, y en pocos minutos vuelve al ciclo normal.
En el viaje con falla, el compresor empieza a fallar en el minuto 327. Durante los primeros 40 minutos la gráfica casi no cambia: los ciclos solo se vuelven más largos y menos marcados. Hacia el minuto 370 la temperatura empieza a subir sin bajar, y en el minuto 399 empieza la excursión, apenas un minuto después de llegar a 7 °C.
La señal temprana está en la forma de los ciclos. Una alarma que mire un solo minuto ve lo mismo en una entrega que en una falla recién empezada.
La segunda pregunta es si la flota es pareja o si hay ciudades distintas. La tabla siguiente resume los viajes de entrenamiento por ciudad.
# Resumen de los viajes de entrenamiento por ciudad.info = informacion["train"].copy()info["exterior_medio"] = [ tabla.exterior.mean() for tabla in viajes["train"]] # un promedio por viajepor_ciudad = ( info.groupby("ciudad") .agg( viajes=("viaje", "count"), con_falla=("falla", "mean"), entregas=("entregas", "mean"), exterior_medio=("exterior_medio", "mean"), ) .round({"con_falla": 3, "entregas": 1, "exterior_medio": 1}) .sort_values("exterior_medio"))display(por_ciudad)
viajes
con_falla
entregas
exterior_medio
ciudad
Bogotá
73
0.233
9.9
16.6
Medellín
63
0.143
10.6
24.6
Bucaramanga
56
0.196
10.8
26.5
Cali
76
0.184
10.8
26.7
Cartagena
71
0.268
10.6
30.4
Barranquilla
61
0.230
9.8
31.0
La flota de las 6 ciudades es pareja en lo que importa para el caso:
Hay entre 56 y 76 viajes por ciudad y entre 9.8 y 10.8 entregas por viaje en promedio.
El exterior cambia mucho: 16.6 °C en promedio en Bogotá frente a 30.4 y 31.0 °C en Cartagena y Barranquilla. Por eso el exterior entra como dato de cada minuto: en la costa el calor entra casi el doble de rápido.
Las fallas no dependen de la ciudad (van del 14.3 % en Medellín al 26.8 % en Cartagena, diferencias normales con unos 60 viajes por ciudad). En el simulador la falla es igual de probable en todas partes.
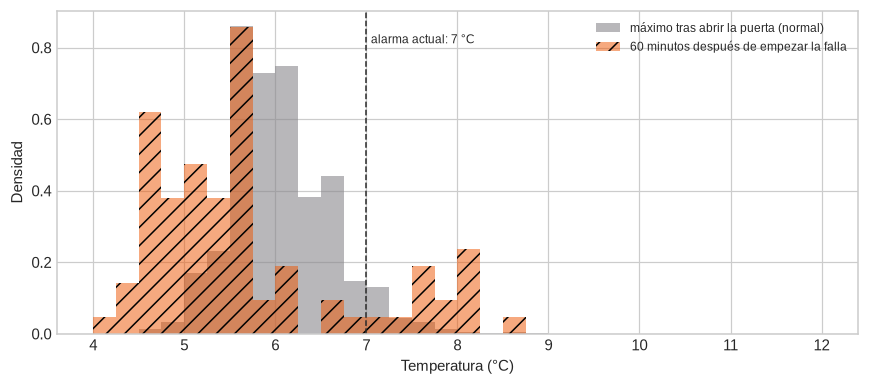
La tercera pregunta es la que decide el diseño: ¿se puede distinguir una apertura de puerta de una falla mirando solo la temperatura de un minuto? La celda siguiente compara dos cosas en los viajes de entrenamiento: la temperatura más alta que se alcanza en los 10 minutos siguientes a cada apertura de puerta en viajes normales, y la temperatura que hay 60 minutos después de que empieza una falla.
# 1. Máximo de los 10 minutos que siguen a cada apertura de puerta, en viajes normales.maximos_puerta = []for tabla, fila inzip(viajes["train"], informacion["train"].itertuples()):if fila.falla:continue aperturas = np.flatnonzero( np.diff(tabla.puerta.to_numpy(), prepend=0) ==1 ) # minuto en que se abrefor minuto in aperturas: maximos_puerta.append(tabla.temperatura[minuto : minuto +10].max())# 2. Temperatura 60 minutos después de que empieza la falla.a_los_60 = [ tabla.temperatura[fila.inicio_falla +60]for tabla, fila inzip(viajes["train"], informacion["train"].itertuples())if fila.falla and fila.inicio_falla +60< simulador.DURACION]maximos_puerta, a_los_60 = np.array(maximos_puerta), np.array(a_los_60)print(f"Aperturas de puerta en viajes normales: {len(maximos_puerta)} · "f"máximo mediano {np.median(maximos_puerta):.1f} °C · "f"{np.mean(maximos_puerta >=7):.1%} llegan a 7 °C")print(f"Fallas a los 60 minutos: {len(a_los_60)} · "f"temperatura mediana {np.median(a_los_60):.1f} °C · "f"{np.mean(a_los_60 >=7):.1%} ya están en 7 °C o más")# 3. Los dos histogramas, con barras rayadas para distinguirlos también sin color.fig, ax = plt.subplots(figsize=(8, 3.6))bordes = np.arange(4, 12.25, 0.25)ax.hist( maximos_puerta, bins=bordes, density=True, color="#89878C", alpha=0.6, label="máximo tras abrir la puerta (normal)",)ax.hist( a_los_60, bins=bordes, density=True, color="#EE5400", alpha=0.5, hatch="//", label="60 minutos después de empezar la falla",)ax.axvline(7, color="#2B2B2B", ls="--", lw=1)ax.text(7.05, ax.get_ylim()[1] *0.9, "alarma actual: 7 °C", fontsize=8)ax.set(xlabel="Temperatura (°C)", ylabel="Densidad")ax.legend(fontsize=8)fig.tight_layout()plt.show()
Aperturas de puerta en viajes normales: 3090 · máximo mediano 5.9 °C · 6.0% llegan a 7 °C
Fallas a los 60 minutos: 84 · temperatura mediana 5.4 °C · 16.7% ya están en 7 °C o más
Figura 22.2: Temperatura máxima tras abrir la puerta en viajes normales frente a la temperatura 60 minutos después del inicio de una falla
El histograma de las 2 distribuciones responde la pregunta, y la respuesta es no:
Las 3 090 aperturas de puerta de los viajes normales llevan la temperatura a un máximo mediano de 5.9 °C, y el 6.0 % llega a 7 °C o más. Esas son las alarmas falsas de la regla actual.
60 minutos después de empezar una falla, la temperatura mediana es de 5.4 °C: más baja que el máximo de una entrega cualquiera. Solo el 16.7 % de las fallas está en 7 °C o más a esa altura.
Las dos distribuciones se solapan. No hay un número de temperatura que separe las entregas de las fallas tempranas. Para separarlas hay que mirar cómo evoluciona la temperatura en el tiempo y si la puerta estaba abierta: un trabajo para una red que lea la secuencia.
Por último, el tiempo disponible: ¿cuántos minutos pasan desde que empieza la falla hasta la excursión? Ese es el margen que tiene cualquier sistema de alerta.
# Minutos entre el inicio de la falla y el de la excursión (viajes de entrenamiento).fallas = informacion["train"][ informacion["train"].falla & informacion["train"].minuto_excursion.notna()]margen = fallas.minuto_excursion - fallas.inicio_fallaprint(f"Viajes con falla y excursión: {len(fallas)}")print(f"Minutos desde el inicio de la falla hasta la excursión: mínimo {margen.min():.0f} · "f"mediana {margen.median():.0f} · máximo {margen.max():.0f}")print(f"Viajes con falla que terminan sin excursión (la falla empezó tarde): "f"{(informacion['train'].falla & informacion['train'].minuto_excursion.isna()).sum()}")print(f"Viajes normales con excursión (una apertura muy larga en un día caluroso): "f"{(~informacion['train'].falla & informacion['train'].minuto_excursion.notna()).sum()}")
Viajes con falla y excursión: 76
Minutos desde el inicio de la falla hasta la excursión: mínimo 43 · mediana 101 · máximo 240
Viajes con falla que terminan sin excursión (la falla empezó tarde): 8
Viajes normales con excursión (una apertura muy larga en un día caluroso): 1
El margen mediano de 101 minutos es razonable, pero no sobra:
De 76 viajes con falla y excursión, la excursión llega entre 43 y 240 minutos después del inicio de la falla, con una mediana de 101 minutos.
Si el aviso necesita 30 minutos de anticipación, el sistema tiene que reconocer la falla en su primera hora, cuando la temperatura todavía se ve normal.
Hay 8 viajes con falla y sin excursión, porque la falla empezó cerca del final de la jornada, y 1 viaje normal con excursión, por una entrega muy larga en un día caluroso. Ningún sistema basado en fallas del compresor puede prever ese último caso, y conviene saberlo antes de evaluar.
22.3.4 Preparación de los datos
El análisis descriptivo dejó tres decisiones tomadas:
La red verá ventanas de 120 minutos. Un ciclo del termostato dura pocos minutos y una apertura de puerta se recupera en unos 10; la falla, en cambio, se nota en que los ciclos se alargan durante decenas de minutos. Dos horas alcanzan para ver varios ciclos y comparar los recientes con los anteriores. La margen mediana entre falla y excursión, de más de una hora y media, deja tiempo para detectarla dentro de esa ventana.
Cada minuto lleva tres datos: la temperatura, la temperatura exterior y si la puerta está abierta. La puerta es la llave para no confundir una entrega con una falla, y el exterior explica por qué los furgones de la costa se calientan más rápido.
Una ventana nueva cada 5 minutos. En la operación, la red se consultaría cada 5 minutos con las dos horas anteriores. Con un paso de 5 minutos, cada viaje de 600 minutos da 97 ventanas.
NotaEtiqueta de una ventana
La etiqueta de cada ventana responde la pregunta que se quiere automatizar: ¿el compresor ya empezó a fallar en el último minuto de la ventana? Vale 1 si la falla empezó en ese minuto o antes, y 0 si no. No se etiqueta con «la temperatura pasó de 8 °C», porque eso enseñaría a la red a avisar cuando ya es tarde.
La celda siguiente construye las ventanas con un bucle sencillo, viaje por viaje.
# Construye las ventanas de 120 minutos, una cada 5 minutos, con su etiqueta.LARGO_VENTANA =120# minutos que ve la redPASO =5# cada cuánto se consulta la redCOLUMNAS = ["temperatura", "exterior", "puerta"] # los 3 datos de cada minutodef construir_ventanas(lista_viajes, info):"""Devuelve x (ventanas), y (etiquetas), el viaje y el último minuto de cada ventana.""" x, y, viaje, minuto_final = [], [], [], []for numero, tabla inenumerate(lista_viajes): datos = tabla[COLUMNAS].to_numpy(dtype=np.float32) # (600, 3) fila = info.loc[numero]for final inrange( LARGO_VENTANA -1, len(tabla), PASO ): # primera ventana: minutos 0 a 119 x.append(datos[final - LARGO_VENTANA +1 : final +1]) # (120, 3) fallando =bool(fila.falla) and final >= fila.inicio_falla y.append(int(fallando)) viaje.append(numero) minuto_final.append(final)return np.stack(x), np.array(y), np.array(viaje), np.array(minuto_final)ventanas = { parte: construir_ventanas(viajes[parte], informacion[parte]) for parte in viajes}for parte, (x, y, viaje, final) in ventanas.items():print(f"{parte:<5} ventanas {x.shape} · con falla en curso {y.mean():.1%} · "f"de {len(np.unique(viaje))} viajes" )
train ventanas (38800, 120, 3) · con falla en curso 11.1% · de 400 viajes
val   ventanas (14550, 120, 3) · con falla en curso 9.8% · de 150 viajes
test  ventanas (19400, 120, 3) · con falla en curso 12.9% · de 200 viajes
Las ventanas de 120 minutos quedan listas para la red:
Entrenamiento: 38 800 ventanas de 120 minutos y 3 datos, 97 por cada uno de los 400 viajes. Validación y prueba tienen 14 550 y 19 400.
Solo entre el 9.8 % y el 12.9 % de las ventanas tienen una falla activa. Es un problema desequilibrado: hay muchas más ventanas normales que con falla, y eso importa al evaluar.
Cada conjunto viene de sus propios viajes: ninguna ventana de prueba comparte minutos con una de entrenamiento.
La temperatura interior (alrededor de 5 °C) y la exterior (de 9 a 34 °C) tienen escalas muy distintas, y la red aprende mejor si todas las entradas tienen una escala parecida. Se escalan con la media y la desviación del entrenamiento, y esas mismas cifras se usan después en validación, prueba y operación: la red no puede conocer el futuro, tampoco a través de la escala. La puerta ya está entre 0 y 1 y se deja igual.
# Escala temperatura y exterior con media y desviación del entrenamiento.# La puerta queda igual.x_train = ventanas["train"][0]media = x_train.reshape(-1, 3).mean( axis=0) # una media por columna, con todos los minutosdesviacion = x_train.reshape(-1, 3).std(axis=0)media[2], desviacion[2] =0.0, 1.0# la puerta no se escala: (p - 0) / 1 = pprint("Media: ", {c: round(float(v), 3) for c, v inzip(COLUMNAS, media)})print("Desviación:", {c: round(float(v), 3) for c, v inzip(COLUMNAS, desviacion)})def escalar(x):return torch.tensor((x - media) / desviacion, dtype=torch.float32)tensores = { parte: (escalar(x), torch.tensor(y, dtype=torch.float32))for parte, (x, y, _, _) in ventanas.items()}ejemplo = ventanas["train"][0][0, -1, 0] # última temperatura de la primera ventanaescalado = (ejemplo - media[0]) / desviacion[0]print(f"\nEjemplo: {ejemplo:.1f} °C -> ({ejemplo:.1f} - {media[0]:.3f}) / {desviacion[0]:.3f}"f" = {escalado:.3f}")print("Formas finales:", {parte: tuple(t[0].shape) for parte, t in tensores.items()})
La escala sale solo de las 38 800 ventanas de entrenamiento:
Temperatura interior: media de 5.556 °C y desviación de 2.745 °C. La desviación es grande porque incluye los tramos de falla, en que la temperatura sube mucho.
Exterior: media de 26.074 °C y desviación de 5.245 °C.
Puerta: media 0 y desviación 1, para que quede igual.
Ejemplo: una lectura de 4.2 °C se convierte en (4.2 − 5.556) / 2.745 = −0.494. Las tres formas finales confirman que nada cambió de tamaño: solo de escala.
22.3.5 Una línea base sin red neuronal
La red tiene que ganarle a lo que la operación haría sin ella. Hay dos reglas razonables:
Regla de umbral (la actual): alarma si la última temperatura llega a 7 °C. Es simple y conocida por todos.
Regla de tendencia: alarma si el promedio de la última media hora, sin contar los minutos con la puerta abierta, pasa de 6 °C. Es la mejora que propondría un analista después de ver el análisis descriptivo: ignora las entregas y mira la temperatura sostenida.
Para medirlas como las vive la operación, la evaluación se hace por viaje: la primera ventana con alarma marca el minuto del aviso. Con eso se cuentan cuatro cosas:
Excursiones avisadas a tiempo: viajes con excursión en que el aviso llegó al menos 30 minutos antes.
Viajes con falla avisados: cualquier aviso en un viaje cuyo compresor falló, haya excursión o no.
Viajes normales con alarma: alarmas falsas, contadas por viaje.
Anticipación mediana: minutos entre el aviso y la excursión, en los viajes con excursión.
NotaAnticipación
La anticipación es cuántos minutos antes del problema llega el aviso. Aquí se mide hasta el inicio de la excursión. Una anticipación negativa significa que el aviso llegó cuando la excursión ya había empezado.
# Las dos reglas y la evaluación por viaje (la misma función servirá para la red).MINUTOS_PARA_ACTUAR =30# lo que necesita el conductor para llegar a un punto de fríodef regla_umbral(x):"""1 si la última temperatura de la ventana es de 7 °C o más."""return (x[:, -1, 0] >=7.0).astype(int)def regla_tendencia(x):"""1 si el promedio de los últimos 30 minutos con la puerta cerrada pasa de 6 °C.""" alarmas = []for ventana in x[:, -30:, :]: # los últimos 30 minutos de cada ventana cerrada = ventana[:, 2] ==0 alarmas.append(int(cerrada.any() and ventana[cerrada, 0].mean() >6.0))return np.array(alarmas)def evaluar_por_viaje(alarma, parte):"""Convierte las alarmas por ventana en lo que ve la operación, viaje por viaje. Devuelve un resumen con las cuatro cifras del caso y el detalle de cada viaje. """ _, _, viaje, minuto_final = ventanas[parte] filas = []for numero, fila in informacion[parte].iterrows():# 1. El primer aviso del viaje: la primera ventana del viaje con alarma. avisos = minuto_final[(viaje == numero) & (alarma ==1)] primer_aviso =int(avisos[0]) iflen(avisos) >0elseNone# 2. La anticipación, solo si hubo excursión y hubo aviso. hubo_excursion =not pd.isna(fila.minuto_excursion) anticipacion =Noneif hubo_excursion and primer_aviso isnotNone: anticipacion = fila.minuto_excursion - primer_aviso filas.append( {"falla": fila.falla,"excursion": hubo_excursion,"aviso": primer_aviso,"anticipacion": anticipacion, } ) detalle = pd.DataFrame(filas)# 3. Las cuatro cifras de la operación. con_excursion = detalle[detalle.excursion] con_falla = detalle[detalle.falla] normales = detalle[~detalle.falla] resumen = {"excursiones": len(con_excursion),"avisadas_a_tiempo": int( (con_excursion.anticipacion >= MINUTOS_PARA_ACTUAR).sum() ),"fallas_avisadas": f"{con_falla.aviso.notna().sum()} de {len(con_falla)}","normales_con_alarma": f"{normales.aviso.notna().sum()} de {len(normales)}","anticipacion_mediana": con_excursion.anticipacion.median(), }return resumen, detallex_val = ventanas["val"][0]lineas_base = {"Regla de umbral (7 °C)": regla_umbral(x_val),"Regla de tendencia (6 °C, 30 min)": regla_tendencia(x_val),}display( pd.DataFrame( { nombre: evaluar_por_viaje(alarma, "val")[0]for nombre, alarma in lineas_base.items() } ).T)
excursiones
avisadas_a_tiempo
fallas_avisadas
normales_con_alarma
anticipacion_mediana
Regla de umbral (7 °C)
24
4
26 de 27
22 de 123
8.0
Regla de tendencia (6 °C, 30 min)
24
2
26 de 27
5 de 123
4.0
En los 150 viajes de validación, las dos reglas fallan justo donde importa:
La regla de umbral avisa 26 de 27 fallas, pero solo 4 de 24 excursiones con al menos 30 minutos de anticipación: la anticipación mediana es de 8 minutos. Además, suena en 22 de 123 viajes normales, uno de cada seis.
La regla de tendencia casi elimina las alarmas falsas (5 de 123), pero avisa todavía más tarde: 2 de 24 excursiones a tiempo, con 4 minutos de anticipación mediana.
Las dos reglas detectan la falla cuando la temperatura ya subió, y en ese punto falta muy poco para la excursión. Es lo que anticipaba el histograma: la falla temprana no se ve en la temperatura de un momento.
22.3.6 Diseño de la red
La red tiene que leer 120 minutos en orden y decidir si los ciclos recientes se ven como los de un compresor sano. Tres decisiones:
Una GRU, no una RNN simple. La señal de una falla temprana está en comparar los ciclos de hace una hora con los de ahora, a decenas de pasos de distancia. En el capítulo 20, la RNN simple dejó de recordar desde unas 20 palabras, y la LSTM y la GRU llegaron a 65 sin problema.
GRU en lugar de LSTM. Con la misma memoria, la GRU tiene 3 bloques de pesos frente a 4. Con tres datos de entrada y un problema de una sola salida, no hay razón para la celda más grande; si la GRU no bastara, la LSTM sería la siguiente prueba.
Un estado de 32 números y una sola capa. Es suficiente para resumir la forma de los ciclos, y mantiene la red pequeña: menos riesgo de memorizar los 400 viajes de entrenamiento y un entrenamiento de pocos minutos en CPU.
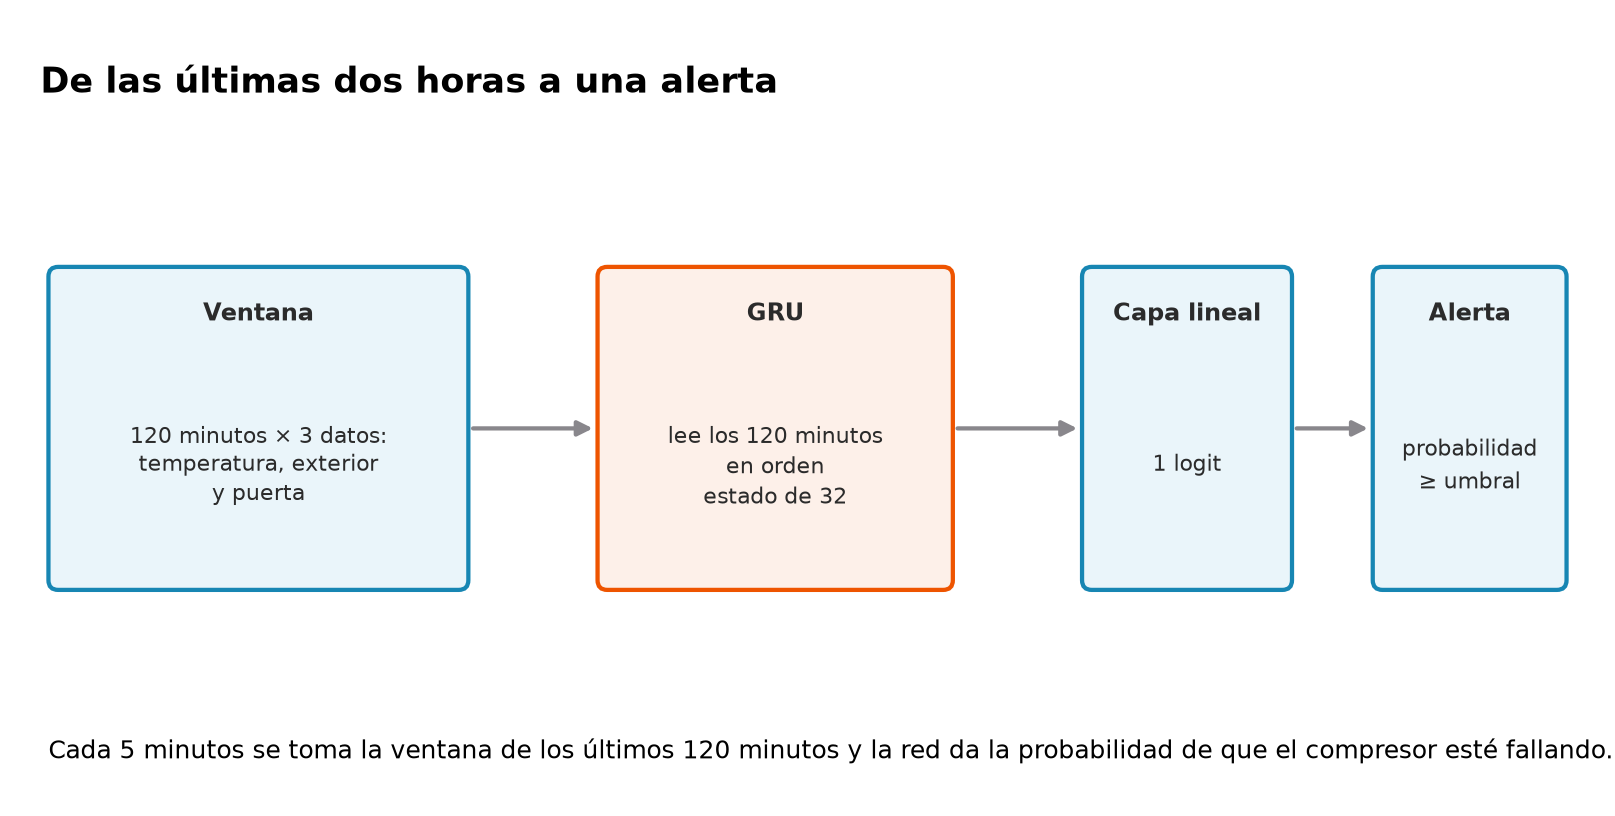
De las últimas dos horas a una alerta.
ImportanteAquí se arma la red del caso
La celda siguiente define DetectorDeFalla. La GRU recibe las ventanas con forma (N, 120, 3) y devuelve su último estado, de forma (1, N, 32). La capa lineal lo convierte en un solo logit por ventana: un número que la sigmoide convierte en la probabilidad de que el compresor esté fallando. No hay relleno, porque todas las ventanas miden exactamente 120 minutos, así que el último estado de la GRU es el de la última posición real.
# La red del caso: una GRU de una capa y una capa lineal.class DetectorDeFalla(nn.Module):def__init__(self, datos_por_minuto=3, estado=32):super().__init__()self.gru = nn.GRU(input_size=datos_por_minuto, hidden_size=estado, batch_first=True) # lee los 120 minutos en ordenself.salida = nn.Linear(estado, 1) # de la memoria (32 números) a 1 logitdef forward(self, ventanas): # ventanas: (N, 120, 3) _, estado_final =self.gru(ventanas) # estado_final: (1, N, 32)returnself.salida(estado_final[-1]).squeeze(1) # (N,): un logit por ventanatorch.manual_seed(SEMILLA)detector = DetectorDeFalla()print(detector)print("Parámetros:", sum(p.numel() for p in detector.parameters()))with torch.no_grad(): prueba_formas = detector(tensores["train"][0][:4])print("Salida para 4 ventanas:", tuple(prueba_formas.shape))
La red es muy pequeña: 3 585 parámetros. La GRU tiene 3 552 (3 bloques de 32 × 3 para la entrada, 3 bloques de 32 × 32 para el estado anterior y sus sesgos) y la capa lineal 33. Con 4 ventanas de entrada devuelve 4 logits, uno por ventana, que es la forma que espera la pérdida.
22.3.7 Entrenamiento
El entrenamiento usa la entropía cruzada binaria sobre el logit, Adam con una tasa de 0.003 y lotes de 128 ventanas. Se guarda el checkpoint de menor pérdida de validación, con un máximo de 40 épocas y una paciencia de 6. El bucle está escrito completo en la celda para que se vea cada paso.
# Entrena el detector con checkpoint de menor pérdida de validación y parada temprana.x_tr, y_tr = tensores["train"]x_va, y_va = tensores["val"]optimizador = torch.optim.Adam(detector.parameters(), lr=3e-3)generador = torch.Generator().manual_seed(SEMILLA) # orden de los lotes reproduciblehistorial, mejor_perdida, mejor_epoca, espera = [], float("inf"), 0, 0inicio = time.perf_counter()for epoca inrange(1, 41):# 1. Una pasada por los datos de entrenamiento, en lotes de 128 ventanas al azar. detector.train() orden = torch.randperm(len(x_tr), generator=generador)for i inrange(0, len(orden), 128): lote = orden[i : i +128] optimizador.zero_grad() perdida = F.binary_cross_entropy_with_logits(detector(x_tr[lote]), y_tr[lote]) perdida.backward() optimizador.step()# 2. Pérdida de entrenamiento y de validación con la red en modo de evaluación. detector.eval()with torch.no_grad(): perdida_tr = F.binary_cross_entropy_with_logits(detector(x_tr), y_tr).item() perdida_va = F.binary_cross_entropy_with_logits(detector(x_va), y_va).item() historial.append( {"epoca": epoca, "perdida_train": perdida_tr, "perdida_val": perdida_va} )# 3. Checkpoint y parada temprana.if perdida_va < mejor_perdida: mejor_perdida, mejor_epoca, espera = perdida_va, epoca, 0 torch.save(detector.state_dict(), ARTEFACTOS /"detector.pt")else: espera +=1if espera ==6:breaksegundos = time.perf_counter() - iniciodetector.load_state_dict( torch.load(ARTEFACTOS /"detector.pt")) # vuelve a la mejor versióndetector.eval()historial = pd.DataFrame(historial)en_el_limite ="sí"if mejor_epoca ==40else"no"print(f"Épocas: {len(historial)} · mejor época {mejor_epoca} "f"(¿en el límite de 40?: {en_el_limite})")print(f"Pérdida de validación {mejor_perdida:.4f} · {segundos:.0f} segundos")
Épocas: 26 · mejor época 20 (¿en el límite de 40?: no)
Pérdida de validación 0.0578 · 244 segundos
Figura 22.3: Pérdida de entrenamiento y de validación por época del detector
El entrenamiento se detuvo en la época 26 y conservó la versión de la época 20, con una entropía cruzada binaria de validación de 0.0578. Dentro de la red, el bucle tardó unos 4 minutos.
Las dos curvas bajan juntas de 0.16 a cerca de 0.06, con la caída más fuerte entre las épocas 5 y 6: es el momento en que la red aprende a distinguir los ciclos de una falla.
Entrenamiento y validación quedan casi pegados, así que la red no está memorizando los 400 viajes: lo que aprendió vale para viajes que no vio.
La mejor época no está en el límite de 40: la parada temprana cortó cuando la pérdida de validación dejó de mejorar durante 6 épocas.
22.3.8 Evaluación
La evaluación tiene dos niveles. Primero, por ventana, con las métricas del capítulo 10 y un umbral provisional de 0.5. Después, por viaje, con las cuatro cifras de la operación y en comparación con las dos reglas. Todo se mide en los 200 viajes de prueba, que no se usaron para nada hasta aquí.
# Probabilidad de falla de cada ventana de prueba y métricas por ventana con umbral 0.5.x_te, y_te = tensores["test"]with torch.no_grad(): probabilidad_test = torch.sigmoid(detector(x_te)).numpy()prediccion = (probabilidad_test >=0.5).astype(int)real = y_te.numpy().astype(int)print("Matriz de confusión (filas: real 0 y 1; columnas: predicho 0 y 1):")print(confusion_matrix(real, prediccion))print(f"Precisión {precision_score(real, prediccion):.3f}"f" · sensibilidad {recall_score(real, prediccion):.3f}"f" · F1 {f1_score(real, prediccion):.3f}")print(f"Exactitud de la red {np.mean(prediccion == real):.3f}"f" · exactitud de decir siempre «sin falla» {np.mean(real ==0):.3f}")
Matriz de confusión (filas: real 0 y 1; columnas: predicho 0 y 1):
[[16887    17]
 [  296  2200]]
Precisión 0.992 · sensibilidad 0.881 · F1 0.934
Exactitud de la red 0.984 · exactitud de decir siempre «sin falla» 0.871
Por ventana, con el umbral provisional de 0.5:
De 16 904 ventanas sin falla, solo 17 dan alarma. La precisión es de 0.992: cuando la red dice «falla», casi siempre la hay.
De 2 496 ventanas con falla, la red reconoce 2 200: una sensibilidad de 0.881. Las 296 que se le escapan son, sobre todo, los primeros minutos de cada falla, cuando todavía no hay señal.
La exactitud de 0.984 dice poco: decir siempre «sin falla» ya da 0.871. En un problema desequilibrado, la exactitud no es la medida para decidir.
# Las tres opciones por viaje en la prueba: dos reglas y la red con umbral 0.5.x_test = ventanas["test"][0]opciones_test = {"Regla de umbral (7 °C)": regla_umbral(x_test),"Regla de tendencia (6 °C, 30 min)": regla_tendencia(x_test),"Red GRU (umbral 0.5)": prediccion,}display( pd.DataFrame( { nombre: evaluar_por_viaje(alarma, "test")[0]for nombre, alarma in opciones_test.items() } ).T)
excursiones
avisadas_a_tiempo
fallas_avisadas
normales_con_alarma
anticipacion_mediana
Regla de umbral (7 °C)
43
5
43 de 47
23 de 153
7.0
Regla de tendencia (6 °C, 30 min)
43
4
43 de 47
3 de 153
5.0
Red GRU (umbral 0.5)
43
42
47 de 47
8 de 153
68.0
En los 200 viajes de prueba, la diferencia con las reglas es grande:
La red avisa a tiempo 42 de las 43 excursiones, con una anticipación mediana de 68 minutos. Las reglas avisan a tiempo 5 y 4, con 7 y 5 minutos de anticipación.
La red detecta las 47 fallas, también las que no llegan a excursión; las reglas, 43.
En viajes normales, la red suena en 8 de 153. Es más que la regla de tendencia (3), pero mucho menos que la regla actual (23).
El cambio es de fondo, no de grado. Las reglas reaccionan a la temperatura; la red reconoce la falla antes de que la temperatura suba, porque lee la forma de los ciclos durante dos horas.
22.3.9 De la predicción a la decisión de operación
El umbral de 0.5 es una convención, no una decisión de negocio. La empresa ya puso precio a cada error: 80 millones por una excursión sin aviso a tiempo y 300 mil por cada alarma. Con esas cifras se puede calcular el costo de cada umbral posible en validación y elegir el más barato. La prueba no se usa para elegir: solo para confirmar.
# 1. Probabilidades de validación.with torch.no_grad(): probabilidad_val = torch.sigmoid(detector(tensores["val"][0])).numpy()# 2. Costo de cada umbral: excursiones sin aviso a tiempo y alarmas de cualquier tipo.COSTO_EXCURSION, COSTO_ALARMA =80.0, 0.3# millones de pesosdef costo(resumen, detalle): sin_aviso_a_tiempo = resumen["excursiones"] - resumen["avisadas_a_tiempo"] alarmas = detalle.aviso.notna().sum() # una alarma por viaje, verdadera o falsareturn sin_aviso_a_tiempo * COSTO_EXCURSION + alarmas * COSTO_ALARMAumbrales = [0.05,0.10,0.20,0.30,0.40,0.50,0.60,0.70,0.80,0.90,0.95,0.97,0.99,] # más finos cerca de 1costos = [ costo(*evaluar_por_viaje((probabilidad_val >= u).astype(int), "val"))for u in umbrales]umbral_elegido = umbrales[int(np.argmin(costos))]print("Costo en validación por umbral (millones):", {u: round(float(c), 1) for u, c inzip(umbrales, costos)},)print(f"Umbral elegido en validación: {umbral_elegido} · costo {min(costos):.1f} millones")# 3. La curva, con el mínimo marcado.fig, ax = plt.subplots(figsize=(7.5, 3.6))ax.plot(umbrales, costos, "-o", color="#1786B3", ms=4)ax.plot( umbral_elegido,min(costos),"o", color="#EE5400", ms=10, label=f"mínimo: umbral {umbral_elegido}",)ax.set( xlabel="Umbral de la probabilidad de falla", ylabel="Costo en validación (millones de pesos)",)ax.legend(fontsize=8)fig.tight_layout()plt.show()
Figura 22.4: Costo total en los viajes de validación según el umbral de la red
La curva de 13 umbrales tiene una forma que hay que leer con cuidado:
Con umbrales de 0.4 o más, el costo en validación ronda los 88 a 93 millones: casi todo es una sola excursión que no se avisa a tiempo (80 millones). La red avisa ese viaje un poco tarde.
Con 0.3, la red alcanza a avisar ese viaje y el costo baja a 14.4 millones, aunque suena en más viajes normales. Por debajo de 0.3, las alarmas de más vuelven a subir el costo.
El umbral elegido es 0.3, pero la elección depende de un solo viaje de validación. Con 24 excursiones, cada una mueve el costo en 80 millones. Es una decisión frágil, y la prueba dirá si se sostiene.
# Confirma en la prueba: costo de las dos reglas y de la red# con el umbral elegido en validación.opciones_test["Red GRU (umbral elegido)"] = ( probabilidad_test >= umbral_elegido).astype(int)filas = {}for nombre, alarma in opciones_test.items(): resumen, detalle = evaluar_por_viaje(alarma, "test") filas[nombre] = {**resumen, "costo_millones": round(costo(resumen, detalle), 1)}comparacion = pd.DataFrame(filas).Tcomparacion.to_csv(ARTEFACTOS /"comparacion-prueba.csv")display(comparacion)
excursiones
avisadas_a_tiempo
fallas_avisadas
normales_con_alarma
anticipacion_mediana
costo_millones
Regla de umbral (7 °C)
43
5
43 de 47
23 de 153
7.0
3059.8
Regla de tendencia (6 °C, 30 min)
43
4
43 de 47
3 de 153
5.0
3133.8
Red GRU (umbral 0.5)
43
42
47 de 47
8 de 153
68.0
96.5
Red GRU (umbral elegido)
43
42
47 de 47
36 de 153
73.0
104.9
La prueba con 200 viajes confirma la ventaja de la red, y matiza la elección del umbral:
Las dos reglas cuestan más de 3 000 millones en los 200 viajes de prueba: dejan pasar 38 y 39 excursiones sin aviso a tiempo.
La red cuesta menos de 105 millones con cualquiera de los dos umbrales, unas 30 veces menos. En los dos casos se le escapa a tiempo una sola excursión de 43.
El umbral de 0.3 avisa un poco antes (73 minutos de anticipación mediana frente a 68), pero suena en 36 viajes normales frente a 8 con 0.5, y termina costando 104.9 millones frente a 96.5.
La lección práctica: el umbral que eligió la validación no fue el mejor en la prueba, porque lo decidió un solo viaje. Con tan pocas excursiones, la operación debería reunir más viajes de validación antes de fijarlo, o preferir un umbral en la zona estable de la curva (de 0.4 en adelante) y revisar ese viaje a mano. También hay un costo que el cálculo no ve: con 36 alarmas en 153 viajes normales, los operadores empezarían a desconfiar.
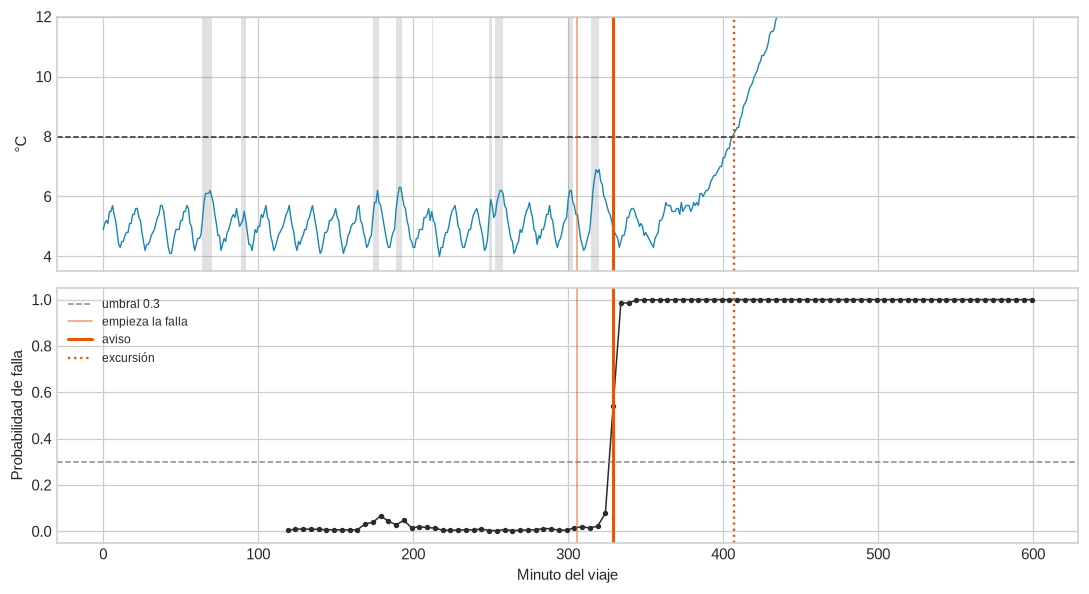
¿Cómo se ve eso en un viaje concreto? La gráfica siguiente muestra un viaje de prueba con falla: la temperatura, la probabilidad que da la red cada 5 minutos y el momento del aviso.
# 1. El primer viaje de prueba con falla y excursión.info_test = informacion["test"]numero =int(info_test.index[info_test.falla & info_test.minuto_excursion.notna()][0])tabla, fila = viajes["test"][numero], info_test.loc[numero]_, _, viaje_test, final_test = ventanas["test"]minutos = final_test[viaje_test == numero]probabilidades = probabilidad_test[viaje_test == numero]avisos = minutos[probabilidades >= umbral_elegido]aviso =int(avisos[0]) iflen(avisos) elseNoneanticipacion = fila.minuto_excursion - avisoprint(f"Viaje {numero} ({fila.ciudad}): empieza la falla en el minuto {fila.inicio_falla:.0f},"f" aviso en el {aviso}, excursión en el {fila.minuto_excursion:.0f}")print(f"Anticipación: {anticipacion:.0f} minutos")# 2. Temperatura arriba y probabilidad abajo, con las mismas marcas.fig, ejes = plt.subplots(2, 1, figsize=(10, 5.5), sharex=True)ejes[0].plot(tabla.minuto, tabla.temperatura, color="#1786B3", lw=0.9)for minuto in tabla.minuto[tabla.puerta ==1]: # aperturas de puerta en gris ejes[0].axvspan(minuto, minuto +1, color="#89878C", alpha=0.25, lw=0)ejes[0].axhline(simulador.LIMITE, color="#2B2B2B", ls="--", lw=1)ejes[0].set(ylabel="°C", ylim=(3.5, 12))ejes[1].plot(minutos, probabilidades, "-o", color="#2B2B2B", ms=2.5, lw=1)ejes[1].axhline( umbral_elegido, color="#89878C", ls="--", lw=1, label=f"umbral {umbral_elegido}")ejes[1].set( xlabel="Minuto del viaje", ylabel="Probabilidad de falla", ylim=(-0.05, 1.05))for eje in ejes: eje.axvline( fila.inicio_falla, color="#EE5400", lw=1, alpha=0.6, label="empieza la falla" ) eje.axvline(aviso, color="#EE5400", lw=2, label="aviso") eje.axvline( fila.minuto_excursion, color="#EE5400", ls=":", lw=1.5, label="excursión" )ejes[1].legend(loc="upper left", fontsize=8)fig.tight_layout()plt.show()
Viaje 0 (Barranquilla): empieza la falla en el minuto 306, aviso en el 329, excursión en el 407
Anticipación: 78 minutos
Figura 22.5: Un viaje de prueba con falla: temperatura, probabilidad de falla de la red y momento del aviso
El viaje 0 de prueba, en Barranquilla, muestra la diferencia en un caso concreto:
La falla empieza en el minuto 306, y durante 20 minutos la temperatura sigue en su rango normal, con una apertura de puerta entre los minutos 315 y 319.
La red avisa en el minuto 329: su probabilidad pasa de casi 0 a más de 0.5 en una sola consulta, y luego se queda cerca de 1.
La excursión empieza en el minuto 407: el aviso llegó 78 minutos antes, más del doble de los 30 que necesita el conductor.
La regla de 7 °C no habría sonado hasta el minuto 398, cuando la temperatura llegó a 7 °C: 9 minutos antes de la excursión.
Para usar la red en la operación hay que guardar todo lo que necesita para repetir exactamente lo que se hizo aquí: los pesos, la escala, el largo de la ventana, el paso y el umbral. La celda siguiente lo guarda y comprueba que la red recargada da las mismas probabilidades.
# Guarda pesos y metadatos, recarga y comprueba que la red da lo mismo.metadatos = {"largo_ventana": LARGO_VENTANA,"paso_minutos": PASO,"columnas": COLUMNAS,"media": media.tolist(),"desviacion": desviacion.tolist(),"umbral": umbral_elegido,"minutos_para_actuar": MINUTOS_PARA_ACTUAR,"mejor_epoca": mejor_epoca,}(ARTEFACTOS /"detector-metadatos.json").write_text( json.dumps(metadatos, indent=2, ensure_ascii=False), encoding="utf-8")copia = DetectorDeFalla()copia.load_state_dict(torch.load(ARTEFACTOS /"detector.pt"))copia.eval()cargados = json.loads( (ARTEFACTOS /"detector-metadatos.json").read_text(encoding="utf-8"))with torch.no_grad(): iguales = torch.equal( torch.sigmoid(copia(x_te[:500])), torch.sigmoid(detector(x_te[:500])) )print("Metadatos guardados:", list(cargados))print("¿Mismas probabilidades al recargar?", iguales)
El archivo de metadatos guarda las 8 piezas que necesita la operación: el largo de la ventana, el paso, las columnas, la media, la desviación, el umbral, los minutos para actuar y la mejor época. La red recargada da exactamente las mismas probabilidades en 500 ventanas de prueba. Sin la media y la desviación, los pesos solos no sirven, como muestra el primer error de la sección siguiente.
22.3.10 Errores frecuentes en este caso
Los tres errores siguientes se provocan a propósito con el detector ya entrenado.
# Error 1: pasar las ventanas sin escalar a la red entrenada con datos escalados.sin_escalar = torch.tensor(ventanas["test"][0], dtype=torch.float32)with torch.no_grad(): prediccion_mal = ( torch.sigmoid(detector(sin_escalar)).numpy() >= umbral_elegido ).astype(int)resumen_mal, _ = evaluar_por_viaje(prediccion_mal, "test")print(f"Sin escalar · F1 por ventana {f1_score(real, prediccion_mal):.3f}"f" · viajes normales con alarma {resumen_mal['normales_con_alarma']}")# Error 2: partir las ventanas al azar en lugar de partir por viaje.rng = np.random.default_rng(SEMILLA)_, _, viaje_tr, _ = ventanas["train"]orden = rng.permutation(len(viaje_tr))mitad_a, mitad_b = ( viaje_tr[orden[: len(orden) //2]], viaje_tr[orden[len(orden) //2 :]],)compartidos = np.intersect1d(mitad_a, mitad_b)print(f"\nPartición al azar de las ventanas de entrenamiento: {len(compartidos)} de "f"{len(np.unique(viaje_tr))} viajes quedan a los dos lados")# Error 3: juzgar por la exactitud por ventana.nunca = np.zeros_like(real)resumen_nunca, _ = evaluar_por_viaje(nunca, "test")print(f"\nDecir siempre «sin falla»: exactitud {np.mean(nunca == real):.3f}"f" · excursiones avisadas a tiempo {resumen_nunca['avisadas_a_tiempo']}")
Sin escalar · F1 por ventana 0.228 · viajes normales con alarma 153 de 153

Partición al azar de las ventanas de entrenamiento: 400 de 400 viajes quedan a los dos lados

Decir siempre «sin falla»: exactitud 0.871 · excursiones avisadas a tiempo 0
Los 3 errores no producen ningún mensaje; solo resultados equivocados:
Sin escalar, la red recibe temperaturas de 5 y exteriores de 30 en lugar de números cercanos a 0, y responde «falla» casi siempre: suena en 153 de 153 viajes normales, y el F1 por ventana cae a 0.228.
Con una partición al azar de las ventanas, los 400 viajes quedan a los dos lados. La red se evaluaría con ventanas que comparten casi todos sus minutos con otras que vio al entrenar.
Decir siempre «sin falla» tiene una exactitud de 0.871 y no avisa ninguna excursión. Cualquier medida que no distinga esos dos hechos sirve de poco para decidir.
Lo que ves
Qué pasó
Cómo se arregla
La red suena en casi todos los viajes, o en ninguno
Las ventanas llegaron sin escalar, o escaladas con otras cifras
Guardar la media y la desviación del entrenamiento con el modelo y aplicarlas siempre
Resultados excelentes en validación que no se repiten en la operación
Se partieron las ventanas al azar y el mismo viaje quedó en entrenamiento y en prueba
Partir por viaje (o por fecha), nunca por ventana
Una exactitud alta que no evita excursiones
La mayoría de las ventanas no tienen falla y la exactitud premia no avisar nunca
Medir por viaje: avisos a tiempo, alarmas falsas y costo
La red avisa justo cuando la temperatura pasa de 8 °C
La etiqueta marcaba la excursión y no el inicio de la falla
Etiquetar la causa (falla activa), no la consecuencia
El umbral que funcionó en las pruebas da otro costo en la operación
Se eligió con los datos de prueba, o cambiaron los costos
Elegir el umbral en validación y recalcularlo si cambian los costos
22.3.11 Conclusiones del caso
La red cambió la forma de vigilar la cadena de frío. Las dos reglas reaccionan a la temperatura, y para cuando la temperatura sube quedan de 5 a 8 minutos antes de la excursión. La GRU, que lee dos horas de ciclos del termostato junto con las aperturas de puerta, reconoció las fallas cuando la temperatura todavía se veía normal: avisó a tiempo 42 de 43 excursiones de prueba, con una anticipación mediana de más de una hora, y redujo el costo de más de 3 000 millones a menos de 105. Con una red de 3 585 parámetros, que entrena en unos minutos en una CPU.
El caso también deja advertencias. El umbral elegido en validación dependió de un solo viaje y no fue el mejor en la prueba. La red no puede anticipar excursiones que no vengan de una falla del compresor, como la de la entrega muy larga. Y todo lo aprendido viene de un simulador: con datos reales habría sensores que fallan, viajes más largos o cortos y otros tipos de daño.
¿Qué se lleva el lector de este caso? Que el trabajo con una red recurrente empieza mucho antes de la red: entender qué quiere la operación (avisar con 30 minutos, no clasificar ventanas), definir la etiqueta como la causa y no la consecuencia, partir por viaje para no engañarse, compararse con las reglas que ya existen y medir en pesos y minutos. La GRU fue la pieza que hizo posible la anticipación, pero fueron esas decisiones las que hicieron que el resultado sirva.
Límites del caso: los datos son sintéticos y las reglas físicas, sencillas; solo hay un tipo de falla; los costos son ficticios; y la validación tiene pocas excursiones, lo que vuelve inestable la elección del umbral. Antes de usar algo así con medicamentos reales, haría falta validarlo con registros reales de la flota y con el área de calidad.
22.3.12 Ejercicios del caso
En el análisis descriptivo, ¿por qué la regla de 7 °C no puede funcionar bien, aunque se mueva el umbral a 6.5 o a 7.5 °C?
Cambia LARGO_VENTANA a 60 minutos. Antes de ejecutar, predice qué pasará con la anticipación y con las alarmas falsas, y explica por qué.
Quita la columna de la puerta (deja solo temperatura y exterior). ¿Qué esperas que pase con las alarmas en viajes normales?
Si el costo de una carga perdida bajara a 20 millones, ¿el umbral elegido subiría o bajaría? ¿Por qué?
Cambia la GRU por una LSTM del mismo tamaño. ¿Cuántos parámetros tendría? ¿Esperas un cambio grande en el resultado?
La empresa quiere usar el mismo detector en furgones de congelados (−18 °C). ¿Qué tendría que cambiar antes de usarlo?
TipOrientaciones
Porque las aperturas de puerta en viajes normales y las fallas tempranas alcanzan temperaturas parecidas, como mostró el histograma. Subir el umbral reduce las alarmas falsas, pero avisa más tarde; bajarlo avisa antes, pero suena en muchas entregas. Una sola temperatura no distingue la causa.
Con 60 minutos, la red ve menos ciclos para comparar. Es probable que tarde más en reconocer las fallas que avanzan despacio (menos anticipación) o que confunda más entregas seguidas con fallas. Compruébalo con el costo en validación.
Sin la puerta, la red no sabe si una subida viene de una entrega. Lo esperable es más alarmas en viajes normales o un umbral más alto que avise más tarde.
Subiría: con una excursión más barata, cada alarma pesa más en el costo total, y conviene avisar solo cuando la red está más segura.
Una LSTM con 3 entradas y 32 de estado tiene 4 × (32 × 3 + 32 × 32 + 2 × 32) = 4 736 parámetros en la celda, frente a 3 552 de la GRU. Con un problema de este tamaño, lo esperable es un resultado parecido; la elección se haría con el costo en validación.
Todo lo que depende de la temperatura: el simulador (o datos reales de esos furgones), la escala, la definición de excursión y los costos. Los pesos de la red están ajustados a ciclos alrededor de 5 °C y no sirven sin reentrenar.
22.3.13 El simulador del caso
Este es el contenido de simulador_frio.py. No necesitas leerlo para seguir el caso; está aquí para quien quiera ver las reglas con que se fabricaron los viajes.
TipVer el código de simulador_frio.py
"""Simulador de viajes refrigerados de BITLogística (datos sintéticos).Lo usa solo el Caso práctico 1 del capítulo. Genera, minuto a minuto, lo que registraríael sensor de un furgón que reparte medicamentos que deben viajar entre 2 y 8 °C:la temperatura dentro del furgón, la temperatura exterior y si la puerta está abierta.Reglas de la simulación (todas las cifras son inventadas, con órdenes de magnitud plausibles):1. El termostato mantiene el furgón cerca de 5 °C: el compresor se enciende al llegar a 5.6 °C y se apaga al bajar a 4.4 °C. Por eso la temperatura sube y baja en ciclos.2. Por las paredes entra calor en proporción a la diferencia con el exterior, que depende de la ciudad y de la hora del día.3. En cada entrega la puerta se abre de 1 a 6 minutos y entra calor de golpe; después el compresor lo recupera.4. En el 20 % de los viajes el compresor empieza a fallar en un minuto al azar: pierde potencia poco a poco y, cuando ya no alcanza, la temperatura sube sin parar.5. El sensor tiene un ruido pequeño y redondea a 0.1 °C, como uno real.6. La carga se compromete con una **excursión**: más de 10 minutos seguidos por encima de 8 °C."""import numpy as npimport pandas as pd# Temperatura exterior media y amplitud entre el día y la noche, en °C.CIUDADES = {"Bogotá": (14, 5), "Medellín": (22, 5), "Cali": (24, 5),"Bucaramanga": (24, 5), "Barranquilla": (29, 4), "Cartagena": (29, 3),}DURACION =600# minutos por viaje (10 horas de reparto)ENCENDER, APAGAR =5.6, 4.4# el termostato enciende y apaga el compresorLIMITE =8.0# temperatura máxima permitida para la cargaMINUTOS_EXCURSION =10# minutos seguidos por encima del límite que la comprometenPROBABILIDAD_FALLA =0.2# fracción de viajes en que el compresor empieza a fallardef simular_viaje(rng):"""Simula un viaje de 600 minutos. Devuelve dos cosas: - una tabla con una fila por minuto: temperatura, exterior y puerta (1 = abierta); - un diccionario con la información del viaje: ciudad, hora de salida, entregas, si el compresor falla, en qué minuto empieza la falla y en qué minuto empieza la excursión (o ``None`` si no hay). """# 1. Ciudad, hora de salida y temperatura exterior de cada minuto. ciudad =list(CIUDADES)[int(rng.integers(0, len(CIUDADES)))] media, amplitud = CIUDADES[ciudad] salida =int(rng.integers(5*60, 9*60)) # entre las 5 y las 9 de la mañana hora = (salida + np.arange(DURACION)) /60# hora del día de cada minuto exterior = media + amplitud * np.sin((hora -9) /24*2* np.pi) # más calor al mediodía exterior = exterior + rng.normal(0, 0.3, DURACION) # pequeñas variaciones# 2. Entregas: entre 6 y 15 paradas, con la puerta abierta de 1 a 6 minutos en cada una. puerta = np.zeros(DURACION) paradas = rng.choice(np.arange(20, DURACION -10), size=int(rng.integers(6, 16)), replace=False)for parada in paradas: puerta[parada:parada +int(rng.integers(1, 7))] =1# 3. Características del furgón y, si falla, cuándo empieza y qué tan rápido pierde potencia. aislamiento = rng.uniform(0.006, 0.010) # fracción del calor que entra por minuto potencia_nominal = rng.uniform(0.40, 0.50) # °C que enfría por minuto encendido falla =bool(rng.random() < PROBABILIDAD_FALLA) inicio_falla =int(rng.integers(150, 520)) if falla elseNone perdida = rng.uniform(0.004, 0.012) # fracción de potencia que pierde por minuto# 4. Minuto a minuto: entra calor, el termostato decide y el compresor enfría. temperatura = np.zeros(DURACION) t = rng.uniform(4.5, 5.5) # temperatura al salir encendido =Falsefor minuto inrange(DURACION): potencia = potencia_nominalif falla and minuto >= inicio_falla: # la potencia baja con el tiempo minutos_fallando = minuto - inicio_falla potencia =max(0.0, potencia_nominal * (1- perdida * minutos_fallando))if t >= ENCENDER: encendido =Trueelif t <= APAGAR: encendido =False calor_paredes = aislamiento * (exterior[minuto] - t) calor_puerta =0.02* puerta[minuto] * (exterior[minuto] - t) # solo con la puerta abierta t = t + calor_paredes + calor_puerta - (potencia if encendido else0.0) temperatura[minuto] = t# 5. Lo que registra el sensor: un poco de ruido y redondeo a 0.1 °C. sensor = np.round(temperatura + rng.normal(0, 0.08, DURACION), 1)# 6. Excursión: primer minuto de un tramo de 10 minutos seguidos por encima de 8 °C. minuto_excursion =None seguidos =0for minuto inrange(DURACION): seguidos = seguidos +1if temperatura[minuto] > LIMITE else0if seguidos == MINUTOS_EXCURSION: minuto_excursion = minuto - MINUTOS_EXCURSION +1break tabla = pd.DataFrame({"minuto": np.arange(DURACION), "temperatura": sensor,"exterior": np.round(exterior, 1), "puerta": puerta.astype(int)}) informacion = {"ciudad": ciudad, "salida": f"{salida //60:02d}:{salida %60:02d}","entregas": len(paradas), "falla": falla, "inicio_falla": inicio_falla,"minuto_excursion": minuto_excursion}return tabla, informaciondef simular_flota(n_viajes, semilla):"""Simula ``n_viajes`` viajes con una semilla fija. Devuelve la lista de tablas minuto a minuto y una tabla con una fila por viaje. """ rng = np.random.default_rng(semilla) viajes, filas = [], []for numero inrange(n_viajes): tabla, informacion = simular_viaje(rng) viajes.append(tabla) filas.append({"viaje": numero, **informacion})return viajes, pd.DataFrame(filas)
22.4 Caso práctico 2: Estimar cuánto falta para que llegue el envío
AdvertenciaEmpresa y datos ficticios
BITLogística es una empresa ficticia. Las rutas, las velocidades y los tiempos de entrega de este caso se generan con un simulador del propio caso (simulador_rutas.py) y no corresponden a BIT ni a ningún transportador. Las reglas del simulador están explicadas en la sección de datos y su código completo está al final del caso.
La red de este caso: una LSTM. La LSTM es la red recurrente con memoria más conocida: además de lo que acaba de leer, guarda una memoria de largo plazo que puede mantener sin cambios durante muchos pasos, y en cada momento decide qué guardar, qué borrar y qué usar. Se usa principalmente cuando lo que pasó hace un rato sigue importando: pronósticos, tiempos de viaje, reconocimiento de voz o de texto. En este caso se basa en la última media hora del GPS del vehículo (qué tan rápido va, cuánto tardó en las últimas entregas, si está atrapado en un trancón) y combina ese resumen con lo que dice el plan de la ruta para estimar cuántos minutos faltan.
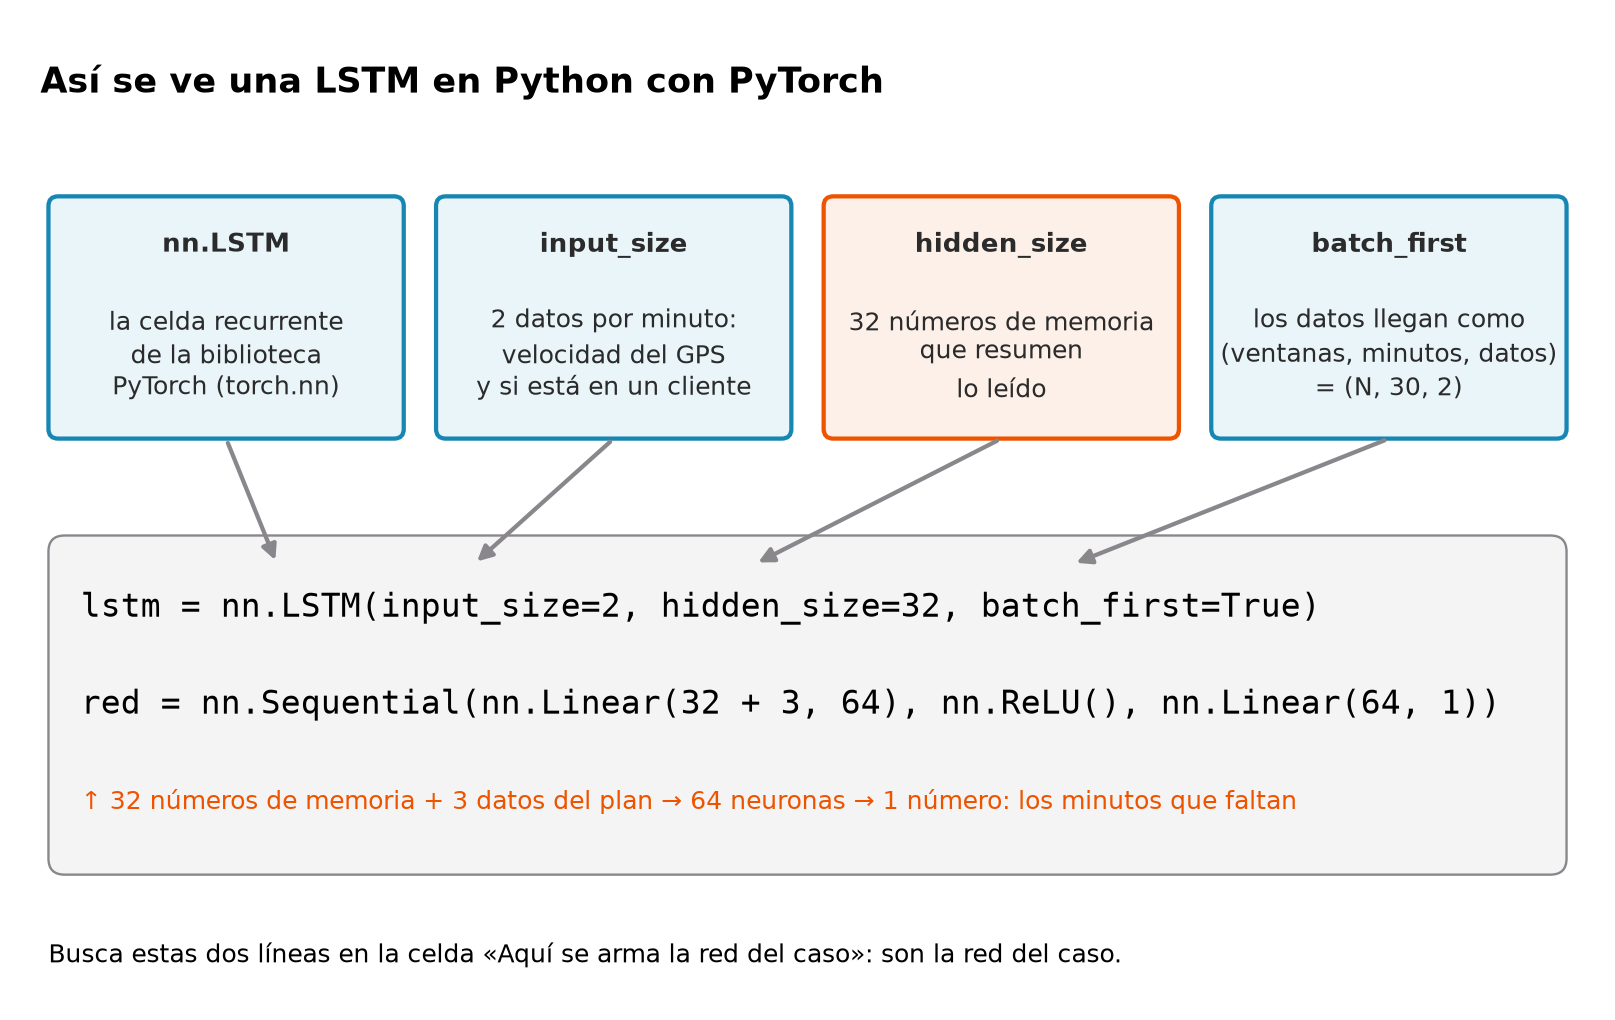
Cómo se ve en Python. Igual que la GRU del caso anterior, la LSTM viene lista en PyTorch, dentro del módulo torch.nn, y se crea con una sola línea. Esa línea es casi la misma del caso 1: cambia nn.GRU por nn.LSTM, y los tres parámetros significan lo mismo:
input_size=2: cuántos datos llegan en cada paso. Aquí son dos por minuto: la velocidad del GPS y si el vehículo está detenido en un cliente.
hidden_size=32: el tamaño de la memoria, los 32 números con que la red resume la última media hora.
batch_first=True: el orden en que llegan los datos: primero las consultas, después los 30 minutos y al final los 2 datos de cada minuto.
La segunda línea sí cambia respecto al caso 1. La parte densa no recibe solo la memoria: nn.Linear(32 + 3, 64) recibe los 32 números de la LSTM más los 3 datos del plan de la ruta (kilómetros que faltan, paradas antes del cliente y hora del día) y los pasa por 64 neuronas; nn.ReLU() les permite combinarse de forma no lineal y nn.Linear(64, 1) entrega un solo número: los minutos que faltan. nn.Sequential encadena las tres piezas en ese orden. Cuando llegues a la sección «Diseño de la red», encontrarás las dos líneas dentro de EstimadorETA; allí el 32 aparece con el nombre estado.
Las dos líneas que crean la red del caso y qué significa cada parámetro.
22.4.1 El problema en la operación
Cada mañana, los conductores de BITLogística en Bogotá salen con 20 a 30 paquetes para entregar en una ruta planeada. Los clientes reciben un mensaje en el celular: «Su pedido llegará entre las 10:20 y las 10:50». Si el conductor llega fuera de esa ventana, el cliente puede no estar, el paquete vuelve a la bodega y hay que repetir la entrega, con su costo y con un cliente molesto.
NotaTiempo estimado de llegada (ETA)
El tiempo estimado de llegada (ETA, por estimated time of arrival) es la predicción de cuántos minutos faltan para que el vehículo llegue a un destino. Es la cifra detrás de los mensajes de «su pedido llega en…» de las aplicaciones de reparto y transporte.
Hoy el ETA sale de una regla de la operación: la distancia que falta, a 20 km/h, más 5 minutos por cada parada intermedia. Es fácil de explicar, pero no sabe nada de lo que está pasando: si hay un trancón, si el conductor de hoy entrega más despacio o si es hora pico. Para cumplir las ventanas, la empresa tiene que anunciarlas anchas, y un cliente que espera una ventana de una hora tampoco queda contento.
La pregunta del caso: ¿puede una red recurrente que lee la última media hora del GPS del vehículo estimar mejor cuánto falta para llegar a cada uno de los próximos cinco clientes, y permitir ventanas más estrechas que se sigan cumpliendo?
22.4.2 Los datos
El caso usa un simulador con reglas sencillas, que el lector puede revisar al final:
El plan: cada ruta sale entre las 7 y las 9 de la mañana, con 20 a 30 paradas separadas en promedio por 1.8 km.
La hora: en las horas pico (7 a 9 y 17 a 19) la ciudad va al 65 % de la velocidad normal.
El conductor: cada uno tiene su propio ritmo, de manejo y de entrega.
Los trancones: en cada ruta hay de 2 a 4, de 20 a 50 minutos cada uno, en que la velocidad cae a un tercio. Desde el GPS se nota que está pasando, pero no cuándo termina.
Las entregas: unos 5 minutos por cliente; en los edificios con recepción, de 10 a 15.
El GPS: reporta la velocidad cada minuto, con algo de ruido, y a veces 0 por un semáforo.
Se simulan 300 rutas para entrenar, 100 para validar y 150 para la prueba final, cada grupo con su semilla. Como en el caso anterior, se parte por ruta: las consultas de una misma ruta comparten minutos de GPS, y no pueden quedar repartidas entre entrenamiento y prueba.
La primera celda del caso prepara sus herramientas; la segunda simula las rutas.
# Caso práctico 2 · Configuración: herramientas, semilla y carpeta de resultados del caso.from pathlib import Pathimport jsonimport platformimport timeimport matplotlibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport torchfrom torch import nnfrom torch.nn import functional as Ffrom IPython.display import displayimport simulador_rutas as simulador # el simulador solo de este casoSEMILLA =42np.random.seed(SEMILLA)torch.manual_seed(SEMILLA)torch.set_num_threads(2)ARTEFACTOS = Path("artefactos_pytorch") /"caso2"ARTEFACTOS.mkdir(parents=True, exist_ok=True)plt.style.use("seaborn-v0_8-whitegrid")plt.rcParams.update({"figure.dpi": 110, "font.size": 10})print({"python": platform.python_version(), "torch": torch.__version__,"numpy": np.__version__, "pandas": pd.__version__,"matplotlib": matplotlib.__version__, "dispositivo": "cpu", "semilla": SEMILLA})
El caso usa el mismo entorno del Caso práctico 1: Python 3.13.16, PyTorch 2.14.1, NumPy 2.5.4, pandas 3.1.0 y matplotlib 3.11.2 en una CPU.
# Simula las rutas de los tres conjuntos, cada uno con su semilla.gps, paradas = {}, {}for parte, n_rutas, semilla in [("train", 300, 1), ("val", 100, 2), ("test", 150, 3)]: gps[parte], paradas[parte] = simulador.simular_rutas(n_rutas, semilla)for parte in gps: n_paradas = [len(p) for p in paradas[parte]] duracion = [len(g) for g in gps[parte]]print(f"{parte:<5}{len(gps[parte]):>3} rutas · paradas por ruta de {min(n_paradas)} a "f"{max(n_paradas)} · duración media {np.mean(duracion) /60:.1f} horas")print("\nPrimeros minutos de una ruta (lo que reporta el GPS):")display(gps["train"][0].head(4))print("Primeras paradas de la misma ruta:")display(paradas["train"][0].head(3))
train 300 rutas · paradas por ruta de 20 a 30 · duración media 5.9 horas
val   100 rutas · paradas por ruta de 20 a 30 · duración media 5.8 horas
test  150 rutas · paradas por ruta de 20 a 30 · duración media 5.7 horas

Primeros minutos de una ruta (lo que reporta el GPS):
minuto
hora
velocidad
en_cliente
proxima_parada
km_a_la_proxima
en_trancon
0
0
7.933
16.4
0
0
2.289
0
1
1
7.950
19.8
0
0
1.958
0
2
2
7.967
17.2
0
0
1.687
0
3
3
7.983
0.0
0
0
1.687
0
Primeras paradas de la misma ruta:
parada
distancia_km
edificio
llegada
0
0
2.55
True
9
1
1
0.63
False
24
2
2
2.08
True
41
Los 3 conjuntos son parecidos, y cada tabla muestra lo que tiene la operación:
Las rutas tienen de 20 a 30 paradas y duran en promedio entre 5.7 y 5.9 horas, de la salida a la última entrega.
El GPS da una fila por minuto: la hora, la velocidad (en el minuto 3 marca 0, un semáforo), si está en un cliente, la próxima parada y los km que le faltan para llegar a ella. La columna en_trancon existe solo para dibujar; ninguna alternativa la usa.
La tabla de paradas dice cuánto mide cada tramo y a qué minuto llegó: la primera parada, un edificio a 2.55 km, se alcanzó en el minuto 9, y la tercera, en el 41.
22.4.3 Análisis descriptivo
Primero, cómo se ve una ruta: la velocidad minuto a minuto, las entregas y los trancones.
# Dibuja las primeras 240 minutos de la primera ruta de entrenamiento.ruta = gps["train"][0].iloc[:240]fig, ax = plt.subplots(figsize=(10, 3.8))ax.plot(ruta.minuto, ruta.velocidad, color="#1786B3", lw=0.9, label="velocidad del GPS")for minuto in ruta.minuto[ruta.en_cliente ==1]: # gris: entregando ax.axvspan(minuto, minuto +1, color="#89878C", alpha=0.3, lw=0)for minuto in ruta.minuto[ruta.en_trancon ==1]: # naranja: trancón (solo para dibujar) ax.axvspan(minuto, minuto +1, color="#EE5400", alpha=0.15, lw=0)ax.set(xlabel="Minuto de la ruta", ylabel="km/h")ax.plot([], [], color="#89878C", alpha=0.6, lw=6, label="entregando") # entradas de la leyendaax.plot([], [], color="#EE5400", alpha=0.3, lw=6, label="trancón")ax.set(ylim=(-1, 40))ax.legend(loc="upper center", ncol=3, fontsize=8, frameon=True)fig.tight_layout()plt.show()
Figura 22.6: Las primeras cuatro horas de una ruta: velocidad del GPS, entregas y trancones
En las primeras 4 horas de esta ruta se ven las tres fuentes de variación:
16 entregas, en gris, de las que 4 son edificios: las franjas más anchas, de 10 a 15 minutos.
Un trancón entre los minutos 103 y 143, en naranja: la velocidad cae de 20 a 30 km/h a unos 9 km/h durante 41 minutos.
Los ceros sueltos son semáforos: el vehículo está detenido, pero no en un cliente. La columna de entrega permite distinguirlos.
Segundo, de qué depende el tiempo entre una parada y la siguiente. La celda siguiente mide, en las rutas de entrenamiento, la velocidad mientras el vehículo se mueve según la hora, y el tiempo de entrega según el tipo de parada.
# 1. Velocidad media mientras se mueve (sin contar minutos en cero), en hora pico y fuera de ella.moviendo = pd.concat(gps["train"]).query("en_cliente == 0 and velocidad > 0")pico = moviendo.hora.between(7, 9, inclusive="left") | moviendo.hora.between(17, 19, inclusive="left")print(f"Velocidad media en hora pico {moviendo.velocidad[pico].mean():.1f} km/h · "f"fuera de hora pico {moviendo.velocidad[~pico].mean():.1f} km/h")print(f"En trancón {moviendo.velocidad[moviendo.en_trancon ==1].mean():.1f} km/h")# 2. Minutos detenido en cada entrega: casa o local frente a edificio con recepción.entregas = []for g, p inzip(gps["train"], paradas["train"]):for fila in p.itertuples(): minutos_en_cliente = ((g.proxima_parada == fila.parada) & (g.en_cliente ==1)).sum() entregas.append({"edificio": fila.edificio, "minutos": minutos_en_cliente})entregas = pd.DataFrame(entregas)print("\nMinutos de entrega:")print(entregas.groupby("edificio").minutos.describe()[["count", "mean", "25%", "50%", "75%"]] .rename(index={False: "casa o local", True: "edificio"}).round(1).to_string())
Velocidad media en hora pico 13.2 km/h · fuera de hora pico 18.7 km/h
En trancón 7.4 km/h

Minutos de entrega:
               count  mean   25%   50%   75%
edificio
casa o local  6056.0   5.3   4.0   5.0   6.0
edificio      1479.0  12.7  11.0  13.0  14.0
Las 3 velocidades y los 2 tiempos de entrega confirman las reglas del simulador y muestran por qué la regla actual se equivoca:
En hora pico, el vehículo va a 13.2 km/h mientras se mueve; fuera de ella, a 18.7 km/h; en un trancón, a 7.4 km/h. La regla actual supone 20 km/h siempre, y además el vehículo pasa varios minutos en cero por los semáforos.
Una entrega en casa o local dura 5.3 minutos en promedio; en un edificio, 12.7. La regla actual supone 5 minutos por parada, así que se queda corta cuando hay edificios en el camino.
Ninguna de estas cosas está en el plan de la ruta, salvo la hora. El ritmo del conductor y los trancones solo se pueden ver en el GPS.
22.4.4 Preparación de los datos
El ETA se calcula en la operación cada 5 minutos para los próximos clientes. Cada cálculo es una consulta con tres partes, y cada una se justifica por lo que mostró el análisis:
El objetivo: los minutos que faltan para llegar al cliente, que el simulador conoce porque registró el minuto de llegada a cada parada.
La secuencia: los últimos 30 minutos del GPS, con dos datos por minuto: la velocidad (dividida por 30 para dejarla cerca de 0 a 1) y si estaba detenido en un cliente. Media hora alcanza para ver si hay un trancón y desde cuándo, y para ver el ritmo de las últimas dos o tres entregas del conductor.
El plan: tres datos que la operación ya conoce sin ninguna red: los kilómetros que faltan hasta ese cliente por la ruta planeada, cuántas paradas hay antes de él y la hora del día.
Se calculan consultas para los 5 próximos clientes, porque esos son los que reciben mensaje. La celda siguiente las construye con un bucle sencillo, ruta por ruta.
# Construye las consultas: cada 5 minutos, para cada uno de los 5 próximos clientes.MINUTOS_GPS =30# minutos de GPS que ve la redCADA =5# cada cuántos minutos se recalcula el ETACLIENTES =5# cuántos clientes reciben el mensajedef construir_consultas(lista_gps, lista_paradas):"""Devuelve secuencias, datos del plan, minutos que faltan y descripción de cada consulta.""" secuencias, plan, faltan, detalle = [], [], [], []for numero, (g, p) inenumerate(zip(lista_gps, lista_paradas)): velocidad = g.velocidad.to_numpy(dtype=np.float32) /30 en_cliente = g.en_cliente.to_numpy(dtype=np.float32)for t inrange(MINUTOS_GPS -1, len(g), CADA):# 1. Los clientes que todavía no ha visitado, en orden de la ruta. pendientes = p[p.llegada > t]iflen(pendientes) ==0:break# 2. Lo último del GPS: 30 minutos con 2 datos por minuto. ultimos = np.stack([velocidad[t - MINUTOS_GPS +1: t +1], en_cliente[t - MINUTOS_GPS +1: t +1]], axis=1) # (30, 2)for k, cliente inenumerate(pendientes.itertuples()):if k == CLIENTES:break# 3. Kilómetros hasta ese cliente: lo que falta del tramo actual y los tramos siguientes. tramos = pendientes.distancia_km.to_numpy()[: k +1].copy()if g.proxima_parada[t] == pendientes.parada.iloc[0] and g.en_cliente[t] ==0: tramos[0] = g.km_a_la_proxima[t] # va en camino al primero secuencias.append(ultimos) plan.append([tramos.sum(), k, g.hora[t]]) # km, paradas antes, hora faltan.append(cliente.llegada - t) detalle.append({"ruta": numero, "minuto": t, "parada": cliente.parada, "k": k +1})return (np.stack(secuencias), np.array(plan, dtype=np.float32), np.array(faltan, dtype=np.float32), pd.DataFrame(detalle))consultas = {parte: construir_consultas(gps[parte], paradas[parte]) for parte in gps}for parte, (sec, pl, y, det) in consultas.items():print(f"{parte:<5}{len(y):>6} consultas · secuencias {sec.shape} · minutos que faltan: "f"mediana {np.median(y):.0f}, 90 % por debajo de {np.percentile(y, 90):.0f}")
train  87803 consultas · secuencias (87803, 30, 2) · minutos que faltan: mediana 34, 90 % por debajo de 67
val    28853 consultas · secuencias (28853, 30, 2) · minutos que faltan: mediana 33, 90 % por debajo de 66
test   42178 consultas · secuencias (42178, 30, 2) · minutos que faltan: mediana 33, 90 % por debajo de 66
Las consultas de los 3 conjuntos quedan listas:
Entrenamiento: 87 803 consultas, cada una con una secuencia de 30 minutos y 2 datos por minuto. Validación y prueba tienen 28 853 y 42 178.
El tiempo que falta tiene una mediana de 33 a 34 minutos, y el 90 % de las consultas está por debajo de 66 a 67 minutos: el próximo cliente suele estar a minutos, y el quinto, a una hora.
Cada conjunto viene de sus propias rutas, así que ninguna consulta de prueba comparte minutos de GPS con una de entrenamiento.
Los tres datos del plan tienen escalas muy distintas (kilómetros, paradas y horas), así que se escalan con la media y la desviación del entrenamiento, que se guardan para la operación.
# Escala los datos del plan con media y desviación del entrenamiento._, plan_train, _, _ = consultas["train"]media_plan, desviacion_plan = plan_train.mean(axis=0), plan_train.std(axis=0)NOMBRES_PLAN = ["km_que_faltan", "paradas_antes", "hora"]print("Media: ", {n: round(float(v), 2) for n, v inzip(NOMBRES_PLAN, media_plan)})print("Desviación:", {n: round(float(v), 2) for n, v inzip(NOMBRES_PLAN, desviacion_plan)})tensores = {}for parte, (sec, pl, y, _) in consultas.items(): tensores[parte] = (torch.tensor(sec), torch.tensor((pl - media_plan) / desviacion_plan), torch.tensor(y))print("Formas de entrenamiento:", [tuple(t.shape) for t in tensores["train"]])
La escala sale de las 87 803 consultas de entrenamiento:
Km que faltan: media de 4.96 y desviación de 3.11.
Paradas antes del cliente: media de 1.91 y desviación de 1.41 (de 0 a 4).
Hora: media de 10.89, es decir, cerca de las 10:53, con una desviación de 1.67 horas.
Formas: las secuencias son (87 803, 30, 2), el plan (87 803, 3) y el objetivo (87 803,).
22.4.5 Una línea base sin red neuronal
El caso compara la red con tres alternativas, de la más simple a la más cercana:
Regla actual: km que faltan a 20 km/h, más 5 minutos por cada parada antes del cliente.
Regla con velocidad reciente: lo mismo, pero con la velocidad media de los minutos en movimiento de la última media hora en lugar de 20 km/h. Es lo primero que intentaría un analista para tener en cuenta los trancones.
Red densa solo con el plan: una red pequeña que recibe los tres datos del plan, sin el GPS. Sirve para medir cuánto aporta, por sí sola, la secuencia del GPS.
NotaError absoluto medio
El error absoluto medio (MAE, por mean absolute error) es el promedio de las diferencias, sin signo, entre lo estimado y lo real. Aquí se mide en minutos: un MAE de 8 significa que el ETA se equivoca, en promedio, por 8 minutos. Es más fácil de explicar en la operación que la raíz del MSE y pesa menos los casos raros, como una entrega que se demora mucho.
Además del MAE, se cuenta qué proporción de los ETA cae a 10 minutos o menos de la llegada real, una forma directa de ver cuántos clientes recibirían una hora creíble.
# Las dos reglas, evaluadas en las consultas de validación.def regla_actual(secuencia, plan): km, paradas_antes = plan[:, 0], plan[:, 1]return km /20*60+ paradas_antes *5# minutosdef regla_velocidad_reciente(secuencia, plan): estimaciones = []for ultimos, (km, paradas_antes, _) inzip(secuencia, plan): moviendo = ultimos[:, 1] ==0# minutos sin estar en un cliente velocidad = ultimos[moviendo, 0].mean() *30if moviendo.any() else20.0 velocidad =max(velocidad, 5.0) # evita dividir por casi cero estimaciones.append(km / velocidad *60+ paradas_antes *5)return np.array(estimaciones)def resumen(estimado, real): error = np.abs(estimado - real)return {"mae_minutos": round(float(error.mean()), 2),"dentro_de_10_min": round(float(np.mean(error <=10)), 3)}secuencia_val, plan_val, real_val, _ = consultas["val"]display(pd.DataFrame({"Regla actual": resumen(regla_actual(secuencia_val, plan_val), real_val),"Regla con velocidad reciente": resumen(regla_velocidad_reciente(secuencia_val, plan_val), real_val)}).T)
mae_minutos
dentro_de_10_min
Regla actual
11.34
0.563
Regla con velocidad reciente
10.83
0.595
En las 28 853 consultas de validación, las dos reglas quedan parecidas:
La regla actual se equivoca en 11.34 minutos en promedio, y solo el 56.3 % de sus ETA cae a 10 minutos o menos de la llegada.
La regla con velocidad reciente apenas mejora: 10.83 minutos y 59.5 %. Usar la velocidad de la última media hora ayuda a veces y perjudica otras: supone que lo que viene se parece a lo que pasó, y un trancón que termina o empieza rompe esa suposición.
22.4.6 Diseño de la red
La red combina dos fuentes: la secuencia del GPS, que describe el presente, y los datos del plan, que describen lo que falta. Cuatro decisiones:
Una LSTM para el GPS. Treinta minutos son treinta pasos, más de lo que recuerda bien una red recurrente simple. El caso anterior usó una GRU; aquí se usa una LSTM, la otra celda con puertas del capítulo 20, con un estado de 32 números.
El plan entra después de la LSTM. Los kilómetros, las paradas y la hora no cambian minuto a minuto: no tiene sentido leerlos como secuencia. Se concatenan con el último estado de la LSTM.
Una red densa pequeña al final (64 neuronas) combina las dos cosas. Así puede aprender, por ejemplo, que un trancón importa mucho para el próximo cliente y menos para el quinto.
La pérdida es el error absoluto medio, la misma medida con que se evalúa: la red aprende a equivocarse por pocos minutos, sin perseguir los casos raros.
ImportanteAquí se arma la red del caso
La celda siguiente define las dos redes. EstimadorPlan es la línea base: solo ve el plan. EstimadorETA es la red del caso: la LSTM lee la secuencia (N, 30, 2) y devuelve su último estado, de forma (N, 32); torch.cat lo une a los 3 datos del plan para formar un vector de 35, y la red densa lo convierte en los minutos estimados. Recuerda que la LSTM devuelve el estado final como la pareja (h, c): aquí se usa h.
# Las dos redes: solo con el plan, y con el GPS más el plan.class EstimadorPlan(nn.Module):"""Línea base: una red densa con los 3 datos del plan."""def__init__(self):super().__init__()self.red = nn.Sequential(nn.Linear(3, 64), nn.ReLU(), nn.Linear(64, 1))def forward(self, secuencia, plan):returnself.red(plan).squeeze(1) # no usa la secuenciaclass EstimadorETA(nn.Module):"""LSTM sobre los últimos 30 minutos del GPS, unida a los datos del plan."""def__init__(self, estado=32):super().__init__()self.lstm = nn.LSTM(input_size=2, hidden_size=estado, batch_first=True) # 2 datos por minuto, memoria de 32self.red = nn.Sequential(nn.Linear(estado +3, 64), nn.ReLU(), nn.Linear(64, 1))def forward(self, secuencia, plan): _, (h_final, _) =self.lstm(secuencia) # h_final: (1, N, 32) unidos = torch.cat([h_final[-1], plan], dim=1) # (N, 32 + 3)returnself.red(unidos).squeeze(1) # minutos estimadosfor nombre, clase in [("Solo el plan", EstimadorPlan), ("GPS + plan (LSTM)", EstimadorETA)]:print(f"{nombre:<18}{sum(p.numel() for p in clase().parameters()):>6} parámetros")
Solo el plan          321 parámetros
GPS + plan (LSTM)    6977 parámetros
La red que solo ve el plan es diminuta: 321 parámetros. La red del caso tiene 6 977: 4 608 en la LSTM (4 bloques de 32 × 2 para la entrada, 4 de 32 × 32 para el estado y sus sesgos) y 2 369 en la red densa que combina los 35 números. Sigue siendo una red pequeña, que entrena en menos de un minuto en una CPU.
22.4.7 Entrenamiento
Las dos redes se entrenan con las mismas reglas: error absoluto medio, Adam con una tasa de 0.003, lotes de 256 consultas, hasta 40 épocas y parada temprana con paciencia 6, con el checkpoint de menor error de validación.
# Entrena una red con checkpoint de menor error de validación y parada temprana.def entrenar(modelo, nombre): sec_tr, plan_tr, y_tr = tensores["train"] sec_va, plan_va, y_va = tensores["val"] optimizador = torch.optim.Adam(modelo.parameters(), lr=3e-3) generador = torch.Generator().manual_seed(SEMILLA) historial, mejor, mejor_epoca, espera = [], float("inf"), 0, 0 inicio = time.perf_counter()for epoca inrange(1, 41):# 1. Una pasada por las consultas de entrenamiento, en lotes de 256. modelo.train() orden = torch.randperm(len(y_tr), generator=generador)for i inrange(0, len(orden), 256): lote = orden[i:i +256] optimizador.zero_grad() perdida = F.l1_loss(modelo(sec_tr[lote], plan_tr[lote]), y_tr[lote]) perdida.backward() optimizador.step()# 2. Error medio de validación, en minutos. modelo.eval()with torch.no_grad(): error_val = F.l1_loss(modelo(sec_va, plan_va), y_va).item() historial.append({"epoca": epoca, "mae_val": error_val})# 3. Checkpoint y parada temprana.if error_val < mejor: mejor, mejor_epoca, espera = error_val, epoca, 0 torch.save(modelo.state_dict(), ARTEFACTOS /f"{nombre}.pt")else: espera +=1if espera ==6:break modelo.load_state_dict(torch.load(ARTEFACTOS /f"{nombre}.pt")) modelo.eval() segundos = time.perf_counter() - inicioprint(f"{nombre}: mejor época {mejor_epoca} de {len(historial)} · "f"MAE de validación {mejor:.2f} minutos · {segundos:.0f} s")return pd.DataFrame(historial)torch.manual_seed(SEMILLA)red_plan = EstimadorPlan()historial_plan = entrenar(red_plan, "solo-plan")torch.manual_seed(SEMILLA)red_eta = EstimadorETA()historial_eta = entrenar(red_eta, "gps-mas-plan")
solo-plan: mejor época 9 de 15 · MAE de validación 7.20 minutos · 3 s
gps-mas-plan: mejor época 26 de 32 · MAE de validación 6.67 minutos · 56 s
fig, ax = plt.subplots(figsize=(7.5, 3.6))ax.plot(historial_plan.epoca, historial_plan.mae_val, "-o", color="#89878C", ms=4, label="solo el plan")ax.plot(historial_eta.epoca, historial_eta.mae_val, "--s", color="#EE5400", ms=4, label="GPS + plan (LSTM)")ax.set(xlabel="Época", ylabel="MAE de validación (minutos)")ax.legend(fontsize=8)fig.tight_layout()plt.show()
Figura 22.7: Error absoluto medio de validación por época de las dos redes
Las 2 curvas cuentan cosas distintas:
La red que solo ve el plan aprende en 2 épocas y se estanca en 7.20 minutos: con tres datos, no hay mucho más que aprender. La parada temprana la detuvo en la época 15, con su mejor versión en la 9.
La red con el GPS sigue mejorando hasta la época 26, y llega a 6.67 minutos. Necesita más épocas porque tiene que aprender a leer la secuencia: cuándo un tramo lento es un trancón y cuándo un semáforo.
Ninguna de las dos quedó en el límite de 40 épocas.
22.4.8 Evaluación
Las cuatro alternativas se miden una sola vez en las consultas de las 150 rutas de prueba, en total y según a cuántos clientes de distancia está el destino.
# Estimaciones de las cuatro alternativas en la prueba.secuencia_te, plan_te, real_te, detalle_te = consultas["test"]sec_t, plan_t, _ = tensores["test"]with torch.no_grad(): estimaciones = {"Regla actual": regla_actual(secuencia_te, plan_te),"Regla con velocidad reciente": regla_velocidad_reciente(secuencia_te, plan_te),"Red solo con el plan": red_plan(sec_t, plan_t).numpy(),"Red GPS + plan (LSTM)": red_eta(sec_t, plan_t).numpy()}total = pd.DataFrame({nombre: resumen(e, real_te) for nombre, e in estimaciones.items()}).Tdisplay(total)
mae_minutos
dentro_de_10_min
Regla actual
10.91
0.581
Regla con velocidad reciente
10.91
0.591
Red solo con el plan
7.10
0.751
Red GPS + plan (LSTM)
6.64
0.774
En las 42 178 consultas de prueba, el orden es claro:
Las dos reglas se equivocan en 10.91 minutos en promedio, y aciertan a 10 minutos o menos el 58.1 % y el 59.1 % de las veces.
La red que solo ve el plan baja a 7.10 minutos y 75.1 %. Buena parte de la mejora no necesita una red recurrente: viene de aprender de los datos las velocidades y los tiempos de entrega reales, en lugar de suponer 20 km/h y 5 minutos.
La red con el GPS baja a 6.64 minutos y 77.4 %. Es medio minuto menos que la red con el plan: lo que aporta leer cómo va la ruta en este momento.
# Error medio por número de cliente (1 = el próximo).estilos = {"Regla actual": (":^", "#2B2B2B"), "Regla con velocidad reciente": ("-.D", "#89878C"),"Red solo con el plan": ("-o", "#1786B3"), "Red GPS + plan (LSTM)": ("--s", "#EE5400")}por_cliente = {}fig, ax = plt.subplots(figsize=(7.5, 3.8))for nombre, (estilo, color) in estilos.items(): error = np.abs(estimaciones[nombre] - real_te) por_cliente[nombre] = [float(error[detalle_te.k == k].mean()) for k inrange(1, CLIENTES +1)] ax.plot(range(1, CLIENTES +1), por_cliente[nombre], estilo, color=color, ms=6, label=nombre)ax.set(xlabel="Cliente (1 = el próximo)", ylabel="MAE en la prueba (minutos)", xticks=range(1, 6))ax.legend(fontsize=8)fig.tight_layout()plt.show()
Figura 22.8: Error absoluto medio en la prueba según a cuántos clientes de distancia está el destino
# Las mismas cifras de la gráfica, en una tabla: MAE en minutos por cliente.display(pd.DataFrame(por_cliente, index=pd.Index(range(1, CLIENTES +1), name="cliente")).round(2))
Regla actual
Regla con velocidad reciente
Red solo con el plan
Red GPS + plan (LSTM)
cliente
1
4.29
4.01
3.38
2.87
2
8.10
7.83
5.81
5.18
3
11.46
11.41
7.54
7.08
4
14.61
14.80
9.12
8.75
5
17.69
18.22
10.52
10.22
La tabla de 5 clientes y la gráfica muestran dónde está la diferencia:
El error crece con la distancia en todas las alternativas: con la regla actual, de 4.29 minutos para el próximo cliente a 17.69 para el quinto; con la red del caso, de 2.87 a 10.22.
Frente a la regla actual, la red reduce el error a menos de dos tercios en todos los clientes, y casi a la mitad en el quinto.
El GPS aporta más donde el presente importa más. Para el próximo cliente, la red con GPS se equivoca en 2.87 minutos frente a 3.38 de la red con el plan, un 15 % menos; para el quinto, 10.22 frente a 10.52, apenas un 3 % menos. Un trancón o un conductor lento cambian mucho la próxima llegada; en una hora, otras cosas pesan más.
22.4.9 De la predicción a la decisión de operación
El mensaje al cliente da una ventana de llegada en lugar de un minuto exacto. La decisión de la empresa es qué tan ancha debe ser la ventana para que se cumpla en el 90 % de los casos. Se decide así:
En validación, para cada alternativa y cada número de cliente, se mide el error de cada ETA.
El ancho de la ventana es el doble del error que deja por debajo al 90 % de los casos: si el 90 % de los errores es de 12 minutos o menos, la ventana va de 12 minutos antes a 12 minutos después del ETA.
En la prueba se comprueba si esas ventanas, calculadas sin verla, se cumplen.
# Ancho de ventana para cumplir el 90 % en validación, y cumplimiento en la prueba.with torch.no_grad(): sec_v, plan_v, _ = tensores["val"] estimaciones_val = {"Regla actual": regla_actual(secuencia_val, plan_val),"Red solo con el plan": red_plan(sec_v, plan_v).numpy(),"Red GPS + plan (LSTM)": red_eta(sec_v, plan_v).numpy()}detalle_val = consultas["val"][3]filas = []for nombre in estimaciones_val:for k inrange(1, CLIENTES +1):# 1. Error que deja por debajo al 90 % de las consultas de validación de ese cliente. error_val = np.abs(estimaciones_val[nombre] - real_val)[detalle_val.k == k] margen =float(np.percentile(error_val, 90))# 2. ¿Qué proporción de las llegadas de prueba cae dentro de ETA ± margen? error_test = np.abs(estimaciones[nombre] - real_te)[detalle_te.k == k] filas.append({"alternativa": nombre, "cliente": k, "ventana_minutos": round(2* margen),"cumple_en_prueba": round(float(np.mean(error_test <= margen)), 3)})ventanas = pd.DataFrame(filas).pivot(index="cliente", columns="alternativa", values=["ventana_minutos", "cumple_en_prueba"])ventanas.to_csv(ARTEFACTOS /"ventanas.csv")display(ventanas)
ventana_minutos
cumple_en_prueba
alternativa
Red GPS + plan (LSTM)
Red solo con el plan
Regla actual
Red GPS + plan (LSTM)
Red solo con el plan
Regla actual
cliente
1
14.0
17.0
22.0
0.902
0.908
0.905
2
23.0
25.0
38.0
0.913
0.908
0.911
3
30.0
32.0
52.0
0.910
0.914
0.917
4
36.0
36.0
62.0
0.907
0.903
0.911
5
40.0
41.0
73.0
0.895
0.893
0.908
La tabla de ventanas traduce el error de las 3 alternativas a lo que verá el cliente:
Las tres alternativas cumplen la ventana en cerca del 90 % de los casos de prueba (entre el 89.3 % y el 91.7 %), sin haber visto la prueba al calcularlas. El procedimiento funciona.
La diferencia está en el ancho. Con la regla actual, el mensaje del próximo cliente tendría que dar una ventana de 22 minutos; con la red del caso, de 14. Para el quinto cliente, 73 minutos frente a 40.
La red con el plan queda cerca de la red con GPS (17 frente a 14 minutos para el próximo cliente; 41 frente a 40 para el quinto). Para los mensajes de los clientes lejanos, el plan bien aprendido hace casi todo el trabajo; el GPS se nota en los cercanos.
¿Cómo se ve en una ruta concreta? La gráfica siguiente sigue a un cliente de una ruta de prueba: cada 5 minutos, lo que dicen la regla actual y la red, frente a lo que de verdad faltaba.
# 1. Elige el peor caso de la regla actual en la prueba y sigue a ese cliente en el tiempo.error_regla = np.abs(estimaciones["Regla actual"] - real_te)peor = detalle_te.iloc[int(np.argmax(error_regla))]del_cliente = (detalle_te.ruta == peor.ruta) & (detalle_te.parada == peor.parada)minutos = detalle_te.minuto[del_cliente].to_numpy()print(f"Ruta {peor.ruta}, parada {peor.parada}: {del_cliente.sum()} consultas, "f"llegada en el minuto {paradas['test'][peor.ruta].llegada[peor.parada]}")# 2. Lo real y las dos estimaciones en cada consulta, con los trancones de fondo.fig, ax = plt.subplots(figsize=(9, 3.8))ruta = gps["test"][peor.ruta]for minuto in ruta.minuto[(ruta.en_trancon ==1) & ruta.minuto.between(minutos[0], minutos[-1])]: ax.axvspan(minuto, minuto +1, color="#EE5400", alpha=0.12, lw=0)ax.plot(minutos, real_te[del_cliente], "-", color="#2B2B2B", lw=2, label="lo que faltaba")ax.plot(minutos, estimaciones["Regla actual"][del_cliente], ":o", color="#89878C", ms=3, label="regla actual")ax.plot(minutos, estimaciones["Red GPS + plan (LSTM)"][del_cliente], "--s", color="#EE5400", ms=3, label="red GPS + plan")ax.set(xlabel="Minuto de la ruta", ylabel="Minutos para llegar al cliente")ax.legend(fontsize=8)fig.tight_layout()plt.show()
Ruta 87, parada 7: 23 consultas, llegada en el minuto 154
Figura 22.9: Un cliente de una ruta de prueba: minutos que faltaban de verdad y lo que estimaban la regla actual y la red
Para el ejemplo se eligió, a propósito, el peor caso de la regla actual en la prueba: la parada 7 de la ruta 87, seguida en 23 consultas desde el minuto 39. Es una ruta difícil: sale a las 7:13, en hora pico; tiene trancones casi seguidos entre los minutos 56 y 129; y dos de las paradas anteriores son edificios.
Al comienzo faltaban unos 115 minutos. La regla actual decía 48 y la red 70. Las dos se quedan cortas, porque nada en los primeros 30 minutos anunciaba lo que venía.
Cuando empieza el trancón, cerca del minuto 58, la red sube su estimación de 57 a 66 minutos: reconoce el trancón en el GPS. La regla sigue bajando como si nada.
Durante toda la ruta, la red queda más cerca de lo real que la regla, y al final, a 20 minutos de la llegada, las dos ya aciertan casi del todo.
El caso muestra la fuerza y el límite de la red: reacciona a lo que ve en el GPS, pero no puede prever un trancón que todavía no empezó.
Para usar la red en la operación se guardan, junto con los pesos, la escala del plan, los minutos de GPS, la división de la velocidad y los márgenes de las ventanas.
# Guarda pesos y metadatos, recarga y comprueba que la red da lo mismo.margenes = {f"cliente_{k}": float(ventanas.loc[k, ("ventana_minutos", "Red GPS + plan (LSTM)")]) /2for k inrange(1, CLIENTES +1)}metadatos = {"minutos_gps": MINUTOS_GPS, "velocidad_dividida_por": 30, "datos_plan": NOMBRES_PLAN,"media_plan": media_plan.tolist(), "desviacion_plan": desviacion_plan.tolist(),"margen_ventana_minutos": margenes}(ARTEFACTOS /"eta-metadatos.json").write_text(json.dumps(metadatos, indent=2), encoding="utf-8")copia = EstimadorETA()copia.load_state_dict(torch.load(ARTEFACTOS /"gps-mas-plan.pt"))copia.eval()with torch.no_grad(): iguales = torch.equal(copia(sec_t[:500], plan_t[:500]), red_eta(sec_t[:500], plan_t[:500]))print("Metadatos guardados:", list(metadatos))print("¿Mismas estimaciones al recargar?", iguales)
Se guardan 6 piezas junto con los pesos: los minutos de GPS, la división de la velocidad, los nombres de los datos del plan, su media, su desviación y el margen de la ventana para cada cliente. La red recargada da exactamente las mismas estimaciones en 500 consultas de prueba.
22.4.10 Errores frecuentes en este caso
Los tres errores siguientes se provocan a propósito con la red ya entrenada.
# Error 1: pasar los datos del plan sin escalar.with torch.no_grad(): sin_escalar = red_eta(sec_t, torch.tensor(plan_te)).numpy()print(f"Plan sin escalar · MAE {resumen(sin_escalar, real_te)['mae_minutos']} minutos")# Error 2: partir las consultas al azar en lugar de partir por ruta.rng = np.random.default_rng(SEMILLA)rutas = consultas["train"][3].ruta.to_numpy()orden = rng.permutation(len(rutas))mitad_a, mitad_b = rutas[orden[: len(orden) //2]], rutas[orden[len(orden) //2:]]print(f"Partición al azar: {len(np.intersect1d(mitad_a, mitad_b))} de {len(np.unique(rutas))} "f"rutas quedan a los dos lados")# Error 3: mirar solo el promedio y no por cliente.error = np.abs(estimaciones["Red GPS + plan (LSTM)"] - real_te)print(f"MAE total {error.mean():.2f} · cliente 1: {error[detalle_te.k ==1].mean():.2f} · "f"cliente 5: {error[detalle_te.k ==5].mean():.2f} minutos")
Plan sin escalar · MAE 76.46 minutos
Partición al azar: 300 de 300 rutas quedan a los dos lados
MAE total 6.64 · cliente 1: 2.87 · cliente 5: 10.22 minutos
Los 3 errores, de nuevo, no producen ningún mensaje:
Con el plan sin escalar, la red recibe 5 km y las 10 de la mañana en lugar de números cercanos a 0, y su error sube de 6.64 a 76.46 minutos.
Con una partición al azar de las consultas, las 300 rutas de entrenamiento quedarían a los dos lados: la red se evaluaría con minutos de GPS que ya vio.
El promedio esconde la distancia: el error total de 6.64 minutos mezcla 2.87 minutos para el próximo cliente con 10.22 para el quinto. Un solo margen para todos los mensajes fallaría con los clientes lejanos.
Lo que ves
Qué pasó
Cómo se arregla
ETA absurdos, de horas o negativos
Los datos del plan llegaron sin escalar, o con otra escala
Guardar la media y la desviación del entrenamiento con el modelo y aplicarlas siempre
Un error muy bajo en validación que no se repite en la calle
Se partieron las consultas al azar y la misma ruta quedó en entrenamiento y en prueba
Partir por ruta (o por día), nunca por consulta
Ventanas que se cumplen en promedio, pero fallan con los clientes lejanos
Se usó un solo margen para todos los clientes
Calcular el margen por número de cliente, como en la tabla de ventanas
La red usa un dato que la operación no tiene
Se dejó entrar una columna que solo conoce el simulador, como si hay un trancón
Revisar que cada entrada exista en el momento de la consulta
El ETA salta mucho entre una consulta y la siguiente
El GPS tiene ruido y la red reacciona a cada minuto
Suavizar el mensaje al cliente (por ejemplo, cambiar la ventana solo si se mueve más de 5 minutos)
22.4.11 Conclusiones del caso
La red cambió lo que BITLogística puede prometer. Con la regla actual, para cumplir en 9 de cada 10 casos, la ventana del próximo cliente tendría que ser de 22 minutos y la del quinto de 73; con la red del caso, de 14 y de 40. El error medio bajó de 10.91 a 6.64 minutos, y la proporción de ETA a 10 minutos o menos de la llegada subió del 58 % al 77 %.
El caso también deja una lección honesta: la mayor parte de esa mejora vino de aprender de los datos lo que la regla suponía mal, la velocidad real y el tiempo de cada entrega, y solo una parte de leer el GPS. La red que solo ve el plan ya bajó el error a 7.10 minutos. La LSTM agregó medio minuto en promedio, concentrado en los clientes cercanos, donde un trancón o un conductor lento cambian la próxima llegada.
¿Qué se lleva el lector de este caso? Que antes de usar una red recurrente hay que preguntarse qué parte del problema depende de la secuencia y cuál no. Aquí, la distancia y la hora se resuelven con una red densa; el estado de la ruta en este momento, con una LSTM que lee el GPS. Combinar las dos fuentes, compararse con la red sin secuencia y medir por cliente es lo que permite saber cuánto aporta cada pieza, y explicarlo a la operación.
Límites del caso: los datos son sintéticos y las rutas no tienen calles ni mapa; los trancones caen al azar, sin zonas ni días más congestionados; no hay entregas fallidas, desvíos ni cambios de ruta; y la ventana se calcula con un solo margen por cliente. Con datos reales, la operación tendría que medir el error por zona, por hora y por conductor antes de cambiar sus mensajes.
22.4.12 Ejercicios del caso
¿Por qué la regla con velocidad reciente no mejora a la regla actual, si usa información más fresca?
Cambia MINUTOS_GPS a 10. Antes de ejecutar, predice qué pasará con el error del cliente 1 y del cliente 5, y explica por qué.
Agrega como cuarto dato del plan si el cliente es un edificio con recepción. ¿Qué parte del error esperas que baje?
La empresa decide anunciar ventanas de 30 minutos para todos los clientes. Con la tabla de ventanas, ¿para qué clientes la red cumpliría el 90 %?
Reemplaza la LSTM por una GRU del mismo tamaño. ¿Cuántos parámetros tendría la red? ¿Qué esperas del resultado?
¿Qué pasaría con la red si BITLogística empezara a repartir en Medellín, sin datos de esa ciudad?
TipOrientaciones
Porque la velocidad de la última media hora no dice cuánto va a durar lo que viene: si el conductor acaba de salir de un trancón, la regla supone que seguirá lento; si está por entrar, supone que seguirá rápido. Además, una velocidad baja se convierte en ETA muy largos, y los errores grandes pesan mucho en el promedio.
Con 10 minutos, la red ve menos de un trancón y casi ninguna entrega completa. Lo esperable es que pierda más en los clientes cercanos, donde el estado del presente importa más; en los lejanos pesa más el plan.
Bajaría sobre todo el error del tiempo de entrega en los edificios, que dura de 10 a 15 minutos frente a unos 5, y más en los clientes con edificios antes del destino.
La ventana de 30 minutos es un margen de 15 minutos hacia cada lado. Compara la columna de la red con 30: cumpliría el 90 % en los clientes cuya ventana necesaria es de 30 minutos o menos.
Una GRU con 2 entradas y 32 de estado tiene 3 × (32 × 2 + 32 × 32 + 2 × 32) = 3 456 parámetros, frente a 4 608 de la LSTM, más la red densa, que no cambia. Lo esperable es un error parecido; se decidiría con la validación.
Las velocidades, los trancones y los tiempos de entrega de otra ciudad serían distintos, y la red se equivocaría de forma sistemática. Haría falta reunir rutas de Medellín, medir el error allí antes de usarla y, si hace falta, reentrenar.
22.4.13 El simulador del caso
Este es el contenido de simulador_rutas.py. No necesitas leerlo para seguir el caso; está aquí para quien quiera ver las reglas con que se fabricaron las rutas.
TipVer el código de simulador_rutas.py
"""Simulador de rutas de reparto urbano de BITLogística (datos sintéticos).Lo usa solo el Caso práctico 2 del capítulo. Genera, minuto a minuto, lo que reporta elGPS del vehículo de un conductor que reparte paquetes en Bogotá: la velocidad y si estádetenido en un cliente. Con eso se sabe a qué minuto llegó a cada parada.Reglas de la simulación (todas las cifras son inventadas, con órdenes de magnitud plausibles):1. Cada ruta sale entre las 7 y las 9 de la mañana y tiene de 20 a 30 paradas. Entre una parada y la siguiente hay en promedio 1.8 km.2. La velocidad depende de la hora: más lenta en las horas pico (7 a 9 y 17 a 19).3. Cada conductor tiene su propio ritmo: algunos manejan y entregan más rápido que otros.4. En cada ruta hay de 2 a 4 trancones: durante 20 a 50 minutos la velocidad cae a un tercio. Desde el GPS se nota que está pasando, pero no cuándo termina.5. En cada parada el conductor se detiene unos 5 minutos; en edificios con recepción, de 10 a 15.6. El GPS reporta la velocidad con algo de ruido, y a veces 0 por un semáforo."""import numpy as npimport pandas as pdHORA_PICO = [(7, 9), (17, 19)] # horas en que la ciudad va más lentaVELOCIDAD_BASE =24.0# km/h fuera de hora pico, sin trancóndef factor_hora(hora):"""1.0 fuera de hora pico y 0.65 en hora pico."""for inicio, fin in HORA_PICO:if inicio <= hora < fin:return0.65return1.0def simular_ruta(rng):"""Simula una ruta completa. Devuelve dos cosas: - una tabla con una fila por minuto: velocidad del GPS (km/h), si está detenido en un cliente (1 o 0), el número de la próxima parada, los km que faltan para llegar a ella y si hay un trancón (esta última columna solo sirve para dibujar: en la operación nadie la conoce, y la red no la recibe); - una tabla con una fila por parada: distancia desde la parada anterior (km) y minuto de llegada. """# 1. Plan de la ruta: hora de salida, paradas y distancias entre ellas. salida =int(rng.integers(7*60, 9*60)) # minuto del día n_paradas =int(rng.integers(20, 31)) distancias = rng.gamma(shape=3.0, scale=0.6, size=n_paradas) # km, media 1.8 edificio = rng.random(n_paradas) <0.2# paradas con recepción# 2. Ritmo del conductor: velocidad y tiempo de entrega propios. ritmo_manejo = rng.uniform(0.85, 1.15) ritmo_entrega = rng.uniform(0.8, 1.25)# 3. Trancones: de 2 a 4, cada uno con su inicio y su duración en minutos de la ruta. trancones = []for _ inrange(int(rng.integers(2, 5))): inicio =int(rng.integers(0, 420)) trancones.append((inicio, inicio +int(rng.integers(20, 51))))# 4. Minuto a minuto: avanzar, llegar, entregar y seguir. filas, llegadas = [], [] parada, avance, entregando =0, 0.0, 0# avance: km del tramo actual minuto =0while parada < n_paradas: hora = (salida + minuto) /60 llego_ahora =Falseif entregando >0: # detenido en un cliente velocidad, en_cliente =0.0, 1 entregando -=1if entregando ==0: parada +=1# sale hacia la siguienteelse: en_trancon =any(inicio <= minuto < fin for inicio, fin in trancones) velocidad = VELOCIDAD_BASE * factor_hora(hora) * ritmo_manejo velocidad *=0.33if en_trancon else1.0 velocidad *= rng.uniform(0.8, 1.2) # variación de cada minutoif rng.random() <0.08: # semáforo en rojo velocidad =0.0 en_cliente =0 avance += velocidad /60# km recorridos en este minutoif avance >= distancias[parada]: # llegó al cliente llegadas.append(minuto) llego_ahora =True avance =0.0 base = rng.uniform(10, 15) if edificio[parada] else rng.lognormal(np.log(5), 0.3) entregando =max(1, int(round(base * ritmo_entrega))) gps =max(0.0, velocidad + rng.normal(0, 1.0)) if velocidad >0else0.0 proxima =min(parada, n_paradas -1)if en_cliente or llego_ahora: faltan_km =0.0else: faltan_km =max(0.0, distancias[proxima] - avance) filas.append({"minuto": minuto, "hora": round(hora, 3), "velocidad": round(gps, 1),"en_cliente": en_cliente, "proxima_parada": proxima,"km_a_la_proxima": round(faltan_km, 3),"en_trancon": int(any(inicio <= minuto < fin for inicio, fin in trancones))}) minuto +=1 gps = pd.DataFrame(filas) paradas = pd.DataFrame({"parada": np.arange(n_paradas), "distancia_km": np.round(distancias, 2),"edificio": edificio, "llegada": llegadas})return gps, paradasdef simular_rutas(n_rutas, semilla):"""Simula ``n_rutas`` rutas con una semilla fija: dos listas de tablas (GPS y paradas).""" rng = np.random.default_rng(semilla) gps, paradas = [], []for _ inrange(n_rutas): g, p = simular_ruta(rng) gps.append(g) paradas.append(p)return gps, paradas
22.5 Taller: tu propio caso con GRU y LSTM
Los dos casos de este capítulo siguieron el mismo recorrido: el problema en la operación, los datos, una línea base sin red, la red, la evaluación y la decisión con costos. El taller entregable propone hacer ese recorrido con un caso propio: escoges una base de datos donde el orden de los datos importe (un pronóstico de una serie de tiempo o una clasificación de secuencias), planteas una pregunta que le sirva a alguien para decidir algo y la respondes con una GRU y una LSTM, comparadas de forma justa contra una línea base sin red.
TipDescarga el taller
Taller GRU y LSTM: tu propio caso (PDF). Incluye los requisitos de los datos y dónde buscarlos, los 8 pasos del trabajo, la ficha del caso, las preguntas de reflexión y la rúbrica de calificación.