"""Simulador de direcciones que los clientes de BITLogística escriben como texto libre.

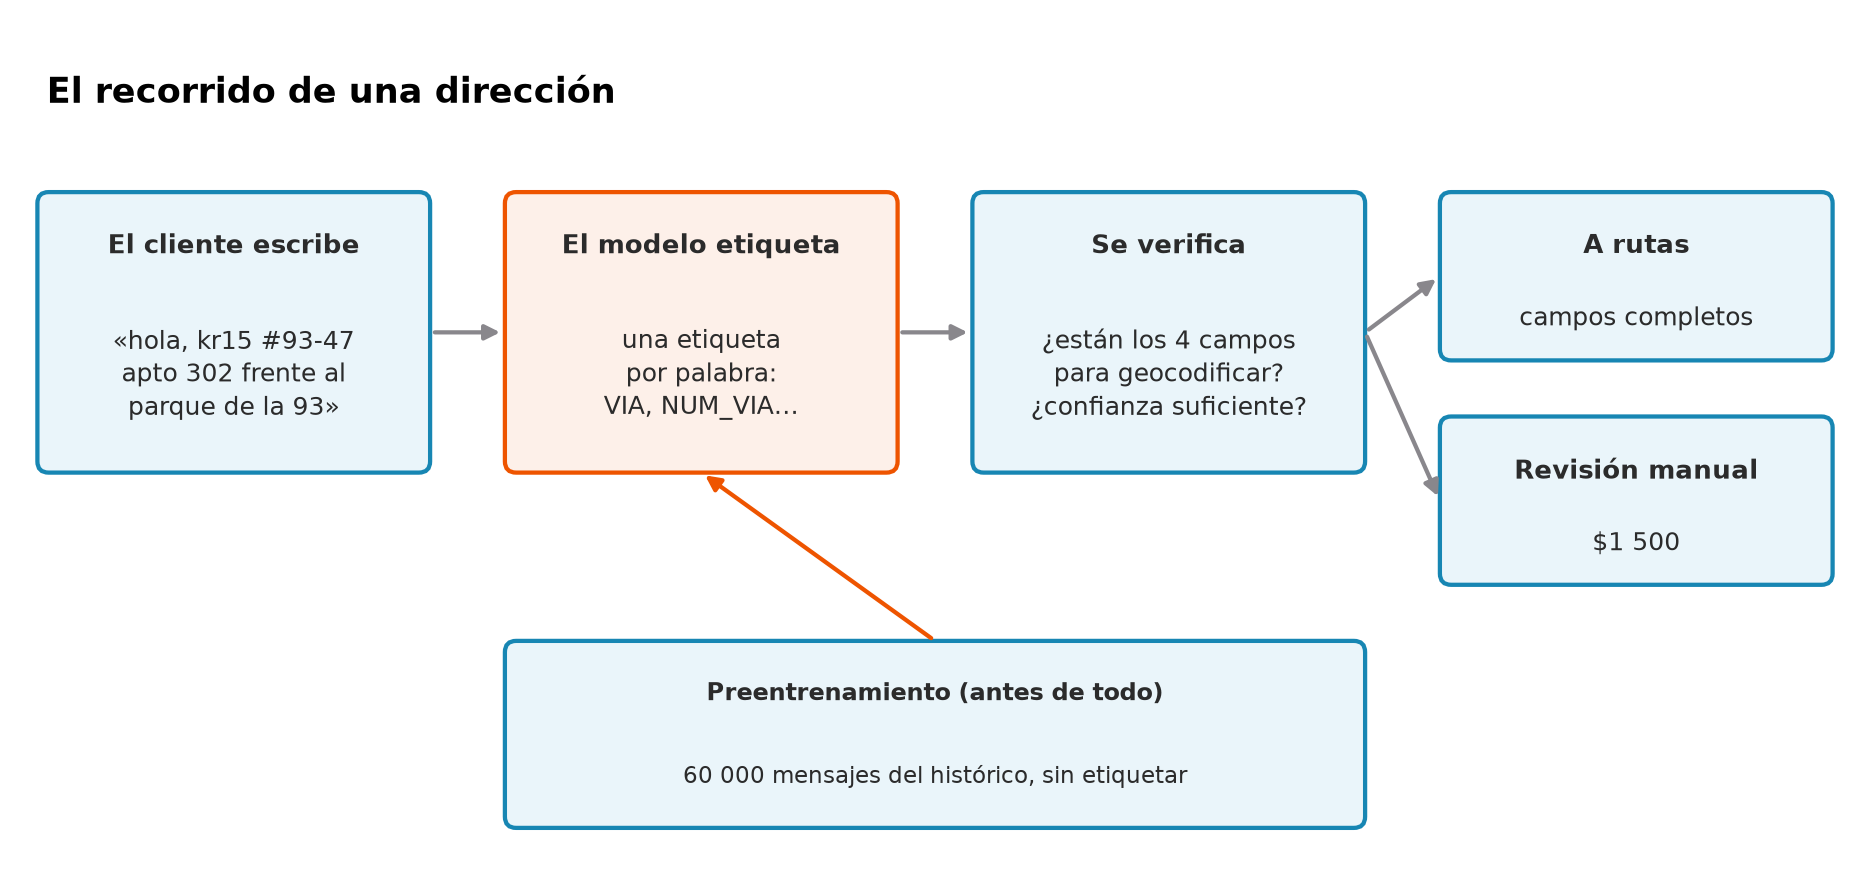
Lo usa solo el Caso práctico 1 del capítulo. Genera mensajes como los que llegan por el
formulario web o por el chat («hola, la dirección es cra 15 #93-47 apto 302, frente al
parque de la 93») y, para cada palabra, la etiqueta del campo al que pertenece.

Reglas de la simulación (todas las cifras son inventadas, con órdenes de magnitud plausibles):

1. El núcleo de la dirección sigue la nomenclatura de Bogotá: tipo de vía, número de la vía
   (a veces con letra, «bis», «sur» o «este»), un separador opcional («#», «No.», «N°»),
   el número del cruce y el de la placa. Calle y carrera son las vías más comunes.
2. El 70 % de los tipos de vía se abrevia (cra, kr, cl, cll, dg, tv...).
3. Bloques opcionales: uno o dos complementos (torre 2 apto 302), el barrio (con o sin la
   palabra «barrio»), una referencia y frases de relleno, saludos o un teléfono.
4. Muchas referencias traen números que NO son de la dirección: «frente al parque de la 93»,
   «cerca a la estación de la 72». Para saber que ese 93 es parte de una referencia hay que
   mirar las palabras de alrededor.
5. Los teléfonos («cel 3104567890») tampoco son parte de la dirección.
6. El orden de los bloques puede cambiar y hay errores de tipeo, mayúsculas y tildes
   perdidas. El conjunto «difícil» tiene más cambios de orden y más errores.
7. Quince barrios solo aparecen en las particiones de prueba: así se mide si el método
   funciona con barrios que nunca vio etiquetados.
8. El «histórico» son mensajes de envíos pasados sin etiquetar: traen todos los barrios
   de la ciudad, porque son direcciones reales de clientes, pero nadie marcó sus campos.
"""

import re
import unicodedata

import numpy as np

BARRIOS = (
    "Chapinero", "La Soledad", "Galerías", "Palermo", "Teusaquillo",
    "Quinta Paredes", "La Esmeralda", "Ciudad Salitre", "Modelia", "Hayuelos",
    "Normandía", "La Felicidad", "Santa Cecilia", "Capellanía", "Fontibón Centro",
    "El Tintal", "Patio Bonito", "Castilla", "Marsella", "Carvajal",
    "Villa Alsacia", "Timiza", "Roma", "Boitá", "Alquería",
    "Venecia", "Muzú", "Santa Isabel", "Veraguas", "Eduardo Santos",
    "Restrepo", "Olaya", "Quiroga", "Claret", "Centenario",
    "San Carlos", "Tunal", "Meissen", "Lucero Alto", "Lucero Bajo",
    "Sierra Morena", "Arborizadora Alta", "Arborizadora Baja", "Perdomo", "Madelena",
    "El Nogal", "La Cabrera", "El Retiro", "Chicó", "El Virrey",
    "San Patricio", "Santa Bibiana", "Santa Bárbara", "Multicentro", "Cedritos",
    "Contador", "El Redil", "Verbenal", "Toberín", "La Uribe",
)
BARRIOS_CONOCIDOS = BARRIOS[:45]          # aparecen en entrenamiento, validación y prueba
BARRIOS_RESERVADOS = BARRIOS[45:]         # solo en prueba
ETIQUETAS = (
    "VIA", "NUM_VIA", "NUM_CRUCE", "NUM_PLACA", "COMPLEMENTO",
    "NUM_COMPLEMENTO", "BARRIO", "REFERENCIA", "OTRO",
)
VIAS = {                                  # nombre completo: abreviaturas usadas por los clientes
    "calle": ("cl", "cll"),
    "carrera": ("cra", "kr", "cr", "kra"),
    "avenida calle": ("av cl", "avda calle"),
    "avenida carrera": ("av cra", "avda kr"),
    "diagonal": ("dg", "diag"),
    "transversal": ("tv", "transv"),
}
COMPLEMENTOS = {
    "apartamento": ("apto", "apt", "ap"), "torre": ("torre", "t"),
    "interior": ("int",), "bloque": ("blq", "bloque"), "casa": ("casa",),
    "oficina": ("ofi", "of"), "local": ("local",),
}
# Referencias: {} se reemplaza por un número que NO es parte de la dirección.
REFERENCIAS = (
    "frente al parque", "al lado de la panadería", "portería", "entregar en recepción",
    "frente al parque de la {}", "cerca a la estación de la {}", "al lado del éxito de la {}",
    "diagonal al colegio", "edificio mirador", "a media cuadra de la {}",
)
SALUDOS = ("hola", "buenas tardes", "la dirección es", "envío para", "buen día, es en")
RELLENOS = ("por favor", "casa de", "entregar a", "llamar antes", "gracias")
PATRON = re.compile(r"[^\W\d_]+|\d+[^\W\d_]?|[#\-.,°º]", re.UNICODE)


def tokenizar(texto):
    """Separa palabras, números (con su letra pegada, como 93A) y signos."""
    return PATRON.findall(texto)


def sin_tildes(texto):
    """Quita las tildes: «Chicó» → «Chico»."""
    letras = unicodedata.normalize("NFD", texto)
    return "".join(letra for letra in letras if not unicodedata.combining(letra))


def generar_direcciones(cantidad, semilla, particion):
    """Genera ``cantidad`` mensajes. Cada uno trae texto, palabras y etiquetas."""
    if particion not in ("entrenamiento", "validacion", "prueba", "dificil", "historico"):
        raise ValueError(f"Partición desconocida: {particion}")
    rng = np.random.default_rng(semilla)
    dificil = particion == "dificil"
    prueba = particion in ("prueba", "dificil", "historico")   # pueden traer barrios reservados
    prob_orden = 0.55 if dificil else 0.20              # 6. cambiar el orden de los bloques
    prob_errata = 0.12 if dificil else 0.03             # 6. error de tipeo por palabra
    filas = []

    for _ in range(cantidad):
        # 1. Núcleo de la dirección: vía, número, separador, cruce y placa.
        via = str(rng.choice(tuple(VIAS), p=[.39, .39, .06, .06, .05, .05]))
        forma_via = str(rng.choice(VIAS[via])) if rng.random() < .70 else via   # 2.
        numero = str(rng.integers(1, 201))
        cruce = str(rng.integers(1, 201))
        placa = str(rng.integers(1, 100))
        if rng.random() < .13:
            numero += str(rng.choice(list("ABC")))     # «93A»
        if rng.random() < .12:
            cruce += str(rng.choice(list("ABC")))
        sufijo = str(rng.choice(["bis", "sur", "este"])) if rng.random() < .12 else ""
        separador = str(rng.choice(["#", "No.", "N°", "no", ""], p=[.4, .15, .1, .15, .2]))
        guion = "-" if rng.random() < .65 else ""
        nucleo = [(forma_via, "VIA"), (numero, "NUM_VIA"), (sufijo, "NUM_VIA"),
                  (separador, "OTRO"), (cruce, "NUM_CRUCE"), (guion, "OTRO"),
                  (placa, "NUM_PLACA")]

        # 2. Bloques opcionales, cada uno con sus etiquetas.
        extras = []
        barrio = None
        for _ in range(int(rng.choice([0, 1, 2], p=[.40, .42, .18]))):   # 3. complementos
            complemento = str(rng.choice(tuple(COMPLEMENTOS)))
            alias = str(rng.choice(COMPLEMENTOS[complemento]))
            valor = str(rng.integers(1, 901))
            extras.append([(alias, "COMPLEMENTO"), (valor, "NUM_COMPLEMENTO")])
        if rng.random() < .40:                                            # 3. barrio
            reservado = prueba and rng.random() < .33
            barrio = str(rng.choice(BARRIOS_RESERVADOS if reservado else BARRIOS_CONOCIDOS))
            palabra = [("barrio", "OTRO")] if rng.random() < .55 else []
            extras.append(palabra + [(barrio, "BARRIO")])
        con_numero = False
        if rng.random() < .35:                                            # 4. referencia
            referencia = str(rng.choice(REFERENCIAS))
            con_numero = "{}" in referencia
            referencia = referencia.format(int(rng.integers(1, 181)))
            extras.append([(referencia, "REFERENCIA")])
        if rng.random() < .15:                                            # 5. teléfono
            telefono = "3" + "".join(str(d) for d in rng.integers(0, 10, 9))
            extras.append([(str(rng.choice(["cel", "tel", "llamar al"])), "OTRO"),
                           (telefono, "OTRO")])
        if rng.random() < .20:                                            # 3. relleno
            extras.append([(str(rng.choice(RELLENOS)), "OTRO")])

        # 3. El orden de los bloques puede cambiar; el saludo siempre va al inicio.
        bloques = [nucleo, *extras]
        if extras and rng.random() < prob_orden:
            bloques.insert(0, bloques.pop(int(rng.integers(1, len(bloques)))))
        if rng.random() < .25:
            bloques.insert(0, [(str(rng.choice(SALUDOS)), "OTRO")])

        # 4. Escribir el texto: errores de tipeo, tildes, mayúsculas y espacios pegados.
        palabras, etiquetas, fragmentos = [], [], []
        anterior = ""
        for b, bloque in enumerate(bloques):
            for fragmento, etiqueta in bloque:
                for token in tokenizar(fragmento):
                    if token.isalpha() and len(token) >= 3 and rng.random() < prob_errata:
                        i = int(rng.integers(len(token)))
                        token = token[:i] + str(rng.choice(["", token[i] * 2, "x"])) + token[i + 1:]
                    if rng.random() < .50:
                        token = sin_tildes(token)
                    if rng.random() < .15:
                        token = token.upper()
                    # Pegar el token al anterior solo donde los clientes lo hacen (cra15#93-47).
                    pegable = token in "#-" or anterior in ("#", "-")
                    pegable |= anterior.isalpha() and token[0].isdigit()
                    espacio = "" if fragmentos and pegable and rng.random() < .58 else " "
                    fragmentos.append(espacio + token)
                    palabras.append(token)
                    etiquetas.append(etiqueta)
                    anterior = token
            if b < len(bloques) - 1 and rng.random() < .30:   # coma entre bloques
                fragmentos.append(",")
                palabras.append(",")
                etiquetas.append("OTRO")
                anterior = ","
        texto = "".join(fragmentos).strip()
        assert tokenizar(texto) == palabras            # el texto se vuelve a partir igual
        filas.append({"texto": texto, "palabras": palabras, "etiquetas": etiquetas,
                      "barrio": barrio, "barrio_reservado": barrio in BARRIOS_RESERVADOS,
                      "referencia_con_numero": con_numero,
                      "forma_via": forma_via, "separador": separador})
    return filas