BIT — Business Innovation Technology BIT — Business Innovation Technology BIT
  • Volver a Home
  • Blog
  • Análisis de Datos
  • Deep Learning
  • Big Data
  • MLOps
  • IoT y AIoT

On this page

  • Áreas de conocimiento
  • Últimas publicaciones

Blog

BIT · Business Innovation Technology

Tecnología aplicada. Datos. Inteligencia.

Publicamos notebooks técnicos de Estadística, Machine Learning, Deep Learning, Big Data, MLOps e IoT bajo la marca BIT (Business Innovation Technology), a cargo de Wilder Ramírez Delgado.
Ver publicaciones GitHub

Áreas de conocimiento

 
Análisis de Datos
Un curso de estadística aplicada a la inteligencia artificial, en dos niveles. El nivel Básico cubre desde qué es un dato hasta regresión, clasificación y validación de…
 
Big Data e Ingeniería de Datos
Un curso de Big Data e Ingeniería de Datos construido desde los fundamentos: por qué nace el ecosistema Hadoop, cómo se organiza el almacenamiento distribuido con HDFS, cómo…

Deep Learning
Un curso de Deep Learning desde los fundamentos matemáticos hasta las arquitecturas modernas: perceptrón y MLP, redes convolucionales, redes recurrentes y Transformers…
 
IoT y AIoT
Un curso completo de Internet de las Cosas (IoT) e Inteligencia Artificial embebida en hardware (AIoT), construido sobre ESP32: desde los fundamentos de microcontroladores y…
 
MLOps y Producción
Un curso de MLOps: cómo llevar un modelo de Machine Learning de un notebook a un sistema en producción, y cómo mantenerlo ahí. Cubre desde la ingeniería de datos y los…
No matching items

Últimas publicaciones

 
Taller: fundamentos de PySpark sobre el clúster YARN

Taller en notebook: abrir una SparkSession en YARN, leer HDFS, trabajar con DataFrames y escribir el wordcount de vuelta a HDFS.

Wilder Ramírez Delgado
Oct 6, 2026

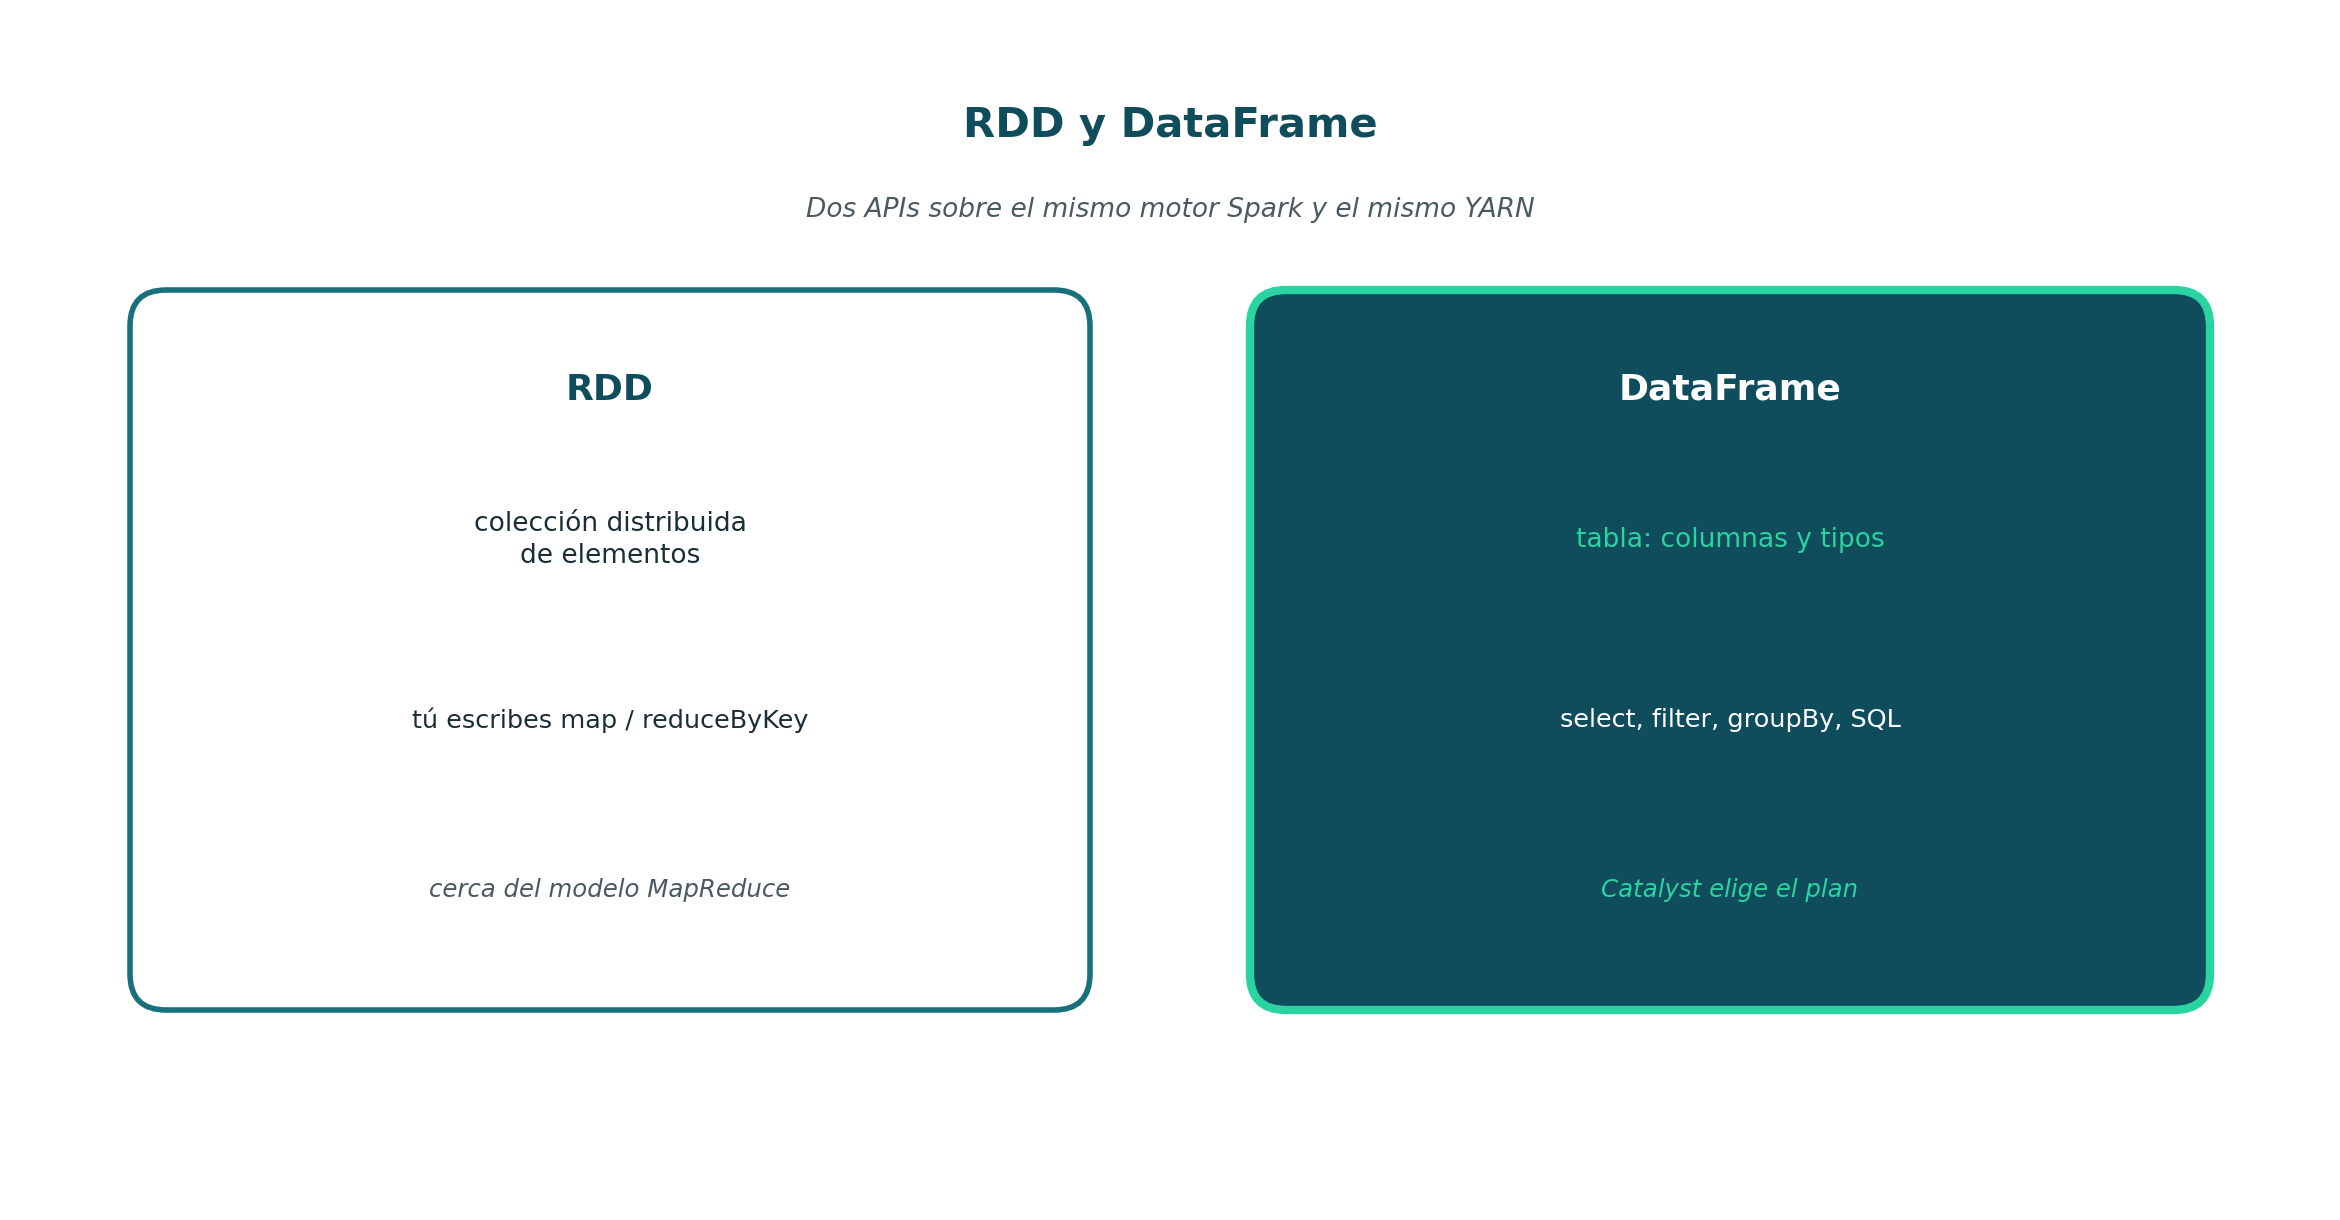
PySpark: la API de Spark en Python

SparkSession, diferencia entre RDD y DataFrame, transformaciones frente a acciones y el wordcount de MapReduce leído como tabla.

Wilder Ramírez Delgado
Oct 5, 2026
 
Taller Spark: el motor sobre el clúster que ya tienes

Taller de ejercicios sin comandos resueltos: SparkPi, wordcount Spark, driver y executors, y lectura del portal de YARN con tipo SPARK.

Wilder Ramírez Delgado
Oct 4, 2026

Spark: el motor de procesamiento sobre YARN

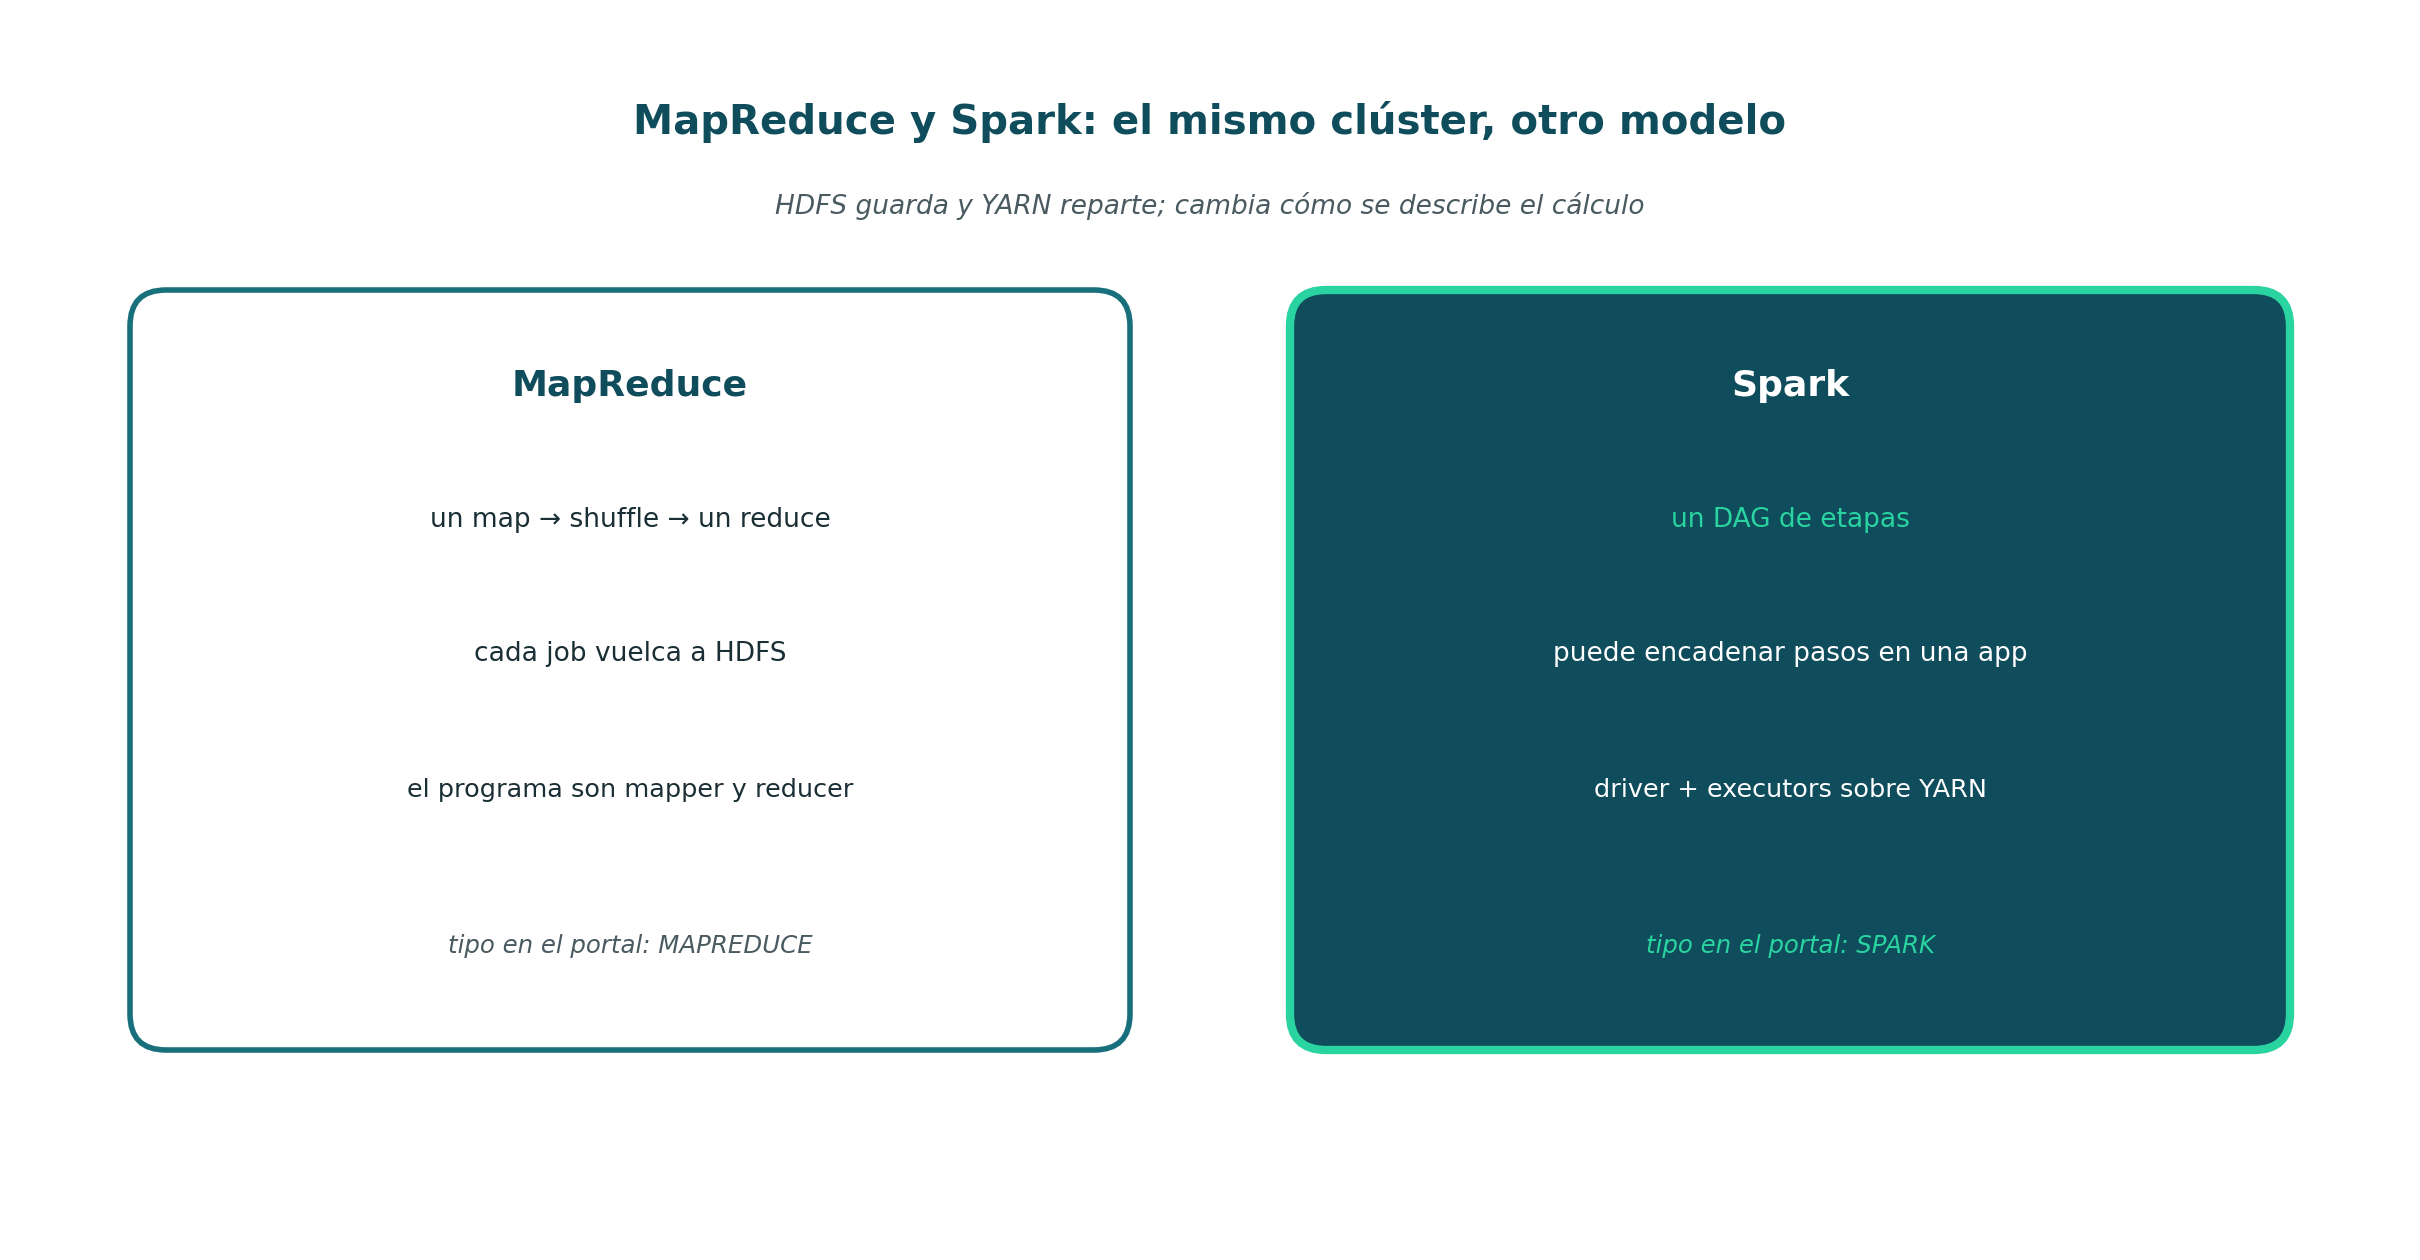
Qué pregunta responde Spark, cómo se reparten driver y executors sobre YARN, y por qué un DAG con evaluación perezosa cambia el modelo frente a MapReduce.

Wilder Ramírez Delgado
Oct 3, 2026

Análisis Avanzado de Datos — 13. Métodos de reducción de dimensionalidad: más allá de PCA

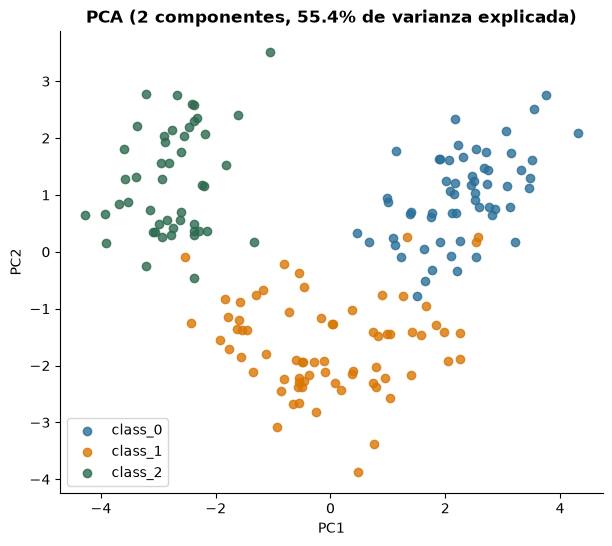
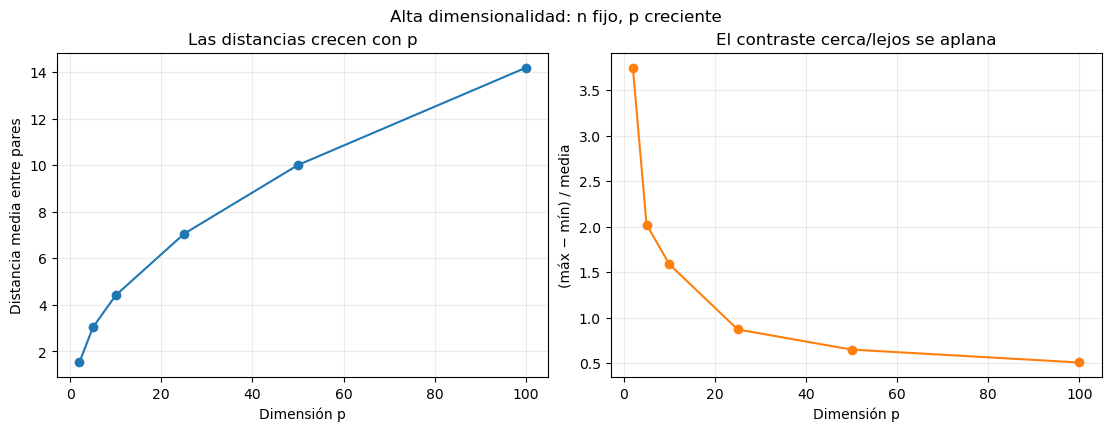
De PCA a los métodos no lineales: la maldición de la dimensionalidad, MDS, t-SNE y UMAP, y cuándo cada técnica tiene sentido para visualizar o para predecir.

Wilder Ramírez Delgado
Oct 2, 2026
 
Análisis Avanzado de Datos — Caso aplicado: comparar PCA, t-SNE y UMAP en los mismos datos

Caso aplicado: cuánta estructura conserva cada técnica de reducción de dimensionalidad, y cuál conviene según el objetivo sea visualizar o predecir.

Wilder Ramírez Delgado
Oct 2, 2026
 
Taller: MapReduce Streaming sobre el clúster HDFS/YARN

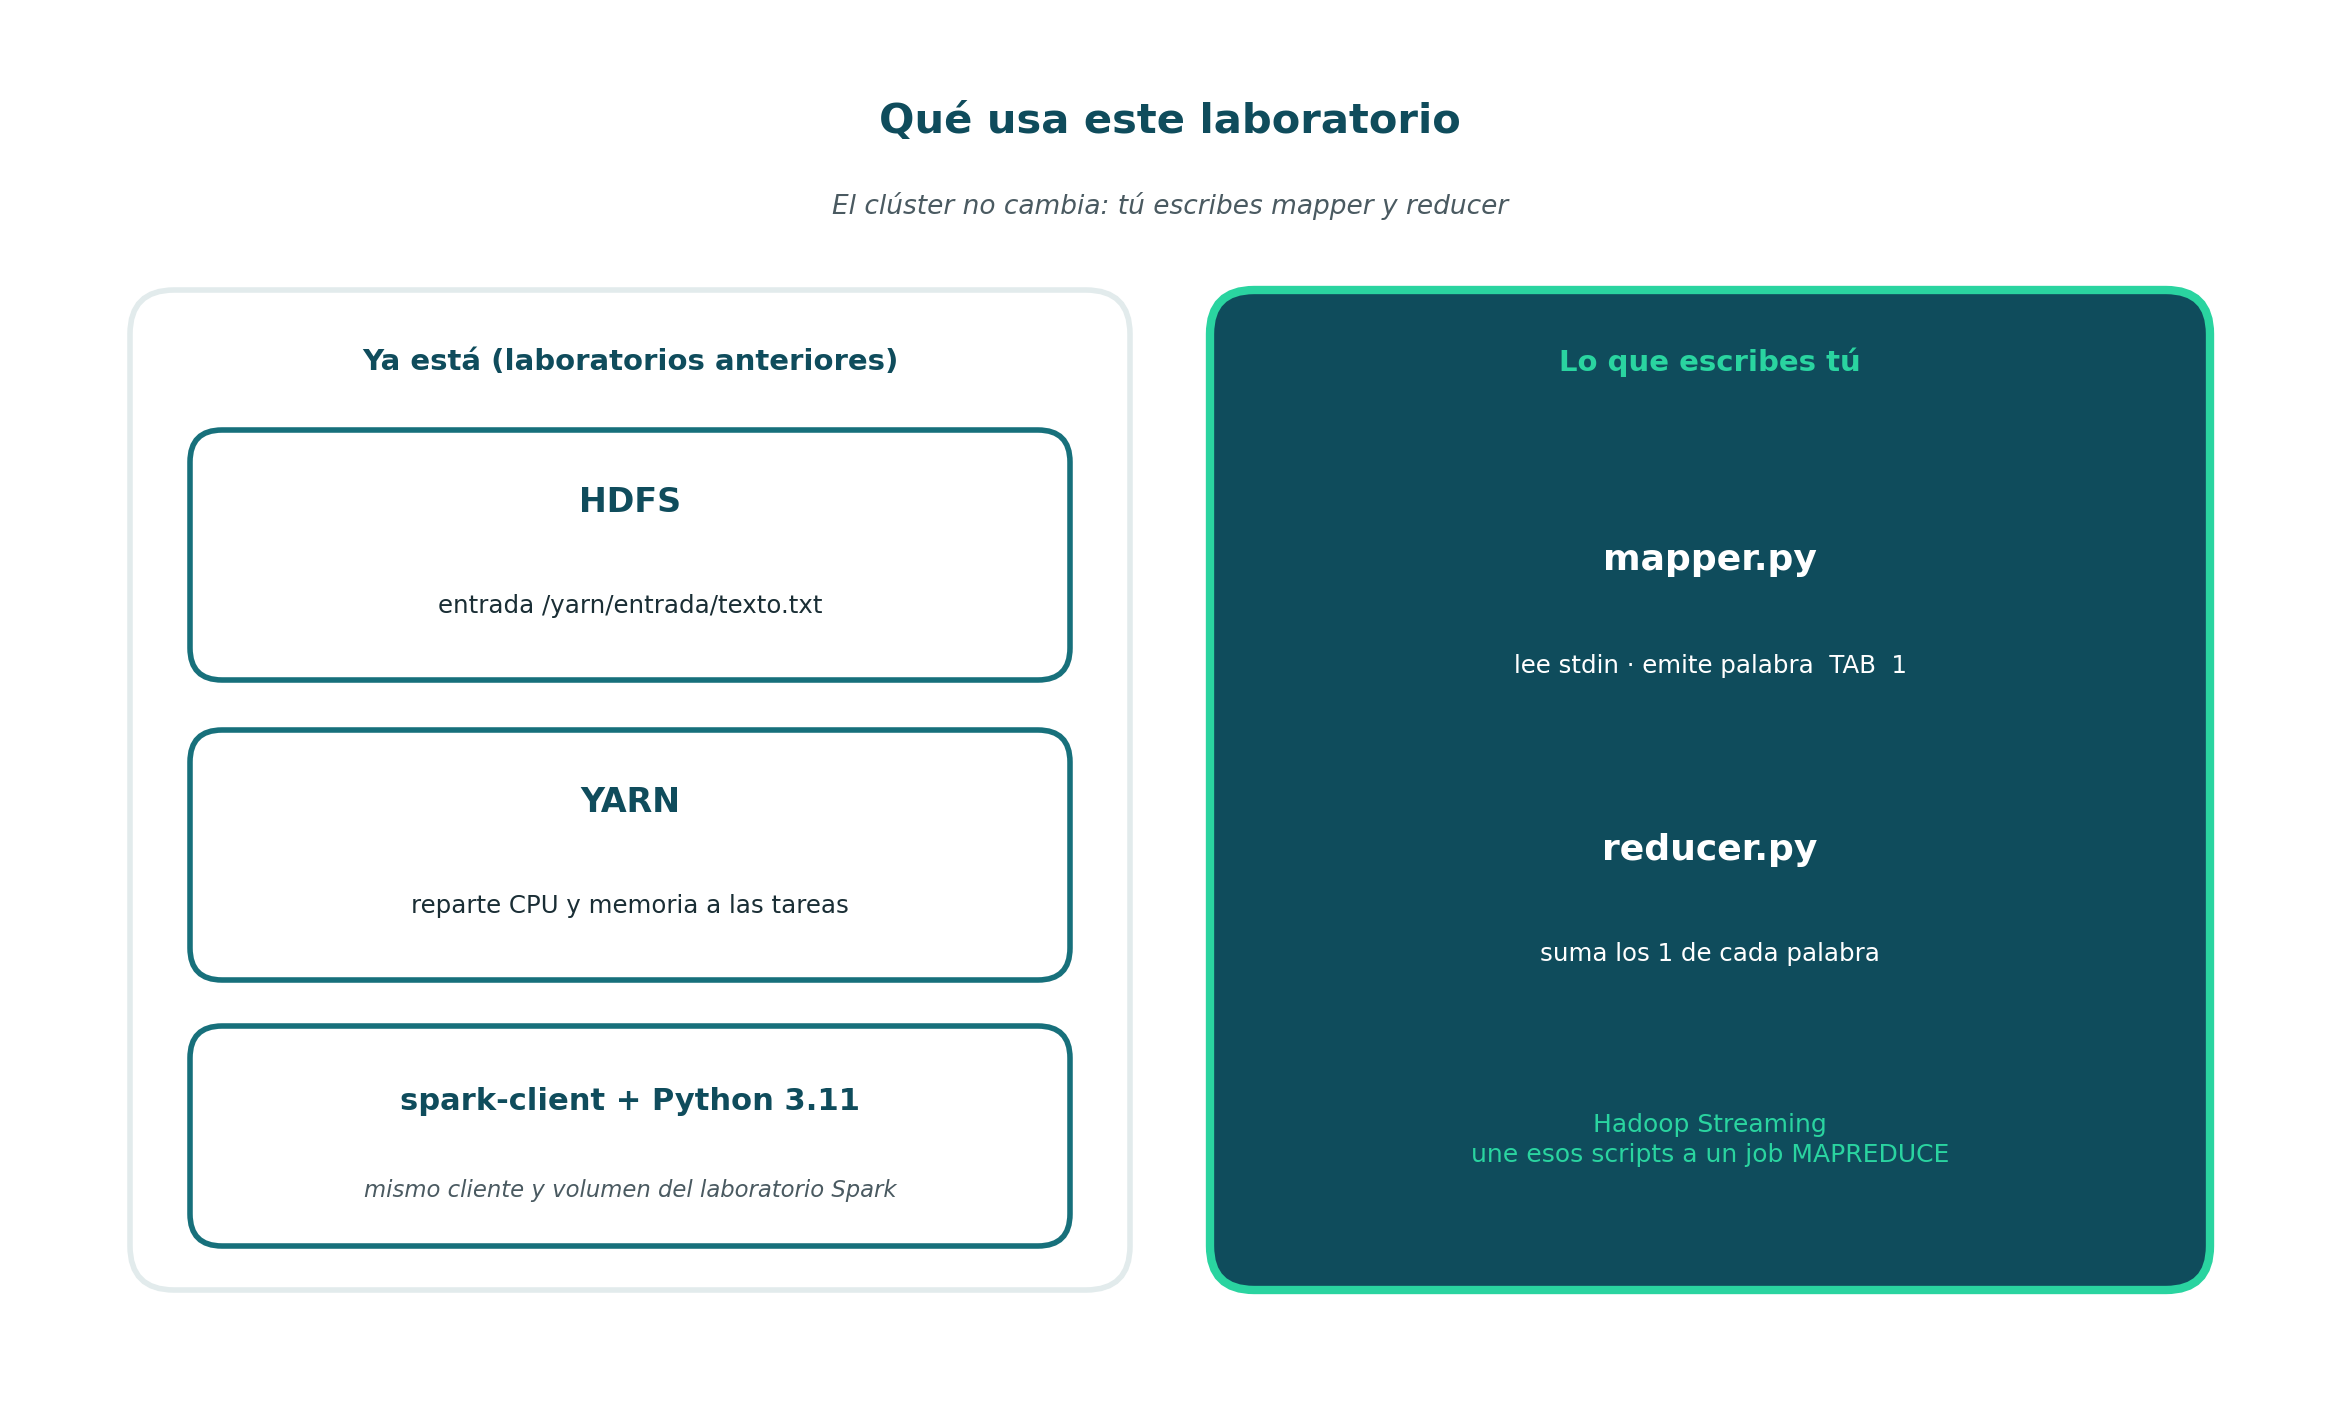
Taller práctico: escribir mapper y reducer en Python, probar la tubería y enviarlos como trabajo con Hadoop Streaming sobre YARN.

Wilder Ramírez Delgado
Oct 2, 2026

MapReduce: el modelo de procesamiento de Hadoop

Qué pregunta responde MapReduce, las fases map, shuffle y reduce, y cómo un trabajo corre sobre YARN, con dos ejemplos en el clúster.

Wilder Ramírez Delgado
Oct 1, 2026

Laboratorio: añadir un cliente Spark al clúster HDFS/YARN

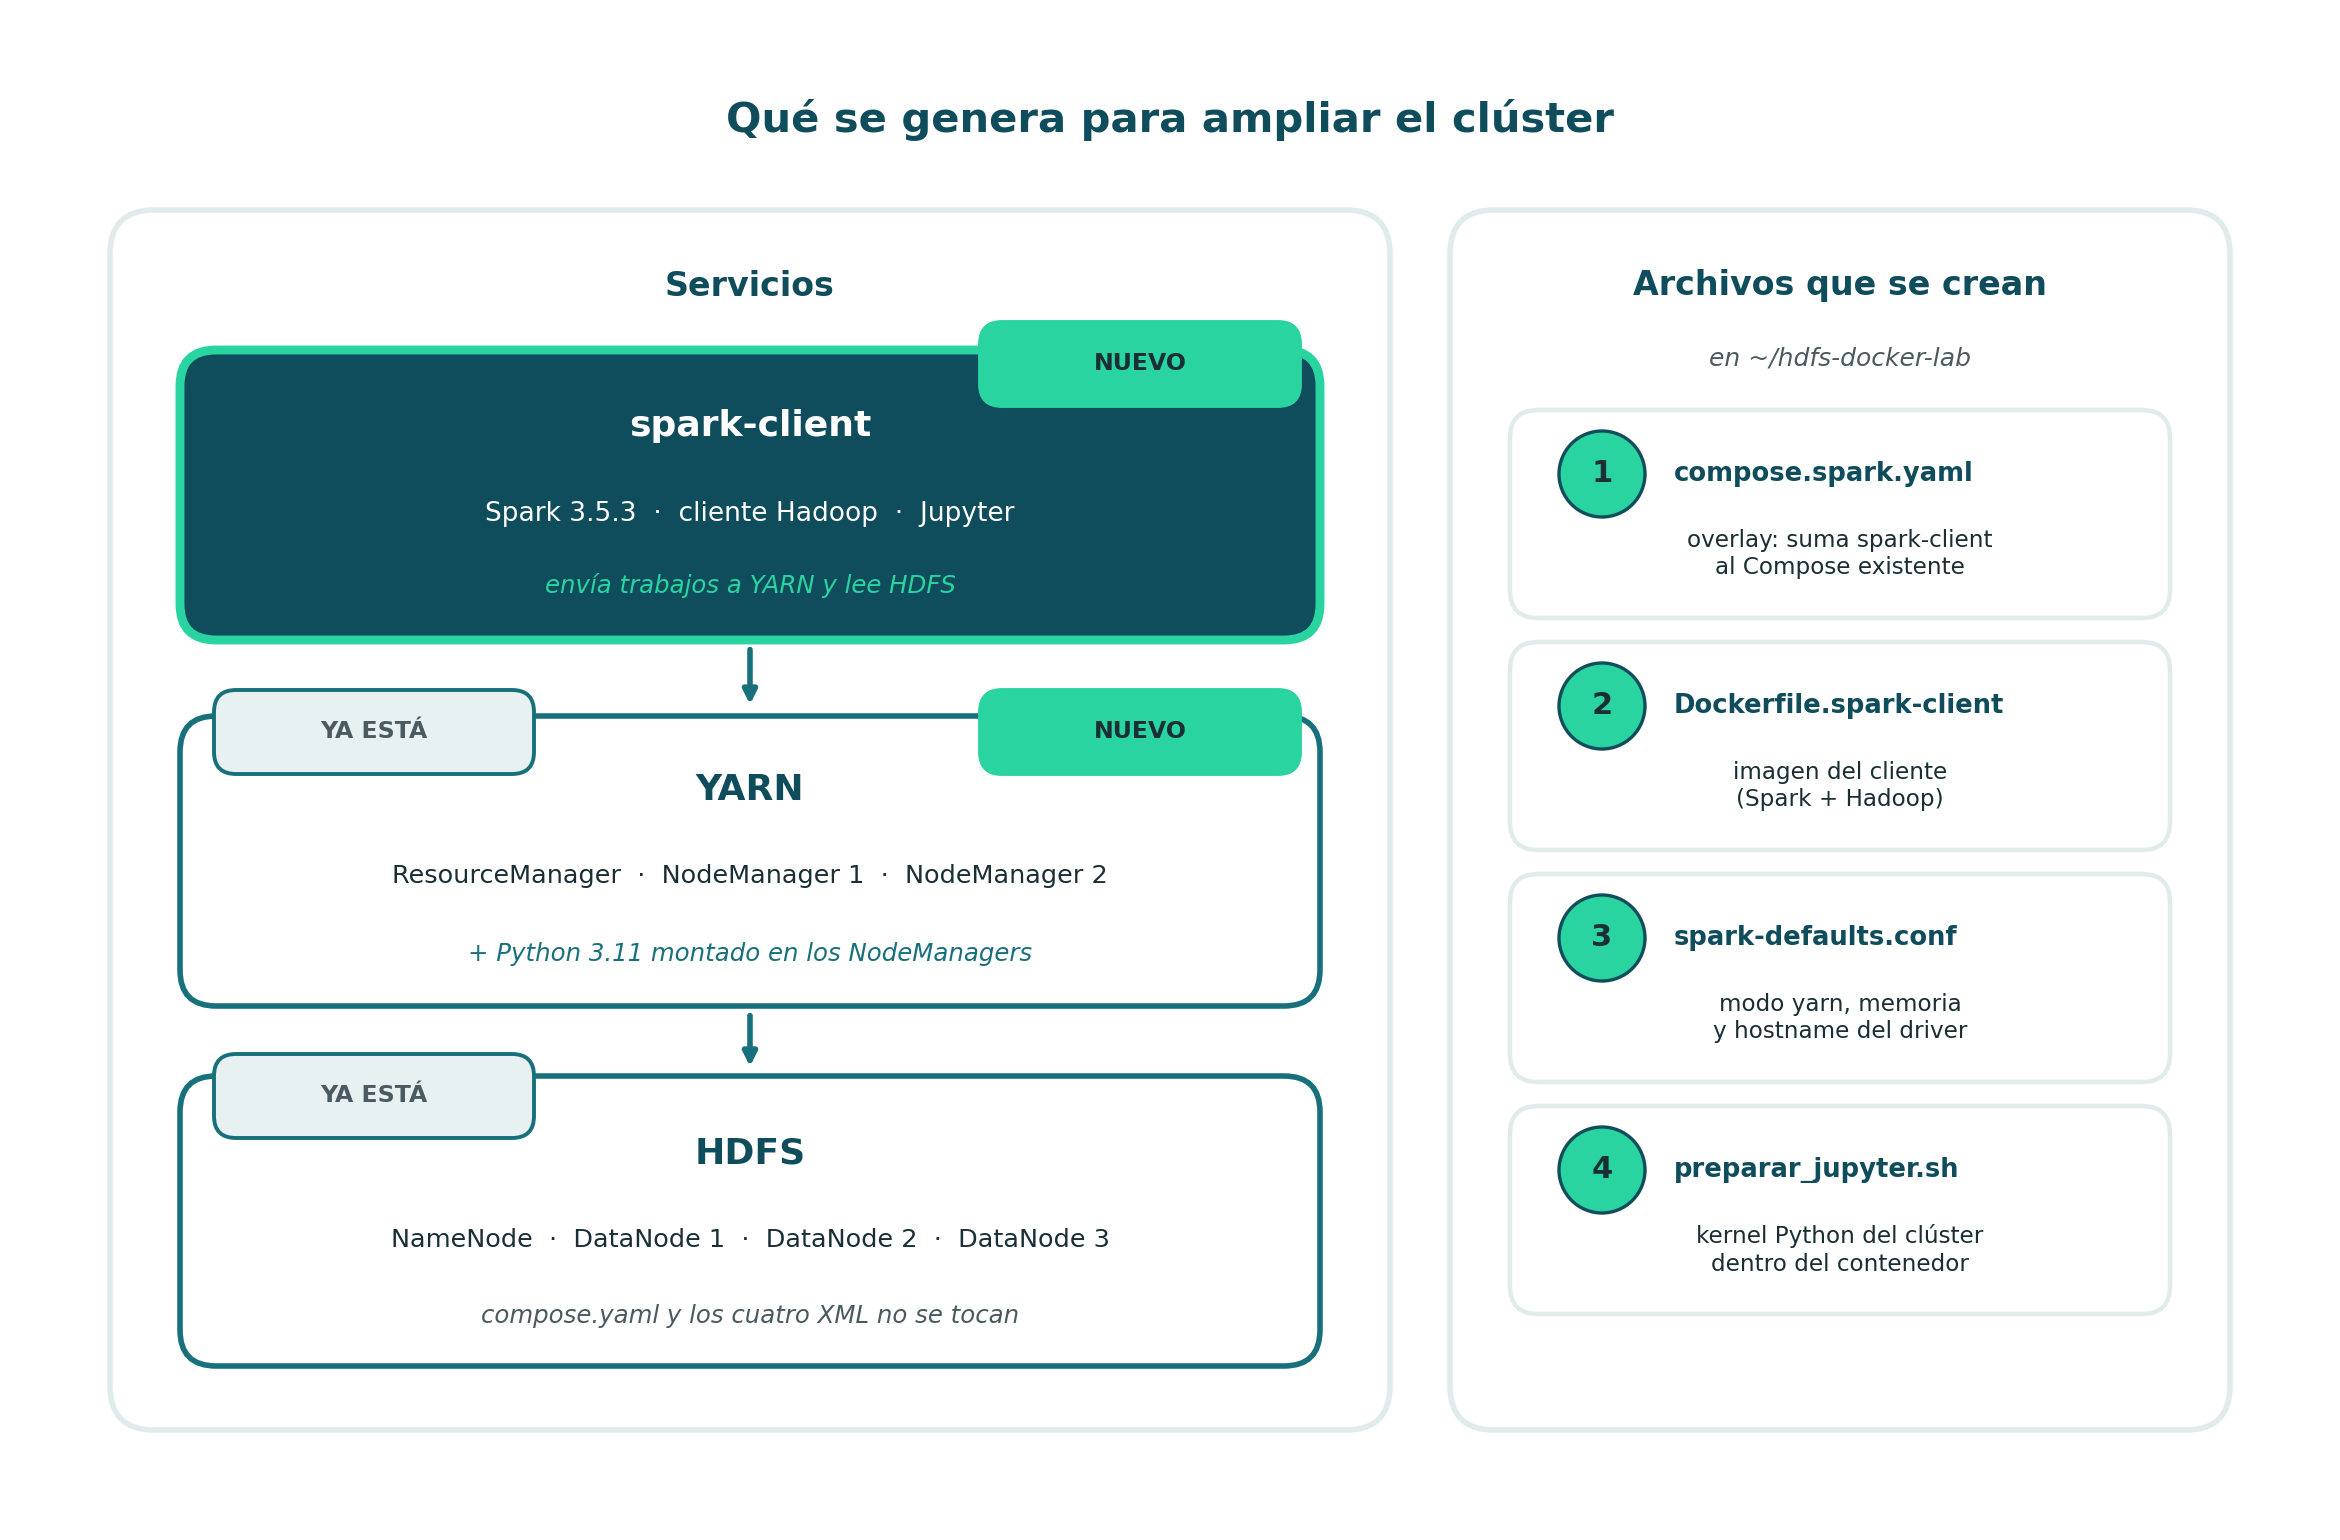
Laboratorio guiado: ampliar el clúster con un cliente Spark, Python 3.11 compartido y Jupyter, y comprobar SparkPi sobre YARN.

Wilder Ramírez Delgado
Sep 30, 2026

Análisis Avanzado de Datos — 7. Métodos de kernel: estimación de densidades y regresión

Estimación de densidades por kernel (KDE) y regresión por kernel (Nadaraya-Watson), el ancho de banda como control de flexibilidad, y su comparación con splines.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — Caso aplicado: mapas de entrega con kernels

Caso aplicado de suavización por kernel en dos dimensiones: mapas de densidad de entregas.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 8. Modelos lineales generalizados (GLM): regresión logística

Los modelos lineales generalizados a través de la regresión logística: probabilidades, odds ratios, umbrales de decisión y AUC para respuestas binarias.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 9. GLM: regresión de Poisson

Regresión de Poisson para datos de conteo, otro miembro de la familia GLM.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 10. Modelos aditivos generalizados (GAM)

Modelos aditivos generalizados: cómo un GAM extiende el marco GLM reemplazando el predictor lineal por funciones suaves.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 11. Variables latentes I: Análisis de Componentes Principales (PCA)

Análisis de Componentes Principales: reducción de dimensionalidad basada en varianza y componentes no correlacionados.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 12. Variables latentes II: Análisis de Componentes Independientes (ICA)

Análisis de Componentes Independientes: separación de fuentes mediante independencia estadística, y su relación con PCA como paso de blanqueo.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 14. Series de tiempo

Series de tiempo: dependencia temporal, descomposición, estacionariedad con la prueba ADF, ACF/PACF y pronóstico con Holt-Winters elegido por validación temporal.

Wilder Ramírez Delgado
Sep 27, 2026

Análisis Avanzado de Datos — 15. Datos longitudinales

Datos longitudinales: mediciones repetidas por individuo, correlación intraclase y modelos mixtos con intercepto aleatorio frente a una regresión que ignora los grupos.

Wilder Ramírez Delgado
Sep 27, 2026

Estadística para IA — 6. Representación vectorial de datos

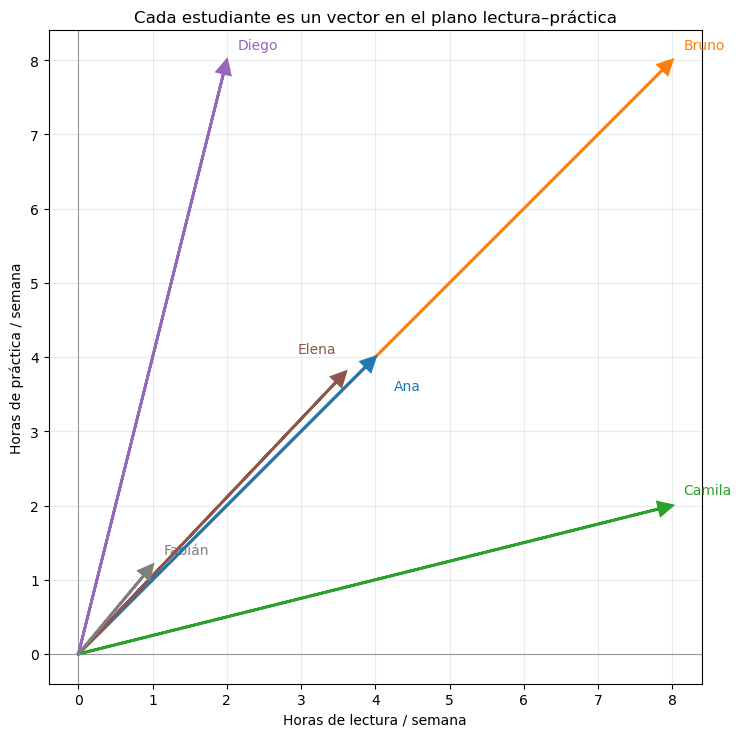
El dataset como matriz, vectorización, producto punto, norma, distancia euclidiana, similitud coseno e interpretación geométrica.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 7. Reducción de dimensionalidad (PCA)

Alta dimensionalidad, centrado, covarianza, componentes principales, varianza explicada, proyección, reconstrucción e interpretación geométrica de PCA, a mano y con…

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 8. Fundamentos de probabilidad

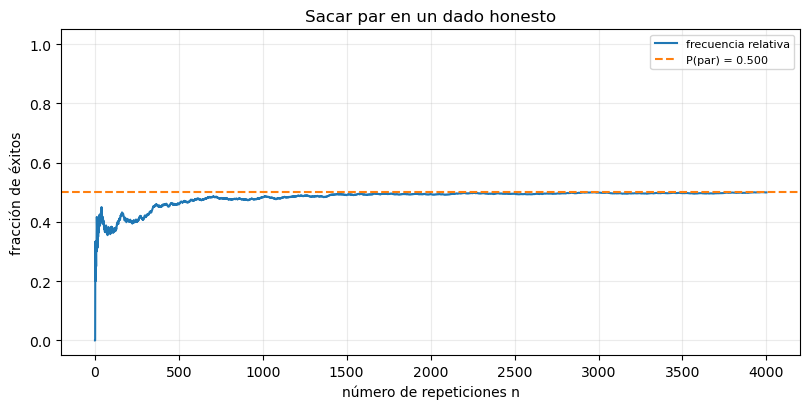
Experimento aleatorio, espacio muestral, eventos, probabilidad condicional, independencia, teorema de Bayes y un caso de clasificación binaria.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 9. Inferencia estadística

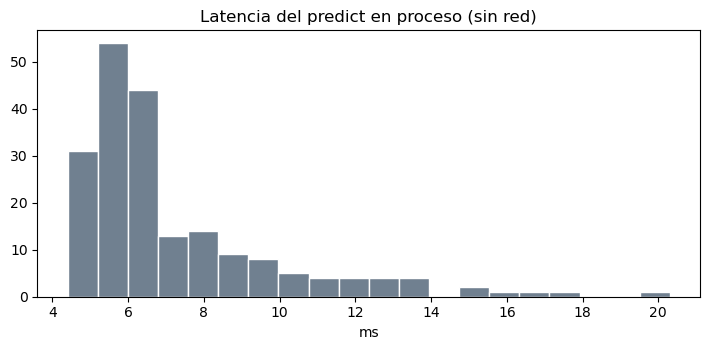
Estimación puntual, error estándar, intervalos de confianza, pruebas de hipótesis, errores tipo I y II, p-value y un caso A/B de latencia.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 10. Enfoques frecuentista y bayesiano

Máxima verosimilitud, MAP, posterior, evidencia, la diferencia entre el marco frecuentista y el bayesiano, y un caso de suavizado en clasificación.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 11. Regresión lineal

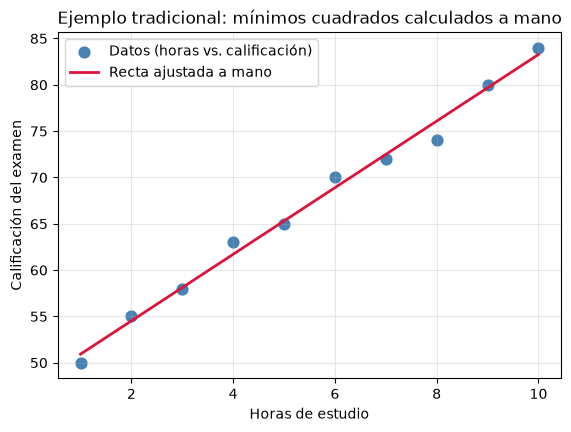
Modelo lineal simple, supuestos, mínimos cuadrados, MSE, interpretación de coeficientes y un caso de latencia frente a tamaño de lote.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 12. Clasificación y métricas de evaluación

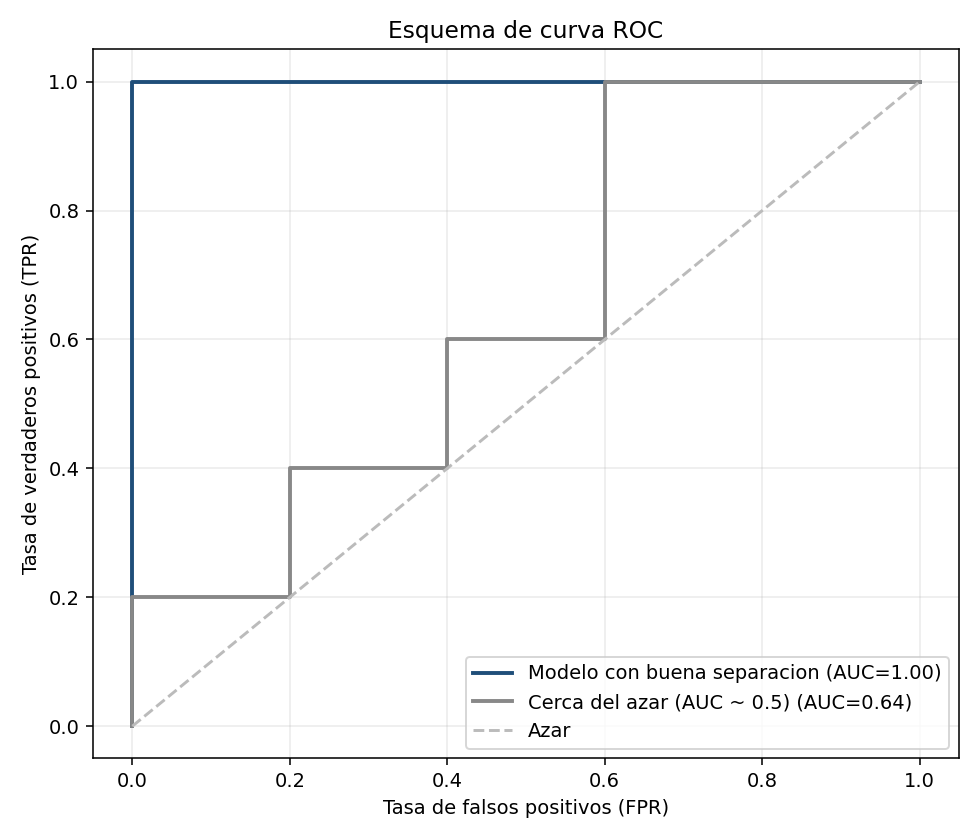
Clasificación binaria, matriz de confusión, exactitud, precisión, recall, F1, ROC, AUC, desbalance y un protocolo para decidir si el clasificador sirve.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 13. Validación y desempeño del modelo

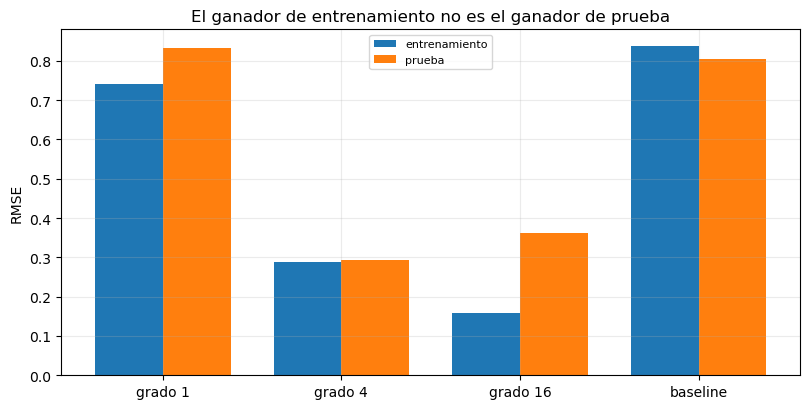
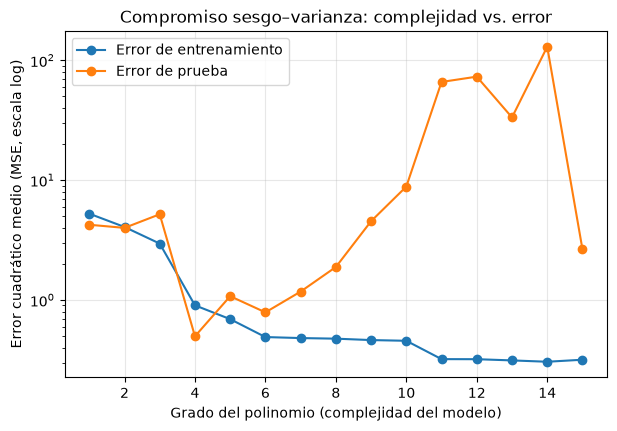
Sobreajuste, subajuste, sesgo-varianza, train/test, validación cruzada, bootstrap y un protocolo para decidir si un modelo es aceptable.

Wilder Ramírez Delgado
Sep 25, 2026

Estadística para IA — 14. Proyecto integrador final

EDA, correlación, modelo lineal, métricas, validación train/test y un veredicto escrito sobre si el modelo es aceptable.

Wilder Ramírez Delgado
Sep 25, 2026

Docker para Big Data: por qué “en mi máquina funciona” ya no es una excusa

Contenedores, imágenes, Docker Compose y un primer clúster de Spark, explicados desde los fundamentos con prácticas guiadas.

Wilder Ramírez Delgado
Sep 20, 2026

HDFS: el sistema de archivos distribuido de Big Data

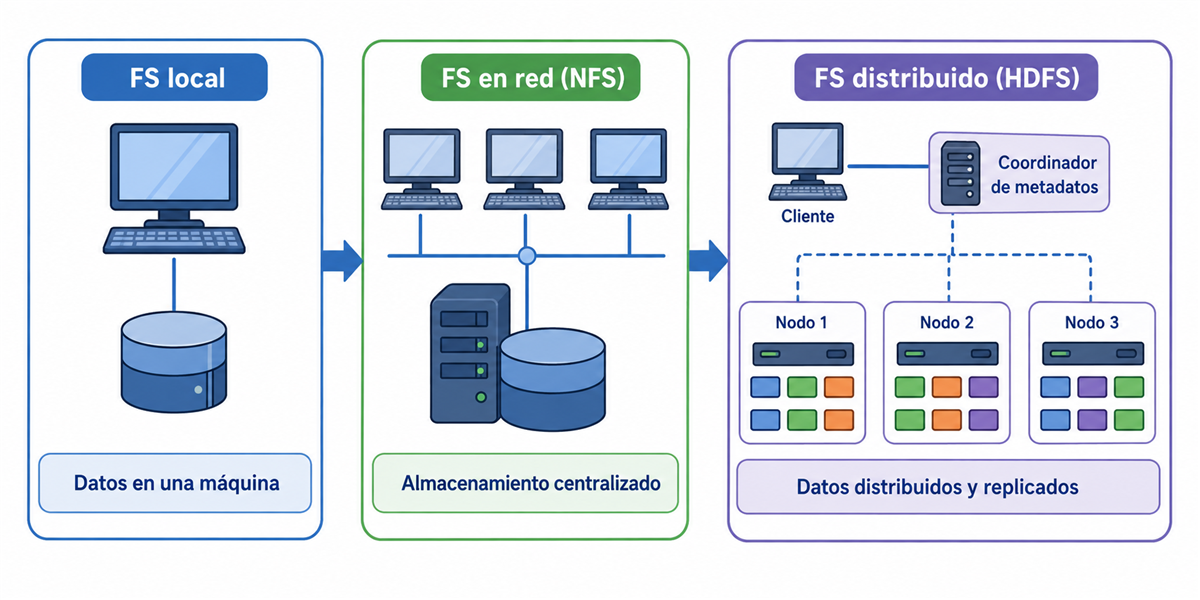
Qué es un sistema de archivos distribuido, la arquitectura de HDFS con NameNode y DataNodes, y sus flujos de lectura y escritura.

Wilder Ramírez Delgado
Sep 20, 2026

Laboratorio: HDFS con Docker, desde la instalación hasta las réplicas

Laboratorio guiado: levantar un NameNode y tres DataNodes con Docker, cargar archivos, observar bloques y réplicas, y comprobar la tolerancia a fallos.

Wilder Ramírez Delgado
Sep 20, 2026

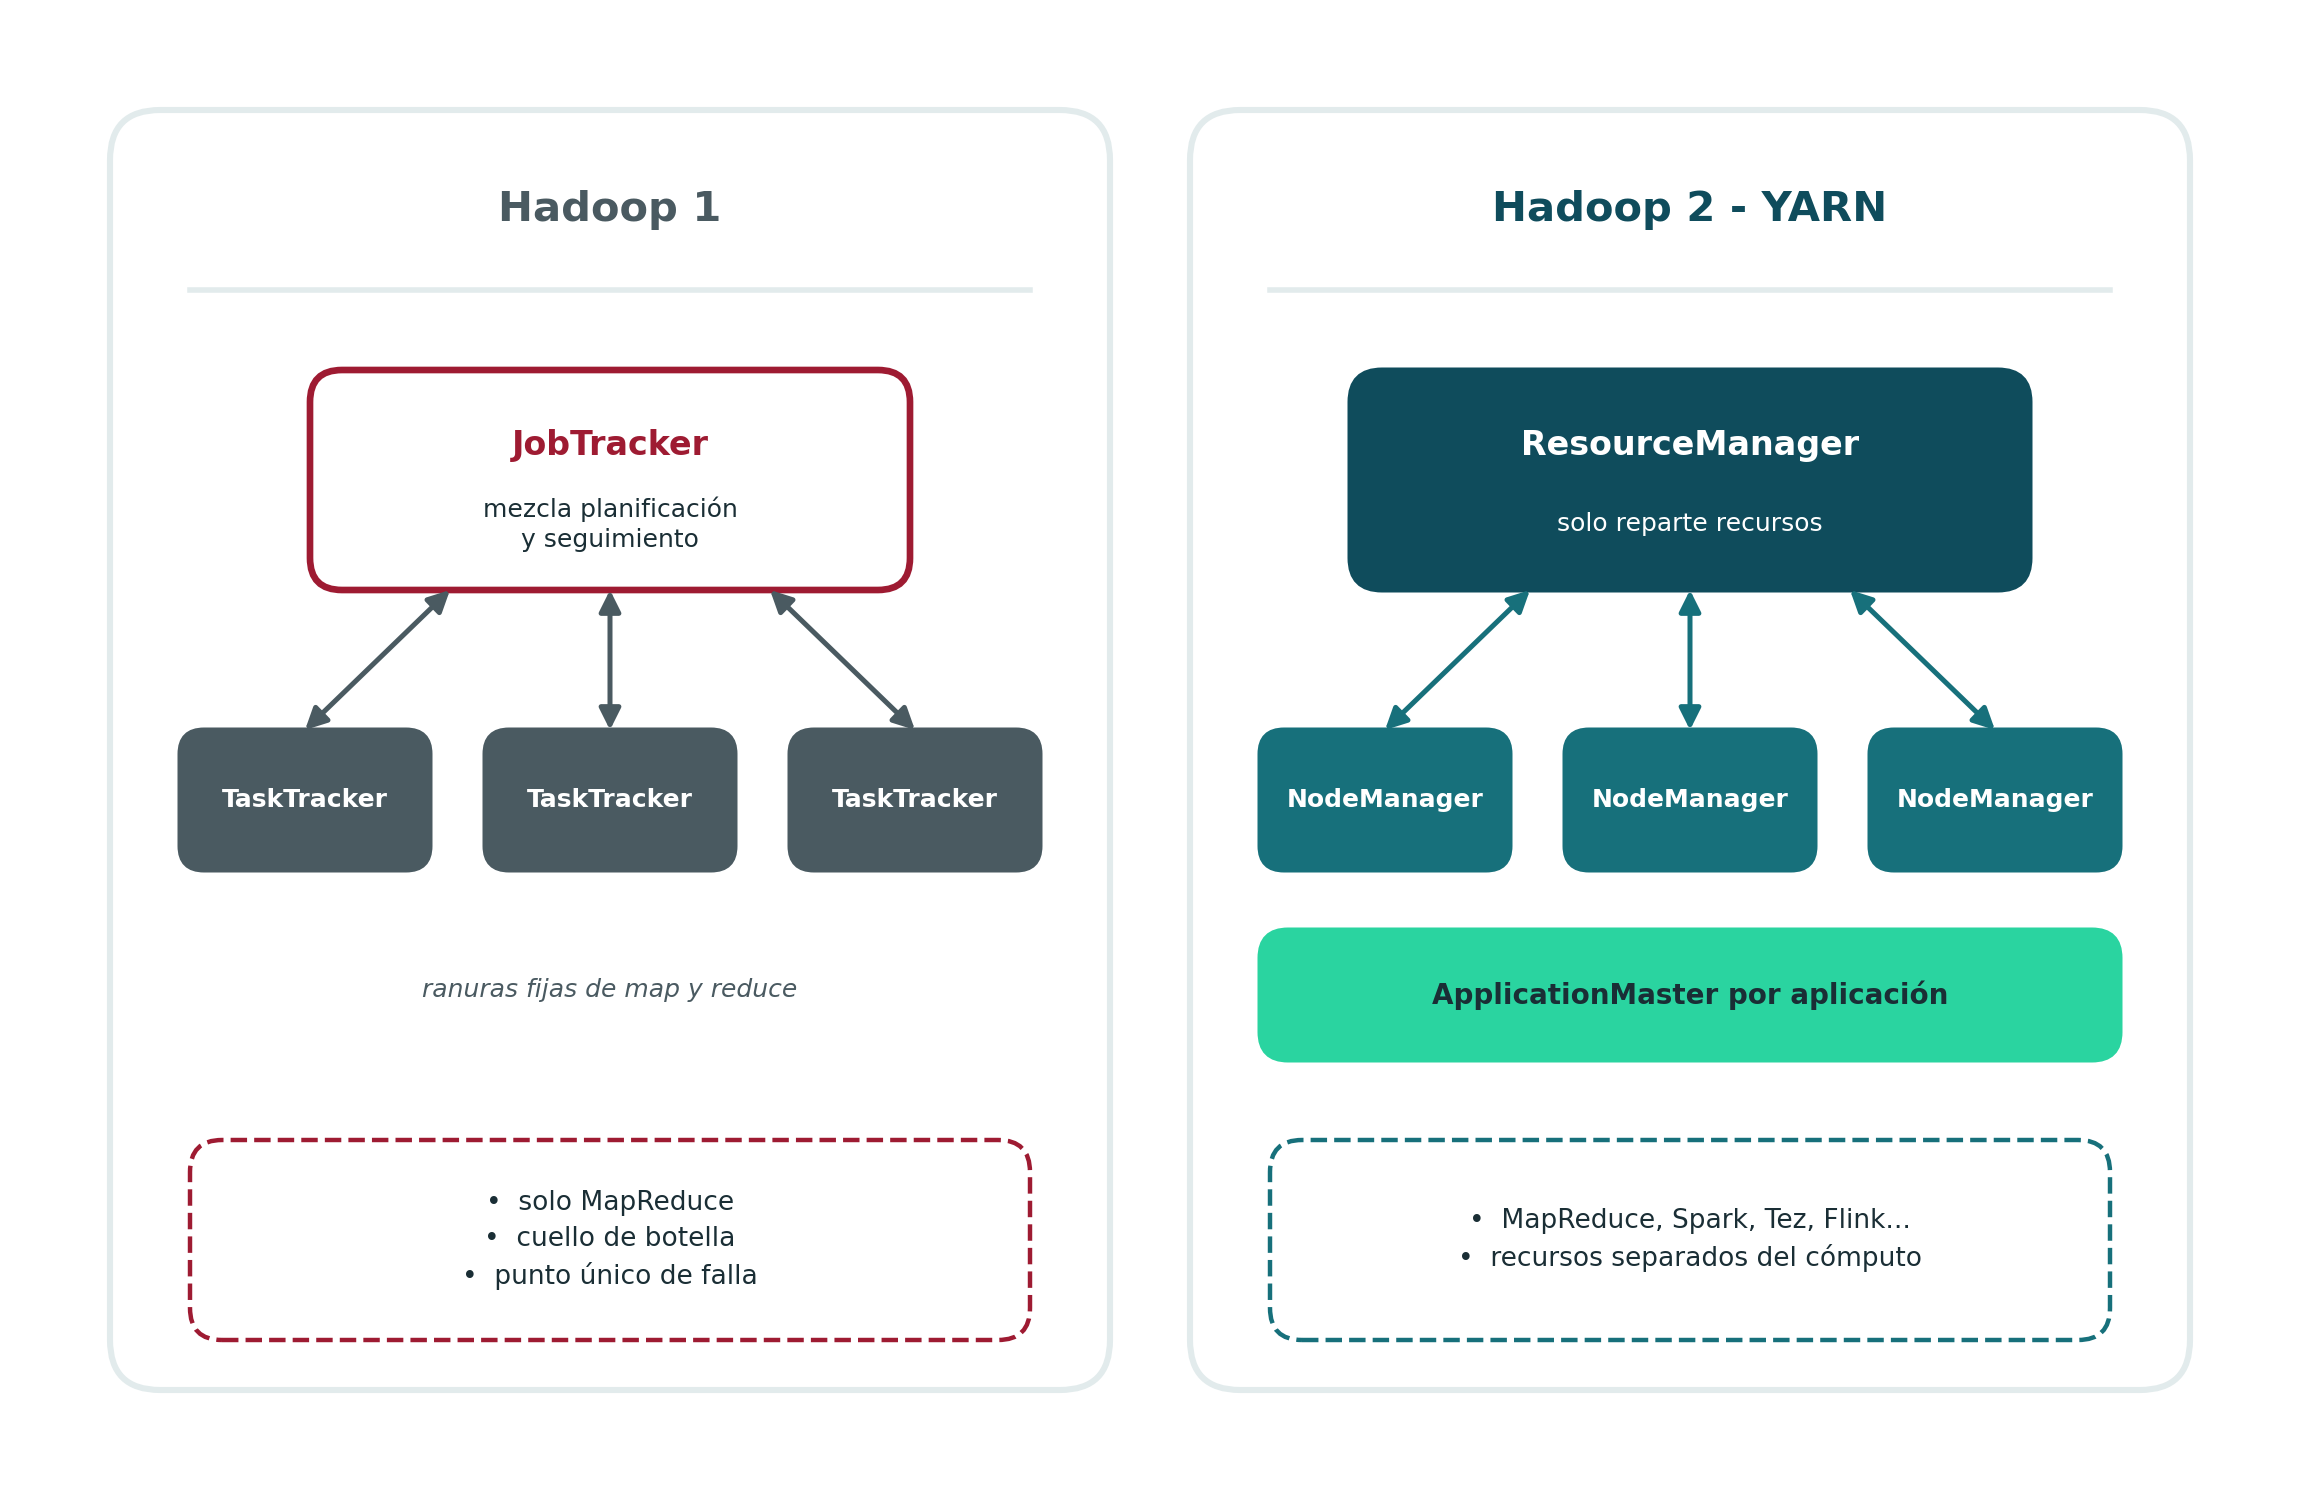
Hadoop 1 con JobTracker frente a Hadoop 2 con YARN

YARN: el gestor de recursos del clúster

Arquitectura de YARN —ResourceManager, NodeManager, ApplicationMaster y contenedores— y el ciclo completo de una aplicación en el clúster.

Wilder Ramírez Delgado
Sep 20, 2026

Laboratorio: YARN con Docker, del ResourceManager a tu primer trabajo MapReduce

Laboratorio guiado: levantar YARN sobre el clúster HDFS y ejecutar trabajos MapReduce reales, validado paso a paso con evidencia de ejecución.

Wilder Ramírez Delgado
Sep 20, 2026

Análisis Avanzado de Datos — 6. Métodos de suavización: splines

Regresión polinómica, el fenómeno de Runge, splines cúbicos y el rol de los knots, con selección de complejidad por validación cruzada k-fold, y una comparación final entre…

Wilder Ramírez Delgado
Sep 18, 2026

Estadística para IA — 1. Introducción al análisis de datos

Concepto de dato y variable, tipos de variables, población y muestra, y el rol de la estadística en la IA.

Wilder Ramírez Delgado
Sep 18, 2026

Estadística para IA — 2. Medidas de tendencia central

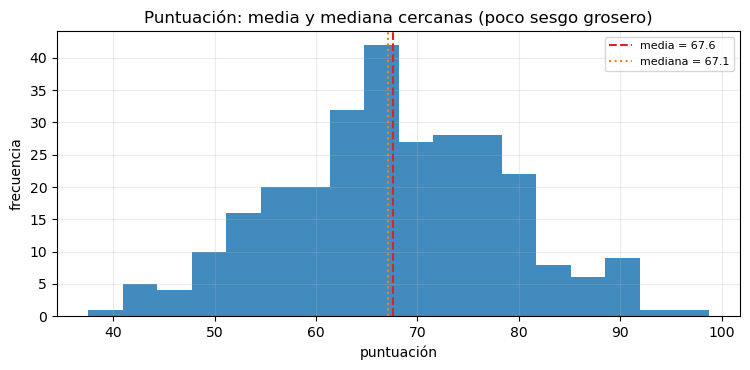
Media, mediana, moda, sensibilidad a valores atípicos, media recortada y ponderada, e interpretación del centro de un conjunto de datos, con su efecto en la imputación y en…

Wilder Ramírez Delgado
Sep 18, 2026

Estadística para IA — 3. Variabilidad y dispersión

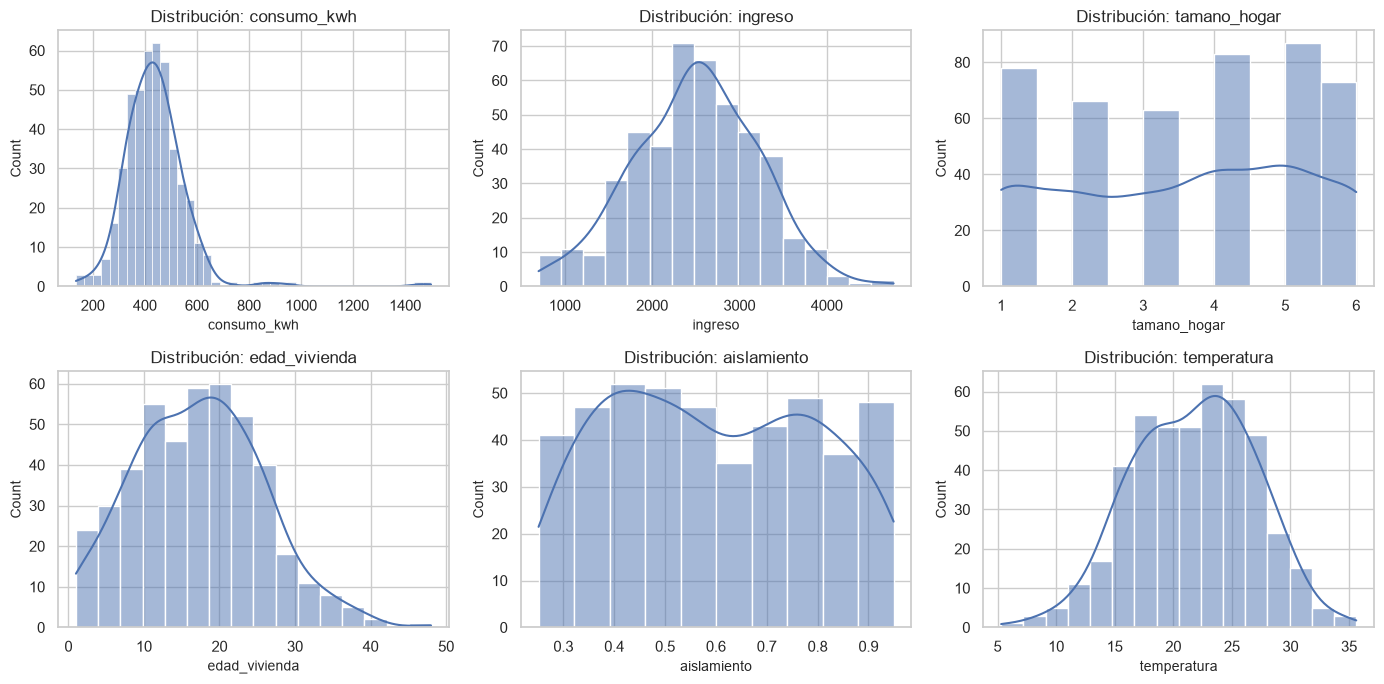
Rango, varianza, desviación estándar y coeficiente de variación aplicados, con su efecto sobre la estabilidad de un modelo, incluyendo un caso real de validación de datos.

Wilder Ramírez Delgado
Sep 18, 2026

Estadística para IA — 4. Distribuciones y forma de los datos

Distribuciones discretas y continuas, normal, asimetría, curtosis y detección de anomalías.

Wilder Ramírez Delgado
Sep 18, 2026

Estadística para IA — 5. Relación entre variables

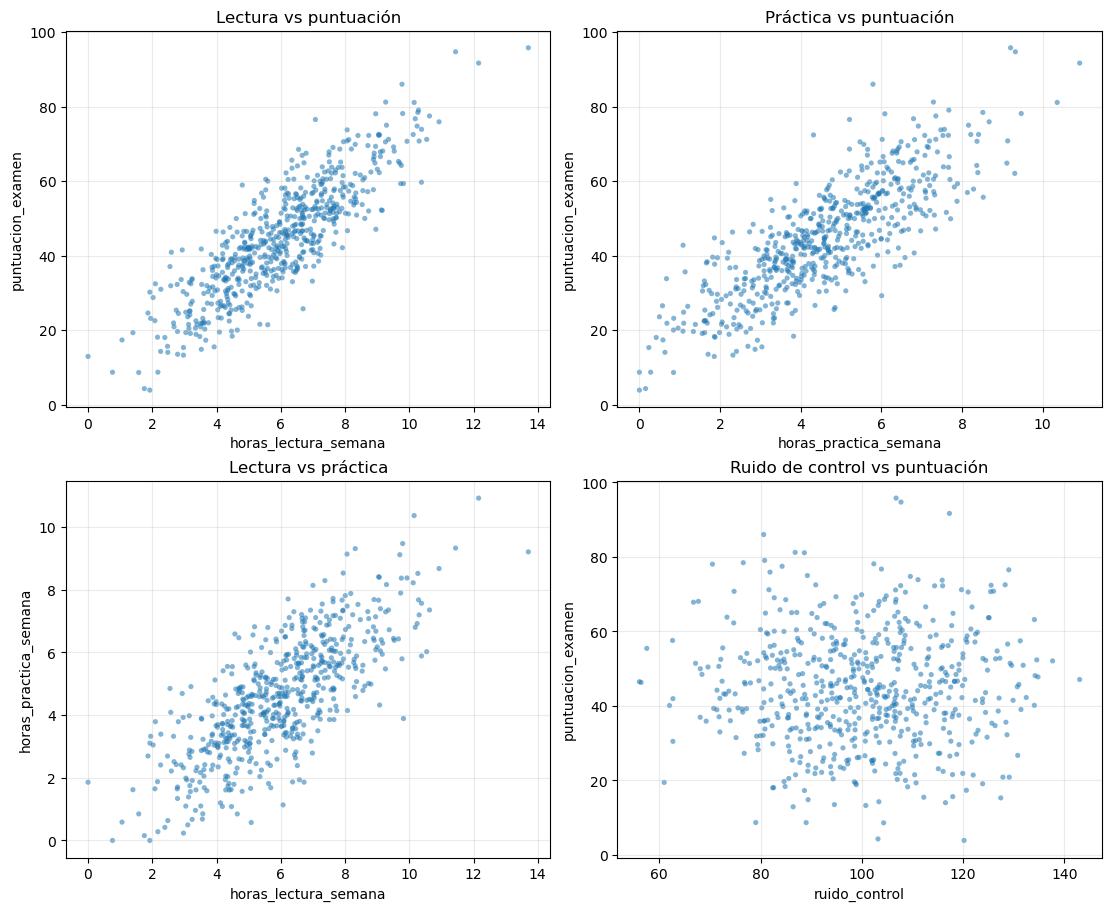
Covarianza, correlación de Pearson, matriz de correlación, multicolinealidad y la diferencia entre correlación y causalidad.

Wilder Ramírez Delgado
Sep 18, 2026
 
Arquitectura integral de IA y MLOps

Un modelo en un notebook no es un sistema. Mapa del ciclo de vida, pipelines de dato y de modelo, monolito frente a servicios, y el corte batch frente a online.

Wilder Ramírez Delgado
Sep 12, 2026
 
Fundamentos de ETL para datos de producción

Extracción, transformación estructural y carga como contrato: fuentes, marca de agua, esquema, modos de load y linaje. La calidad profunda queda para la sesión 3.

Wilder Ramírez Delgado
Sep 12, 2026
 
Calidad del dato: limpieza, nulos y valores atípicos

Dimensiones de calidad, MCAR/MAR/MNAR, imputación con frontera train/test, outliers y un reporte que decide si la foto merece entrenarse.

Wilder Ramírez Delgado
Sep 12, 2026

Pipelines reproducibles de Machine Learning

El pipeline como contrato de ejecución: frontera de información, misma ruta de inferencia, serialización con joblib y trazabilidad mínima de una corrida.

Wilder Ramírez Delgado
Sep 12, 2026

Automatización del entrenamiento de modelos

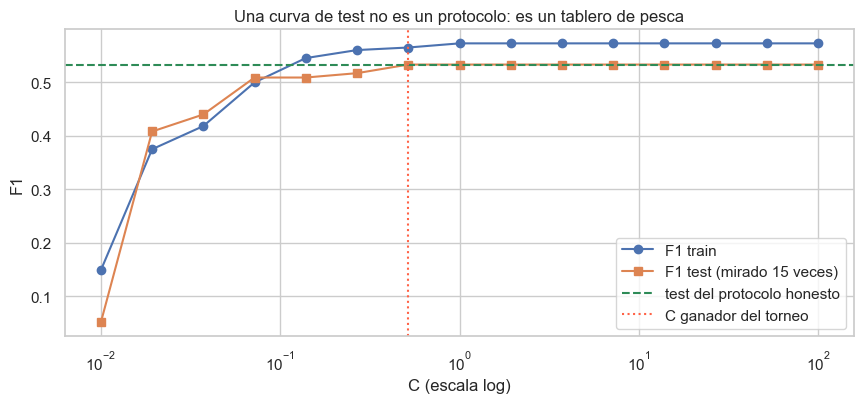
El maleficio del ganador: por qué buscar hiperparámetros mirando el test produce un F1 que no existe. Protocolo honesto de estimación, CV, grilla y persistencia.

Wilder Ramírez Delgado
Sep 12, 2026

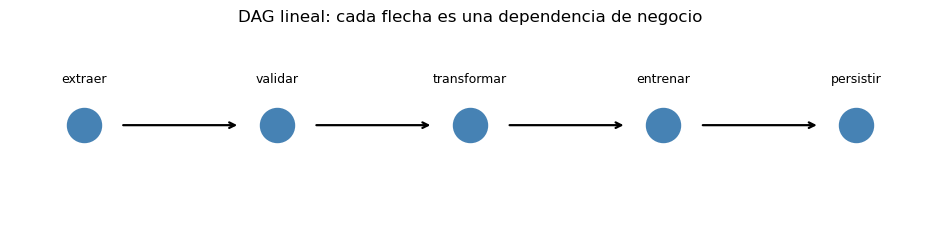
Orquestación de workflows en IA

DAGs, orden topológico, fallos, reintentos e idempotencia: el entrenamiento de la sesión 6 pasa a ser un nodo, no un notebook.

Wilder Ramírez Delgado
Sep 12, 2026

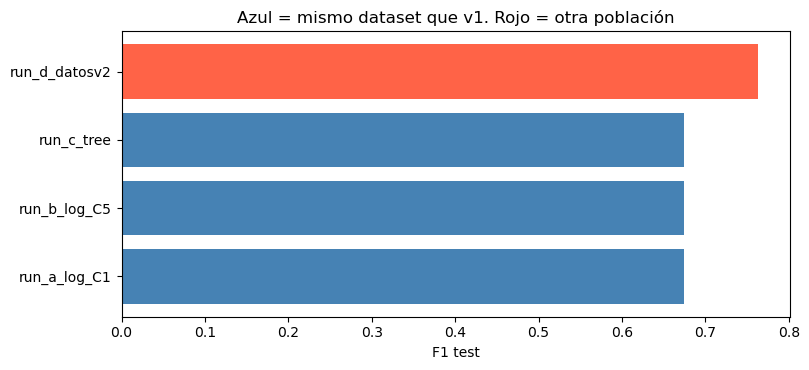
Versionamiento y gestión de experimentos

Datos + procedimiento + artefacto con nombre: hash, registro de corridas, comparación y promoción a un registry conceptual.

Wilder Ramírez Delgado
Sep 12, 2026

Despliegue de modelos como servicios

De artefacto a contrato HTTP: cliente-servidor, esquema, códigos de estado, carga única del pipeline y simulación de FastAPI.

Wilder Ramírez Delgado
Sep 12, 2026
 
Contenerización y portabilidad

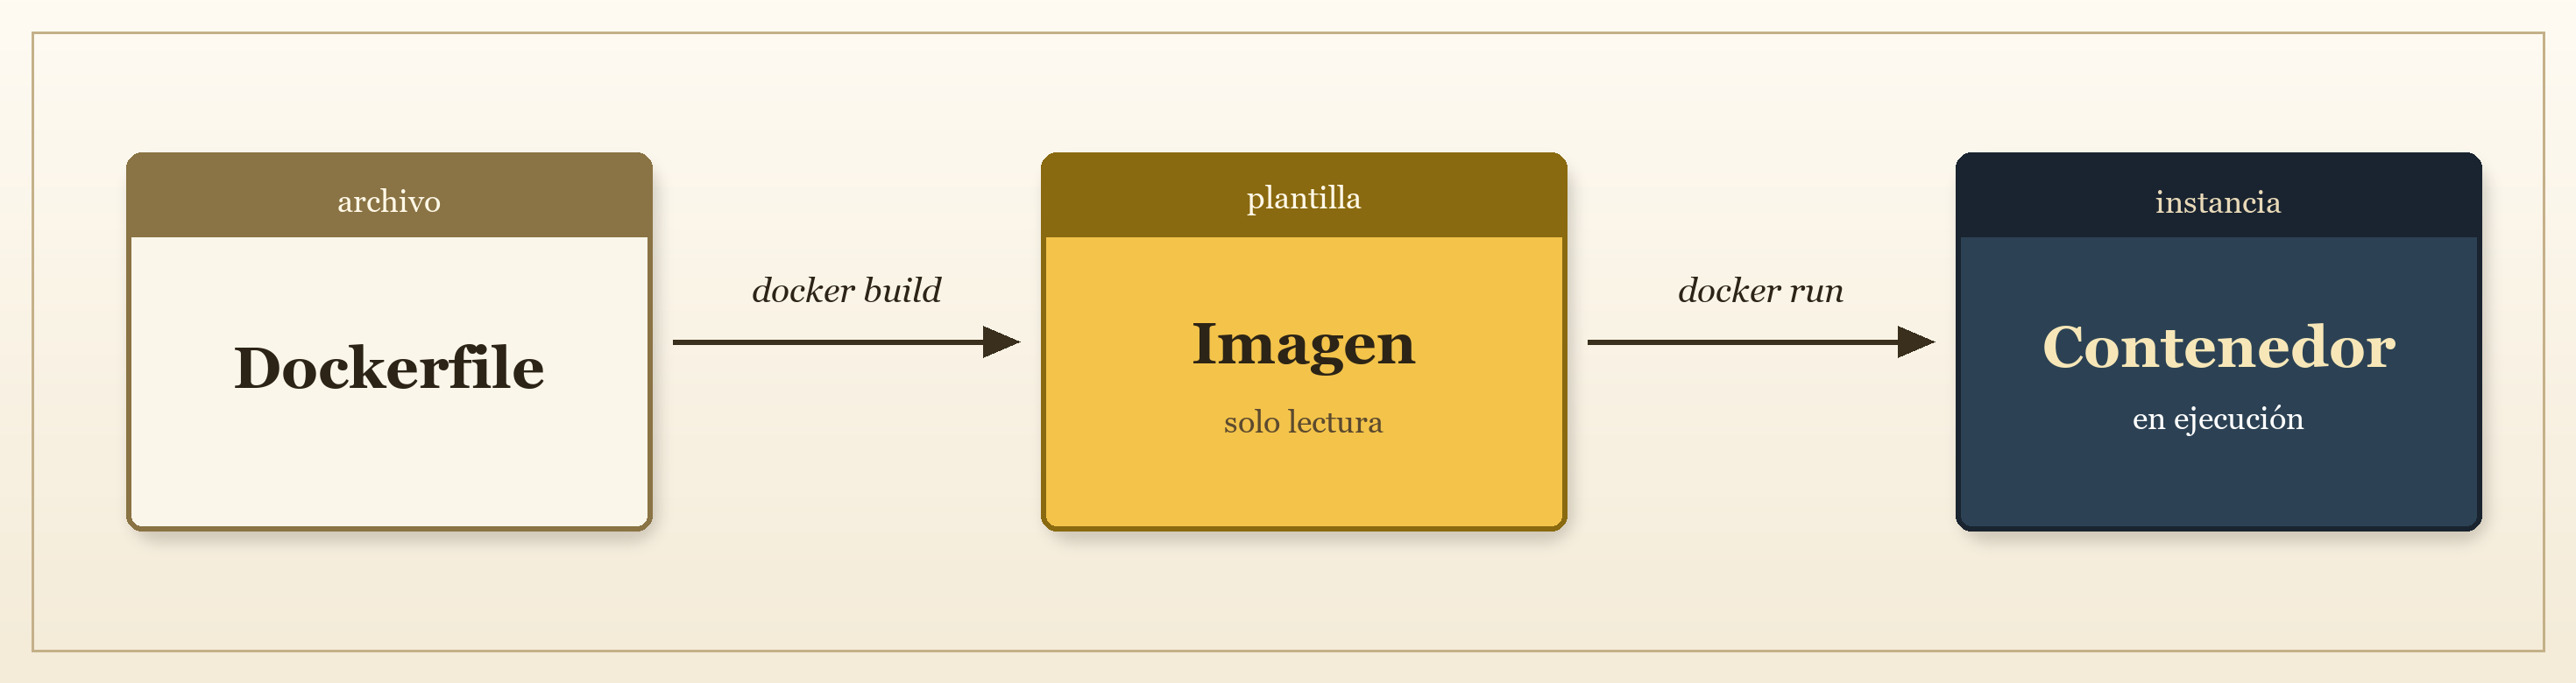
El problema ‘en mi máquina sí corre’: entornos, imágenes, lockfiles y un Dockerfile como receta de inferencia.

Wilder Ramírez Delgado
Sep 12, 2026
 
CI/CD aplicado a Machine Learning

Quién pulsa el botón: etapas de CI, pruebas del contrato, gate de métrica y promoción automática conceptual.

Wilder Ramírez Delgado
Sep 12, 2026

Monitoreo y estabilidad en producción

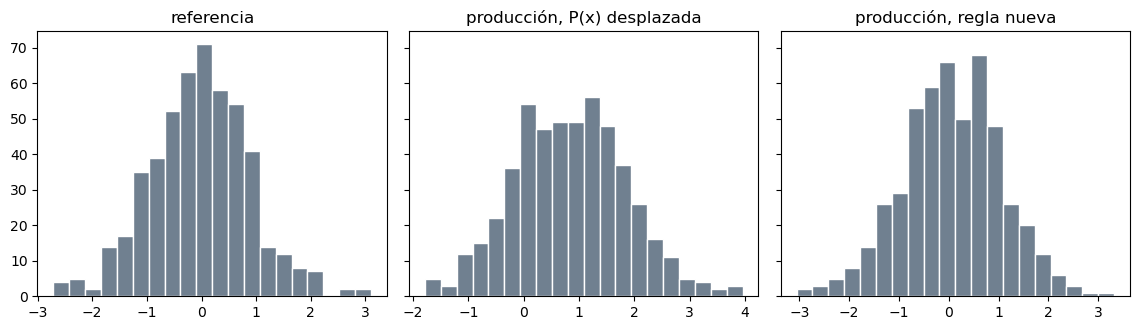
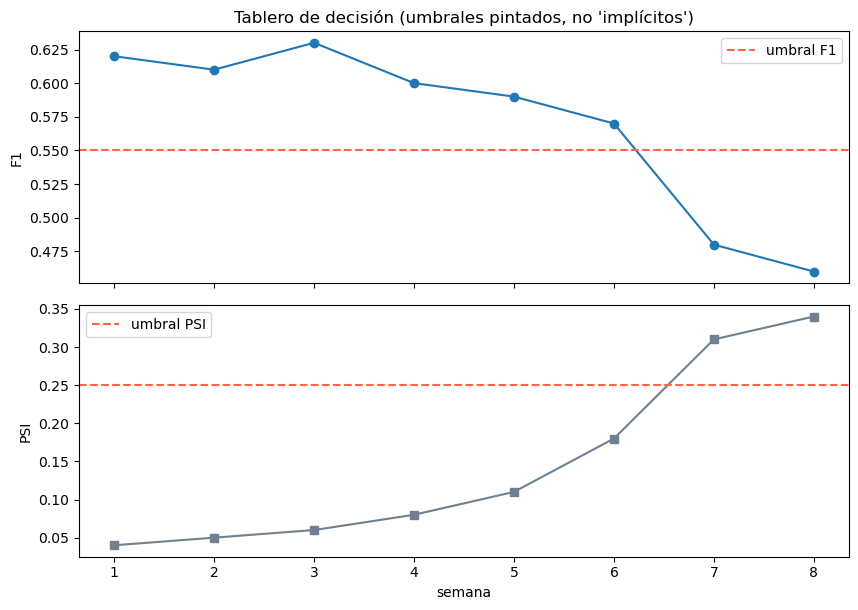
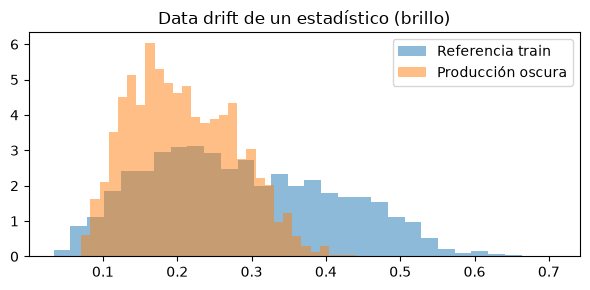
Data drift, concept drift y model drift: PSI, lotes con etiqueta tardía y una serie temporal de F1.

Wilder Ramírez Delgado
Sep 12, 2026

Interpretabilidad y transparencia en IA

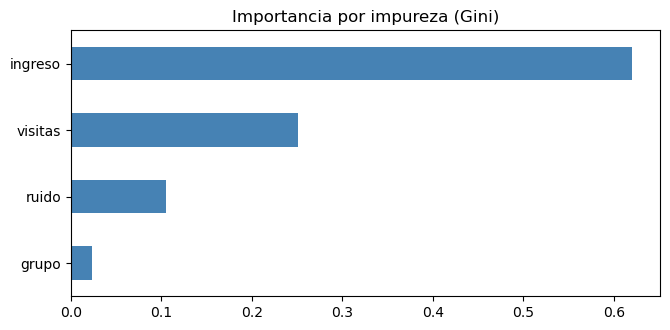
Importancia global, permutación, SHAP lineal y una mirada mínima a equidad y gobernanza.

Wilder Ramírez Delgado
Sep 12, 2026

Comunicación técnica de sistemas inteligentes

Del F1 a una acción: tablero, semáforo, riesgos por audiencia y un reporte Markdown generado por código.

Wilder Ramírez Delgado
Sep 12, 2026

Despliegue de modelos y MLOps

Serialización, inferencia, APIs, monitoreo, drift y fundamentos de MLOps.

Wilder Ramírez Delgado
Sep 11, 2026

Optimización avanzada y entrenamiento en GPU

Batch, dispositivo y búsqueda de hiperparámetros: el acta incluye tiempo, val_loss y no solo accuracy.

Wilder Ramírez Delgado
Sep 10, 2026

Redes Generativas Adversarias (GANs)

GAN mínima en dígitos y moda: lectura de pérdidas D/G y de diversidad de muestras.

Wilder Ramírez Delgado
Sep 9, 2026

Análisis Avanzado de Datos — 4. Evaluación de modelos y bootstrap

Métricas de rendimiento fuera de la muestra y remuestreo bootstrap para cuantificar la incertidumbre de las estimaciones, con ejemplos ejecutables en Python.

Wilder Ramírez Delgado
Sep 8, 2026

Análisis Avanzado de Datos — 5. Validación cruzada k-fold

Complemento de evaluación: validación cruzada k-fold paso a paso, particiones, elección de k e interpretación en regresión lineal, con gráficos de diagnóstico.

Wilder Ramírez Delgado
Sep 8, 2026

Transformers y modelos de lenguaje

Atención, encoder mínimo y lectura de curvas frente a una LSTM en clasificación de texto.

Wilder Ramírez Delgado
Sep 8, 2026
 
¿Por qué Linux domina el mundo del Big Data?

Fundamentos de Linux, terminal Bash y preparación de Ubuntu en WSL2 para trabajar con infraestructura de Big Data.

Wilder Ramírez Delgado
Sep 8, 2026

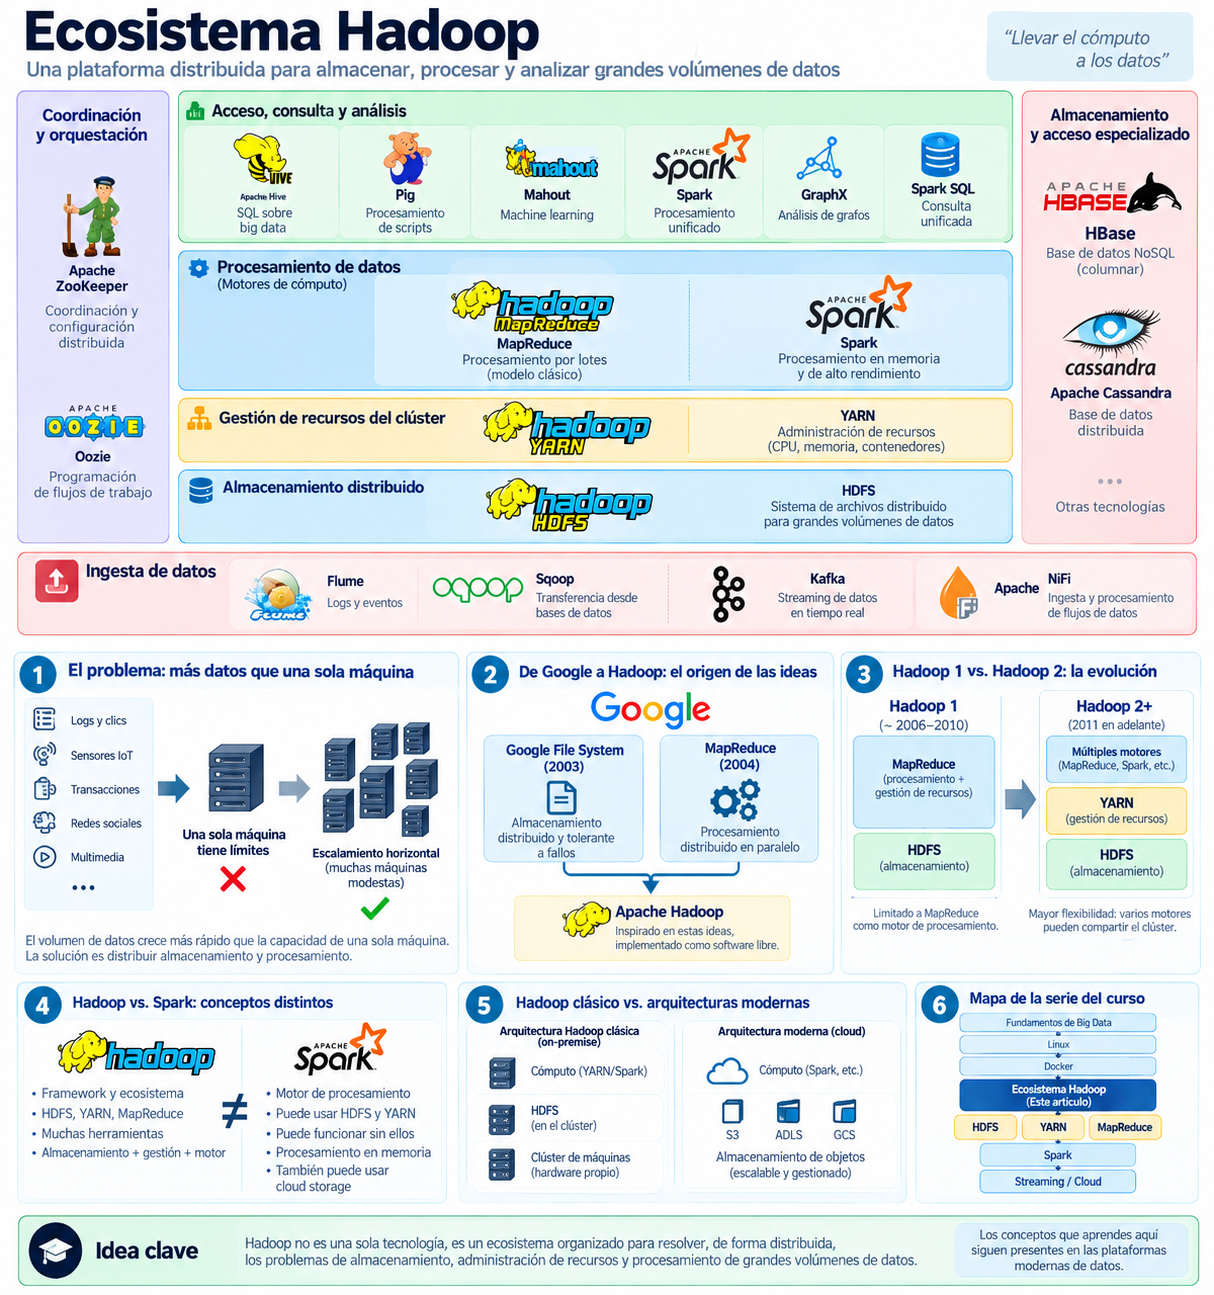
Ecosistema Hadoop: el mapa de una plataforma Big Data

Cómo encajan HDFS, YARN, MapReduce, Spark y las herramientas del ecosistema Hadoop en una arquitectura de datos distribuida.

Wilder Ramírez Delgado
Sep 8, 2026

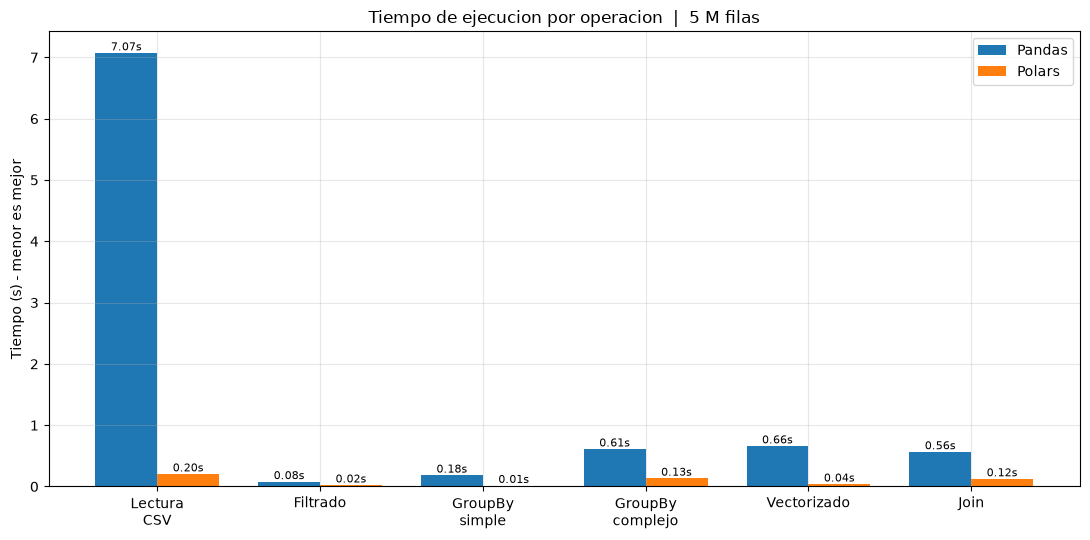
Pandas vs Polars: de la ingeniería de datos clásica a los motores analíticos modernos

Comparación práctica entre Pandas y Polars para entender rendimiento, memoria y escalabilidad en flujos de datos.

Wilder Ramírez Delgado
Sep 8, 2026
 
Calidad del dato en producción

Gobernanza, monitoreo y problemas operativos que afectan la calidad de los datos cuando un pipeline está en producción.

Wilder Ramírez Delgado
Sep 8, 2026

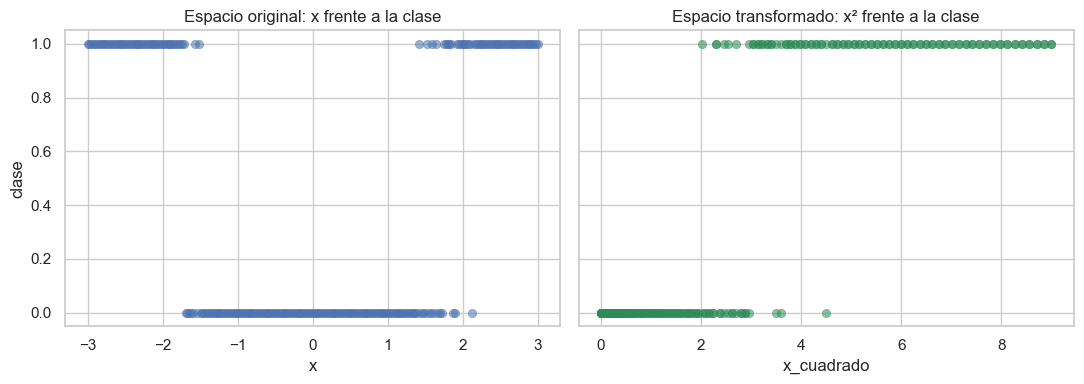
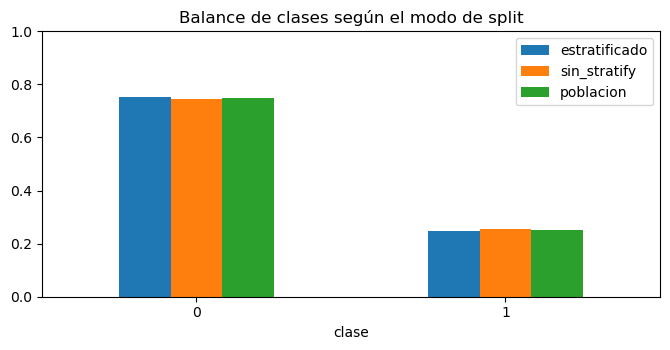
Feature Engineering y transformaciones

Diseño de la representación de entrada: transformaciones numéricas, encoding, escalamiento y selección, con criterio estadístico y de modelado.
Wilder Ramírez Delgado
Sep 8, 2026

LSTM y GRU aplicadas

Puertas LSTM/GRU y comparación con RNN leyendo curvas y accuracy de dependencia larga.

Wilder Ramírez Delgado
Sep 7, 2026

Redes Recurrentes (RNN)

Secuencias, estado oculto y lectura de curvas en predicción temporal y texto.
Wilder Ramírez Delgado
Sep 6, 2026

Evaluación avanzada en visión artificial

Augmentation, errores, heatmaps y robustez: lectura de curvas y reportes en visión.
Wilder Ramírez Delgado
Sep 5, 2026

Transfer Learning y arquitecturas modernas

CNN desde cero, MobileNetV2 congelada y fine-tuning: lectura de curvas, reportes y decisión.

Wilder Ramírez Delgado
Sep 4, 2026

Clasificación de dígitos manuscritos (MNIST) con CNN

Aplicación complementaria de la sesión 6: entrenamiento, evaluación, guardado del modelo e inferencia.

Wilder Ramírez Delgado
Sep 3, 2026

Fundamentos de Redes Convolucionales (CNN)

Convoluciones, filtros, pooling, mapas de activación y comparación entre CNN y MLP.

Wilder Ramírez Delgado
Sep 2, 2026

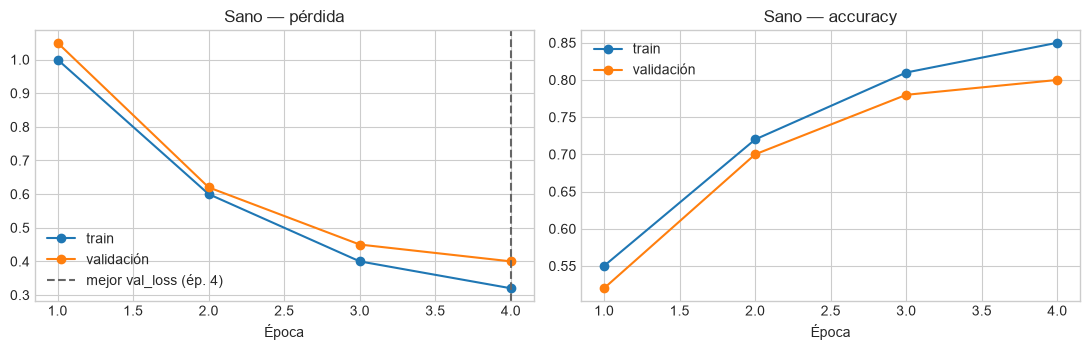
Técnicas para mejorar la generalización

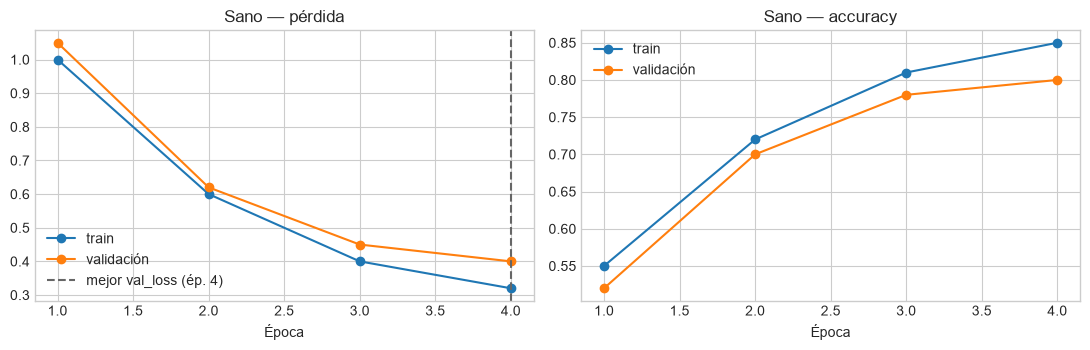
L1, L2, Dropout, Batch Normalization, Early Stopping y comparación de hiperparámetros.

Wilder Ramírez Delgado
Sep 1, 2026

Perceptrón y MLP: de la neurona simple a las redes multicapa

Implementación del perceptrón desde cero, compuertas lógicas y el problema XOR, resuelto con un Perceptrón Multicapa (MLP) aplicado a Iris, dígitos escritos a mano y…

Wilder Ramírez Delgado
Aug 31, 2026

Evaluación de modelos: predicción, clasificación y desempeño

Métricas para evaluar modelos supervisados fuera de la muestra: MAE, MAPE y RMSE en regresión; matriz de confusión, F1 y AUC-ROC en clasificación.

Wilder Ramírez Delgado
Aug 30, 2026
 
Introducción al Deep Learning y fundamentos matemáticos

Evolución de Machine Learning a Deep Learning, aplicaciones y representación de datos con vectores y matrices en NumPy.

Wilder Ramírez Delgado
Aug 29, 2026

Redes multicapa (MLP), pérdida y backpropagation

Funciones de activación y pérdida, descenso de gradiente, backpropagation y entrenamiento de una MLP desde cero con NumPy.

Wilder Ramírez Delgado
Aug 29, 2026

Análisis Avanzado de Datos — 3. Regularización Ridge y Lasso

Regularización Ridge (L2) y Lasso (L1) paso a paso: por qué la regresión lineal se queda corta ante el sobreajuste y cómo equilibrar sesgo y varianza.

Wilder Ramírez Delgado
Aug 28, 2026

Análisis Avanzado de Datos — 2. Regresión lineal múltiple

Regresión lineal con varios predictores: supuestos, multicolinealidad y VIF, cuándo regularizar y cómo diagnosticar los residuos paso a paso.

Wilder Ramírez Delgado
Aug 27, 2026

Análisis Avanzado de Datos — 1. Introducción y repaso de regresión lineal

Primer artículo de la serie: la regresión lineal simple a fondo, con fórmula cerrada, forma matricial, interpretación de coeficientes y residuales, y ejercicios en…

Wilder Ramírez Delgado
Aug 26, 2026
No matching items

    © 2026 BIT — Business Innovation Technology · Calle 147 No. 93-09, apto 503, Bogotá, Colombia
    Autor: Wilder Ramírez Delgado · info@biitt.com